推荐算法日报 · 2026-09-24
总览
今天这批论文一眼扫过去几乎全是工业界的落地报告,学术味很淡但可读性反而高,百度、Meta、小红书、快手轮番讲自己线上是怎么改的,真正拿出新模型原语的几乎没有。主线其实就两条:一条是大厂召回排序架构的重构,代表是百度把召回排序合到一个模型里、以及 Meta 用 GPU 精选池加 CPU 大库存的「编排」思路;另一条是用多模态大模型去补冷启和语义短板,小红书造替身 ID、快手把用户口述理由做成排序特征都属这一路。最值得细读的是百度那篇统一检索排序和 Meta 那篇混合检索,前者顺手治了码本长尾、后者用候选重叠率把「深度和广度在吃不同候选」讲得很硬,而且两篇都是全量 A/B、坑也交代得比较老实,比刷榜文有东西可抄。小红书那篇里「复用 ranker 结构比多模态本身更值钱」那行消融也值得单独拎出来看,属于读完能改自己代码的那类信息。剩下几篇要带点警惕:长序列那篇多模态消融压倒性、层级压缩反而掉点,电商蒸馏那篇 94.95% 本质是在拟合自己造的伪标签,快手那篇正负向是分开跑的、没给联合效果,都别被漂亮的线上数字带跑。今天优先看百度和 Meta 这两篇,其次把小红书那篇的消融表翻一遍。
论文列表
1. MuSeR: Scalable Long-sequence Recommendation with Multi-interest Modeling
- 论文链接:AlphaXiv
- 更新时间:2026-09-20 14:36 UTC
- 机构:未披露机构
- 工业优先级:强
推荐系统终于敢看10万条历史了
各位算法同学们 💡 先抛个反差:工业推荐系统嘴上说要长序列,手上却只敢截最近几百条行为,因为线上 SLA 常卡在 300ms 以内。MuSeR 这次把 10^4 到 10^5 条用户行为真正塞进了百度 APP 的线上检索,而且它的价值不在新模型结构,在于「怎么让长序列跑得起来」这套系统级拼装。
📄 MuSeR: Scalable Long-sequence Recommendation with Multi-interest Modeling
🔧 分层时间压缩:最近行为全分辨率保留,中段 Pool16、早期 Pool64 逐级池化,把超长历史压到一个固定服务预算内,总有效长度变成可算的常数级别,Transformer 代价不再随长度膨胀。
🧩 多查询兴趣解耦:用 M 个可学习 query 从序列编码里解码出多个兴趣向量,配正交正则防止它们塌缩成同一个;训练时各兴趣向量负责预测不同未来行为,服务时按候选动态挑最相关的那个。
⚙️ 多模态对齐加工程化:ERNIE-4.0-Turbo 蒸馏文本摘要、BGE 语义向量补稀疏 ID;离线异步刷新用户表示、按 QPS 和负载自适应缓存,检索在 HNSW 上做分层 beam search,适配 CPU/GPU 混布集群。
📊 三个公开 benchmark 加一个大规模工业数据集上,Recall@K 一致优于强长序列和多兴趣 baseline。
📈 百度 APP 首页信息流、发现页、短视频三场景 A/B:DAU +0.26%,总时长 +0.89%,均 p<0.05。
✅ 线上同时把服务延迟和成本压低了,2025 年 8 月起全量部署。
🧠 我的判断:如果你在做长序列召回、已经被延迟和显存卡住,这篇的工程套路(异步刷新、分层池化、多查询解耦、beam 检索)比它的模型结构更有复用价值。坑在于论文没公开 Recall@K 的具体提升幅度和压缩策略的消融,复现前自己盯紧 Recall@K 与 P99 延迟的帕累托曲线;另外 +0.26% DAU 是超大流量大盘下的收益,中小流量场景别直接对标这个数。
2. UNIQUE: A Unified Retrieval and Ranking System for Large-Scale Feed Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-20 15:54 UTC
- 机构:Beihang University,Baidu Inc.,Hong Kong Institute of AI for Science, City University of Hong Kong
- 工业优先级:强
百度把召回和排序塞进同一个模型了
各位算法同学们,召回和排序合并成一个模型这件事,学术界喊了好几年,真敢在十亿级流量上全量跑 A/B、还把 P99 延迟一起公布出来的工业论文,其实没几篇。这篇 UNIQUE 就是其中之一,而且它的重点不在涨点,在怎么把两阶段的信息损失补回来。
📄 UNIQUE: A Unified Retrieval and Ranking System for Large-Scale Feed Recommendation
🔧 核心是 early fusion:用户历史 token、候选 item、候选 code 全部塞进同一个 Transformer 计算图,一次前向同时产出生成式召回的 code logits 和排序用的多目标分数。排序监督因此可以直接塑造共享的用户表示,而不是像级联那样靠候选列表传话。
🧩 量化上放弃 RQ-VAE 的多层残差,改成单层扁平 codebook,最近邻硬分配,从结构上消掉层级误差累积;量化处用 straight-through estimator 让梯度照常回传。
⚙️ codebook 不是拿 item 元信息直接学,而是先过一个 DSSM 多任务双塔,让 item 表征吃进 CTR、时长、完播这些后验反馈再做量化;外加一个平衡量化机制缓解码本被头部 item 占满的问题。
📊 线上 A/B:总观看时长 +0.96%,总分发量 +1.08%。
📈 新用户和高活跃用户这两类人群的涨幅明显高于大盘,论文专门点了出来。
✅ 服务端 P99 延迟 89 ms,在线推理 MFU 44.23%,这是它敢说 production-ready 的底气。
⚖️ 码本分析显示比层级量化的资源分配更均衡,这条对长尾和冷启动的判断价值,其实比那两个 +1% 更关键。
我的判断:如果你在做召排级联的工业推荐,且正被码本长尾偏斜、候选质量卡住排序上限这两件事折磨,这篇的工程细节比结论更值得抠。要盯的指标是长尾和冷启动的召回覆盖率、码本利用率,而不是只看大盘那 +1%。坑有两个:单层扁平量化对码本规模有多敏感,论文没展开,换到你的数据上得重扫;target-attention 那个交互切分对训练稳定性影响不小,结构别直接照搬。
3. IDProxy: CTR Prediction with Multimodal LLMs for Cold-Start Recommendation at Xiaohongshu
- 论文链接:AlphaXiv
- 更新时间:2026-09-21 07:22 UTC
- 机构:Xiaohongshu Inc.,Shanghai Jiao Tong University,Fudan University
- 工业优先级:强
- 备注:20th ACM Conference on Recommender Systems (RecSys 2026) - Industry Track Paper, Oral Presentation
新内容零交互,小红书让MLLM顶替ID
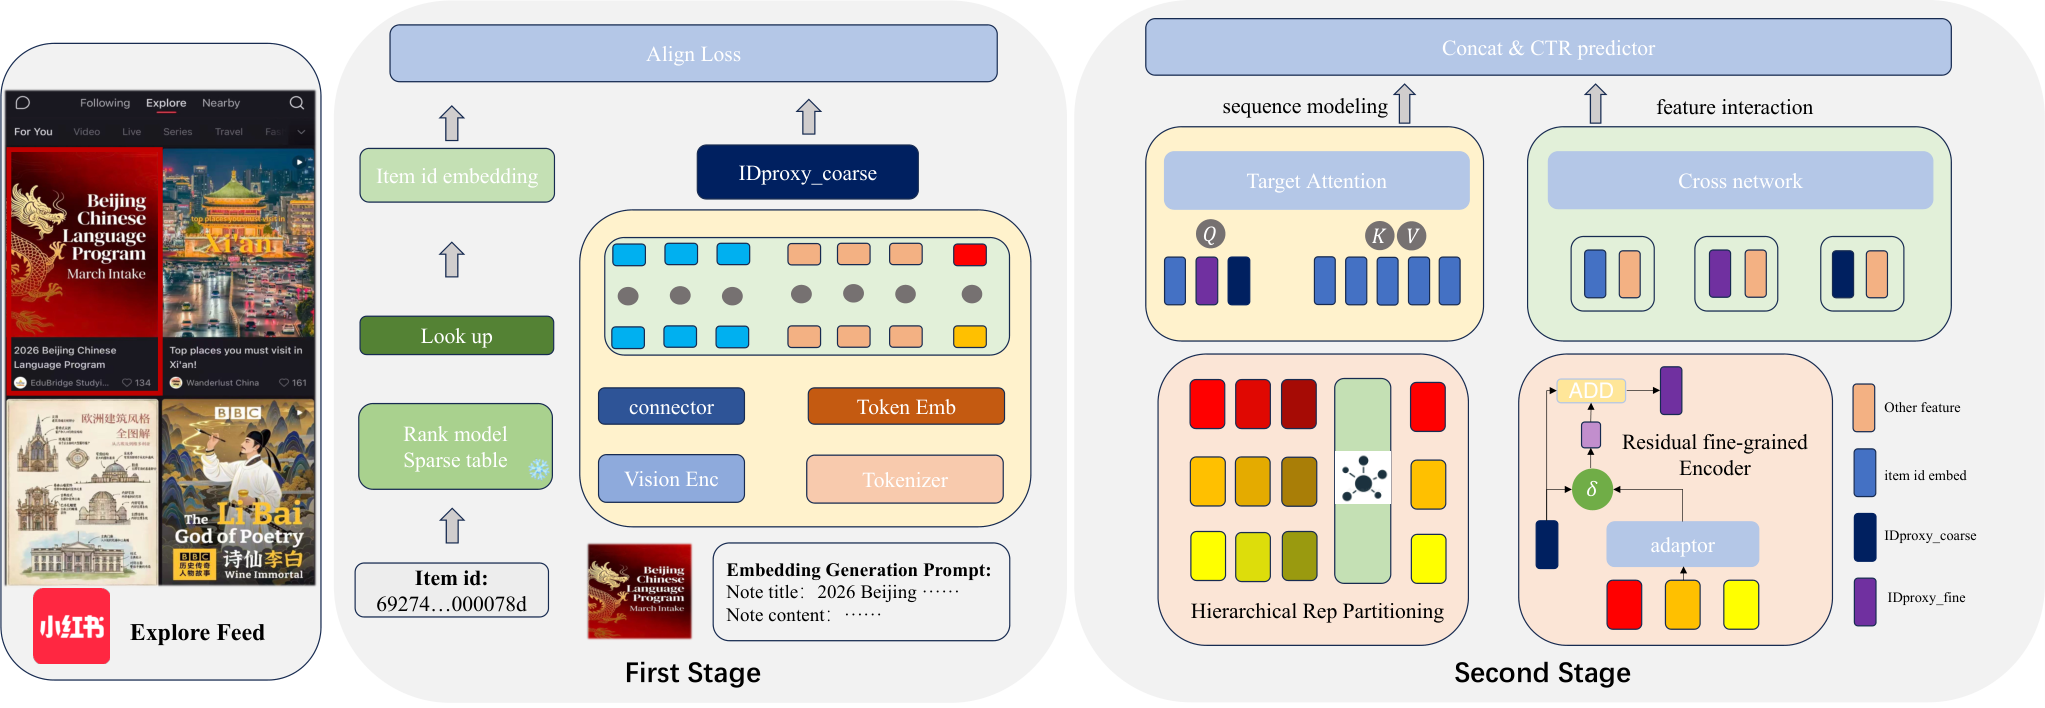
各位算法同学们,新 item 没有交互数据,CTR 模型基本等于瞎猜——小红书这篇的做法是:不给新 item 学 ID embedding,直接让多模态大模型按图文内容“现编”一个 proxy embedding 顶上。工业落地报告,不是实验室玩具。
📄 IDProxy: CTR Prediction with Multimodal LLMs for Cold-Start Recommendation at Xiaohongshu
🔧 用 MLLM 编码 item 的图文内容生成 proxy embedding,在没有行为数据时替代 ID embedding,直接塞进现有 CTR 排序模型。 🧩 Stage 1 用对比学习把内容表示拉进 ID 空间,先按频次阈值滤掉低频 item,再做 L2 归一化消掉热度带来的模长偏差。 ⚙️ Stage 2 取 MLLM 多个中间层 hidden states,k-means 聚成浅中深三组,轻量 adaptor 融合加残差门控,端到端跟 ranker 一起训,排序模型架构整个复用。
📊 论文用 t-SNE 对比指出:行为共现类方法学到的表示和 ID embedding 分布差得远,而 CB2CF、CLCRec 那类直接映射在 MovieLens 上看着行,工业 ID 是非聚类的不规则分布,冻结 encoder 或浅层 MLP 桥不过去。 📈 平台 3 亿+ 用户,item 持续上传还得立刻可分发,冷启动是日常不是边缘 case。 ✅ 2025 年已上线内容 Feed 和展示广告两个场景,每天覆盖数亿用户。 📉 离线实验和线上 A/B 论文都给了有效性结论,但正文截断,具体涨点百分比我这边没拿到,追完整版时重点看 Stage 2 的消融贡献。
对做工业推荐又被冷启动卡住的同学,这套“复用原 ranker + 端到端对齐”的工程思路比涨点本身更值得抄。要盯的指标是冷启 item 的 CTR 和曝光分布;坑在于 proxy 依赖 ID 空间稳定,线上 ID embedding 漂移时两阶段对齐得重跑。
4. Hybrid GPU-CPU Retrieval for Personalized Search at Ultra-Large Scale
- 论文链接:AlphaXiv
- 更新时间:2026-09-18 03:47 UTC
- 机构:Meta Platforms, Inc.
- 工业优先级:强
- 备注:10 pages, 5 figures, 9 tables. ACM sigconf format; submitted to the KDD 2027 Applied Data Science Track
GPU显存塞不下万亿库存,他们拆成两路
各位算法同学们,把全量库存塞进 GPU 显存这条路,Meta 自己承认走不通了。这篇把「个性化要深度、检索要广度」的矛盾拆成两条路并行跑,而且已经是线上系统。
📄 Hybrid GPU–CPU Retrieval for Personalized Search at Ultra-Large Scale
🔧 不换模型,换编排:两条路径各自选库存、各自发布版本、各自设 deadline,单条路能独立关掉回滚,候选最后在聚合层按 doc id 去重,再进共享排序器。
🧩 GPU 侧维护约十亿文档的池子,按「搜索价值」而不是热度筛,教程、本地指南这类低互动但高查询价值的内容会被保住;超过一年的内容只有不到 0.1% 进常青池。
⚙️ GPU 路径把两塔检索和 DeepFM 交互预排序联合训练,InfoNCE 加 Smooth L1 加 BCE 一起优化,候选离开 GPU 前就已打过交互分;CPU 路径用独立 embedding 索引加轻量个性化打分,库存约为 GPU 的二十倍。
📊 全系统 A/B 对比老的纯 CPU 配置,模型相关性打分和实质性互动都有提升,另给了保守的跨天依赖鲁棒 GSRR 区间。
📈 检索日志按来源归因显示,两条路径产出的候选在结构上确实不同,不是互相重复。
✅ 容量账算得硬:匹配的宽向量方案里,GPU 加速器年化成本约是 CPU 的 4 倍,把深度给 GPU、广度给 CPU 有经济依据。
总结:做十亿级以上检索或推荐的同学,这篇的价值在分工方式而不是模型结构。盯模型相关性打分和实质性互动,只看 ANN recall 会漏掉一半目标。落地坑在两套库存的版本对齐、去重接口和 GPU 池筛选策略——池子选错,深度再高也救不回来。
5. Scaling Articulated Rationales for MLLM-based Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-21 12:33 UTC
- 机构:未披露机构
- 工业优先级:强
🔍推荐模型开始读用户“为什么”
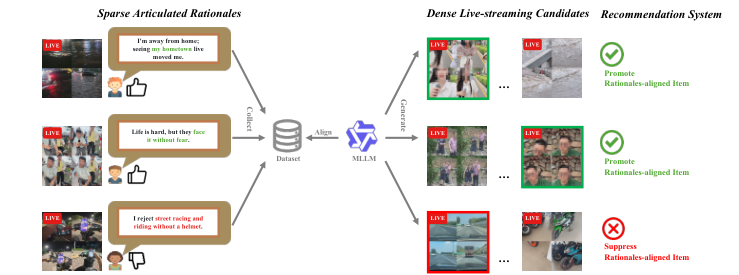
各位算法同学们,推荐系统最擅长学你点了什么,却几乎不学你为什么点。这篇快手 SARA 把问卷里的稀疏理由做成工业可用的排序特征:覆盖从 86,564 个作者扩到 10M 作者,线上还真的涨了 watch time、降了 Hate 反馈。
📄 Scaling Articulated Rationales for MLLM-based Recommendation
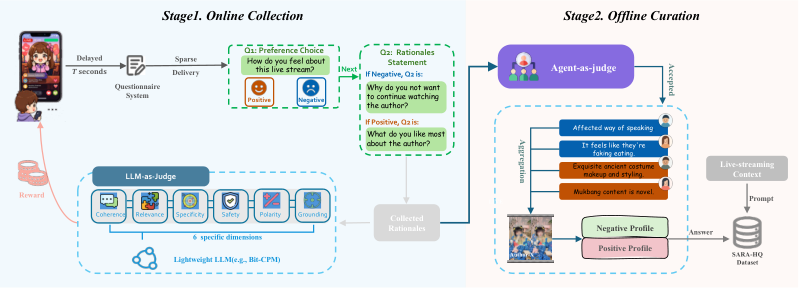
🔧 数据引擎先解决“理由太稀疏”:问卷延迟 10 秒触发、投递概率约 5% 动态调整,再用 LLM/Agent judge 筛质量,攒出 187,532 条 SARA-HQ。
🧩 对齐分两步:先用 SARA-HQ 做大规模 SFT,再用 Quality-Refining DPO 提质量,得到 SARA-7B,让理由生成从问卷覆盖的 86,564 位作者扩到全部 10M 作者。
⚙️ 理由不直接当文本塞模型,而是拆成正负两类特征:正理由进用户-作者交互建模,负理由进 negative-feedback history,用于跨语义相关作者泛化拒绝记忆。
📊 在未见作者上,SARA-7B 生成的 rationale 比通用 MLLM baseline 更 specific、relevant、grounded。
📈 多模态排序 baseline 上,正 rationale 集成让 watch time +0.99%。
✅ 负 rationale 集成让 Hate 反馈 -8.16%。
🕒 支持每日刷新,线上部署超过 30 天。
如果业务里有显式负反馈或问卷入口,这套“先收集再对齐再当特征”的路径可参考;要盯的是 rationale 质量评估器与排序特征的增益是否稳定,别只看生成文本像不像人话。坑在于问卷覆盖和用户疲劳,以及负理由跨作者泛化会不会误伤。
6. Distilling Lexical Product Associations into Deep Transformers: An Extreme Multi-Label Approach for Natural Language E-Commerce Search
- 论文链接:AlphaXiv
- 更新时间:2026-09-22 18:16 UTC
- 机构:未披露机构
- 工业优先级:未标注
- 备注:13 pages, 4 figures, 6 tables, preprint
🔍P@1 93%,小模型学会语义找货
各位算法同学们,54,000个商品、53,923个类,最后P@1能到93.15%,而“老师”只是个TF-IDF近邻图。这篇把电商搜索从词面匹配往语义蒸馏推了一步,还顺手修了老baseline的索引错位坑。
📄 Distilling Lexical Product Associations into Deep Transformers: An Extreme Multi-Label Approach for Natural Language E-Commerce Search
🔧 用TF-IDF余弦相似度取K=50近邻,生成物品-物品伪标签图,再蒸馏进DistilBERT,输出53,923类,标签密度只有0.093%,标签矩阵用CSR只占24.8MB。 🧩 评估严格自排除,把自己的类logit置-∞,不让模型召回自己,避免P@1虚高。 ⚙️ 修正TF-IDF相似矩阵与多标签二值化器的列索引错位;此前会出现P@1<0.1%的假基线,修完后TF-IDF teacher的P@1=98.10%。
📊 DistilBERT学生:P@1=93.15%、P@5=90.08%、NDCG@10=0.8845、MRR@10=0.9545。 📈 TF-IDF teacher上限:P@1=98.10%、NDCG@10=0.9419、MRR@10=0.9882,学生没超过,但把词面向量图的大部分拓扑学回来了。 ✅ 单卡T4约10小时收敛,BERT-base约34小时;十个自然语言查询原型里,情境、跨类、改写、否定约束这些词面模型失效的场景,学生能解出隐式意图。 ⚙️ 到百万商品规模,瓶颈在XMLC投影层内存,论文给了往双塔ANN的落地路线。
这套适合暂时没上ANN、又被BM25词面匹配卡住的检索团队,先拿它当语义蒸馏基线。看结果别只盯P@1,优先看跨类和否定约束query的P@5、NDCG@10;坑在teacher是TF-IDF,学生的上限被词面相似度框住,长尾意图能不能继续涨要看真实query分布。