小红书精读:MAREval: A Multi-Agent Framework for Evaluating Natural Language Recommendation Explanations
LLM评审团打分,方差压得住吗
各位算法同学们,同一句推荐理由丢给LLM评委跑两遍,给出两个分数——这种评估方差你们遇到过吧?这篇 NeurIPS 2025 Workshop 的工作就是给「LLM当评审」这件事加上结构和统计,让打分结果更接近人评。
📄 MAREval: A Multi-Agent Framework for Evaluating Natural Language Recommendation Explanations
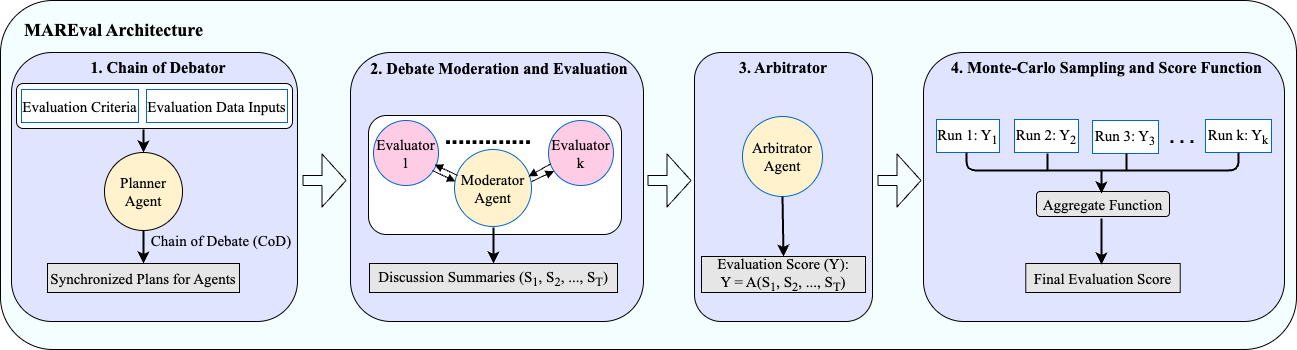
🔧 Chain of Debate:不让 agent 自由开聊,先由一个 planner 读完评估标准、上下文和整条流水线,统一生成各 agent 的分步计划,从源头上避免「各评各的」。
🧩 moderator agent:每轮把多个 evaluator 的输出压成摘要,只留共识点和分歧点,相当于给多轮辩论做了上下文压缩,专门对付 prompt drift 和重复啰嗦。
⚙️ arbitrator + 蒙特卡洛采样:辩论结果交给仲裁 agent 出最终判断,再独立跑 N 次整条流水线取均值(能拿到 token 概率的模型就直接算期望),把单次采样的运气成分摊掉。
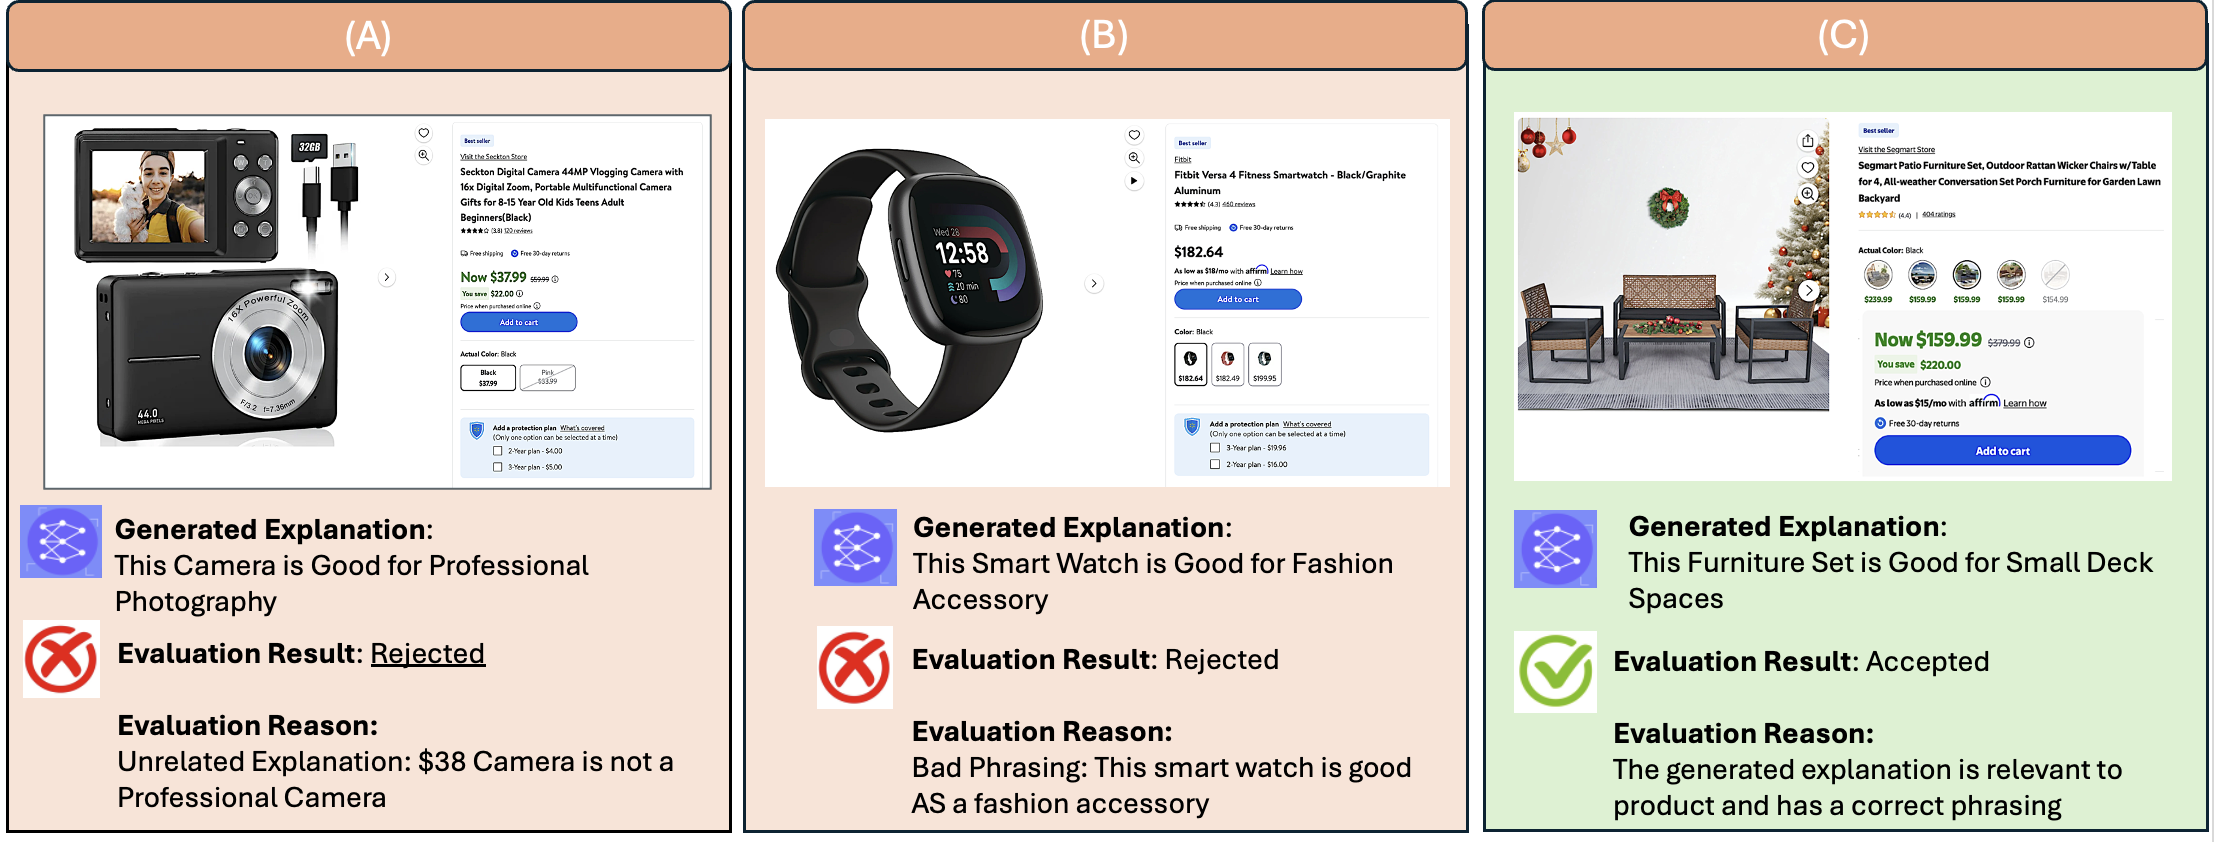
📊 在公开集 TopicalChat 和自建电商集(108 条推荐理由,按使用场景组织)上,与强单 agent、多 agent 基线相比,和人评的对齐度更高。
📈 稳定性分析里,重复试验的输出波动明显低于基线,这个指标对真上线的团队比准确率更实际。
✅ 大规模人工标注 gate 中,MAREval 达到了生产质量阈值,之前的方法没过线;线上 A/B 在互动和收入指标上拿到了统计显著提升。
总结:如果你在做推荐理由/解释质量的自动评估、又养不起标注团队,这套 planner+moderator+arbitrator 的分工值得照着搭。要盯的是三件事——和人评的相关性、重复跑的方差、以及换 prompt 写法后分数是否还稳。坑也明显:多 agent 加 N 次采样,调用成本是线性的,planner 自己又成了新的敏感点;另外摘要里只给了方向性结论,具体提升幅度在正文实验表里,复现前别直接照搬它的阈值。
原文:AlphaXiv