小红书精读:REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation
SID学不会物品关系?这篇补了三处
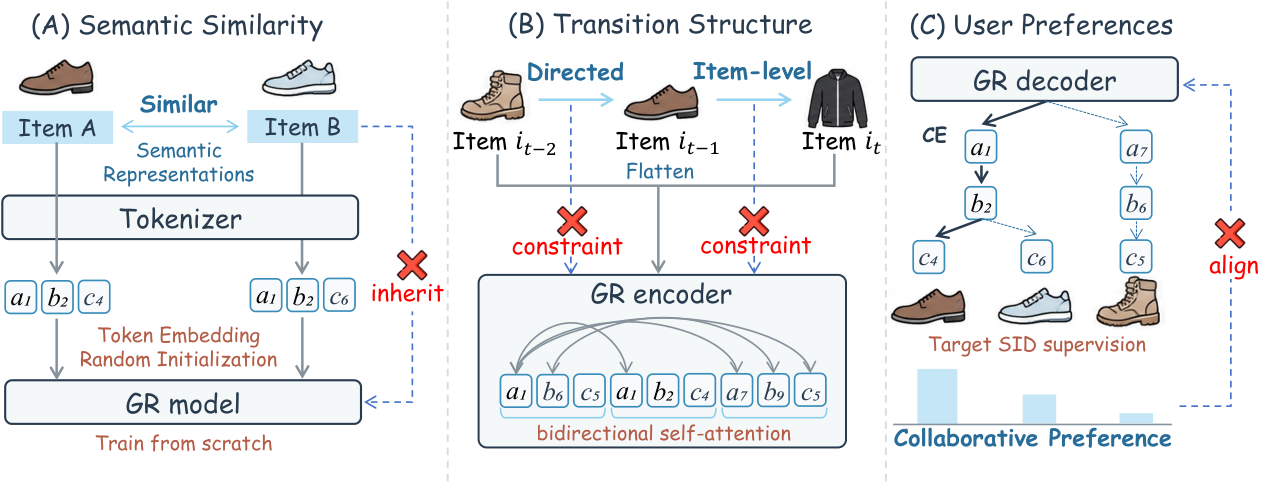
各位算法同学们,生成式推荐里有个被默认接受的事实:SID 的 token embedding 是随机初始化的,模型从零开始训,item 之间在连续空间里本来就有的语义关系,它压根没继承过。这篇 REGER 就是把“物品间关系”从隐式学习改成三处显式注入。
📄 REGER: Modeling inter-item Relations with Semantic IDs for Generative Recommendation
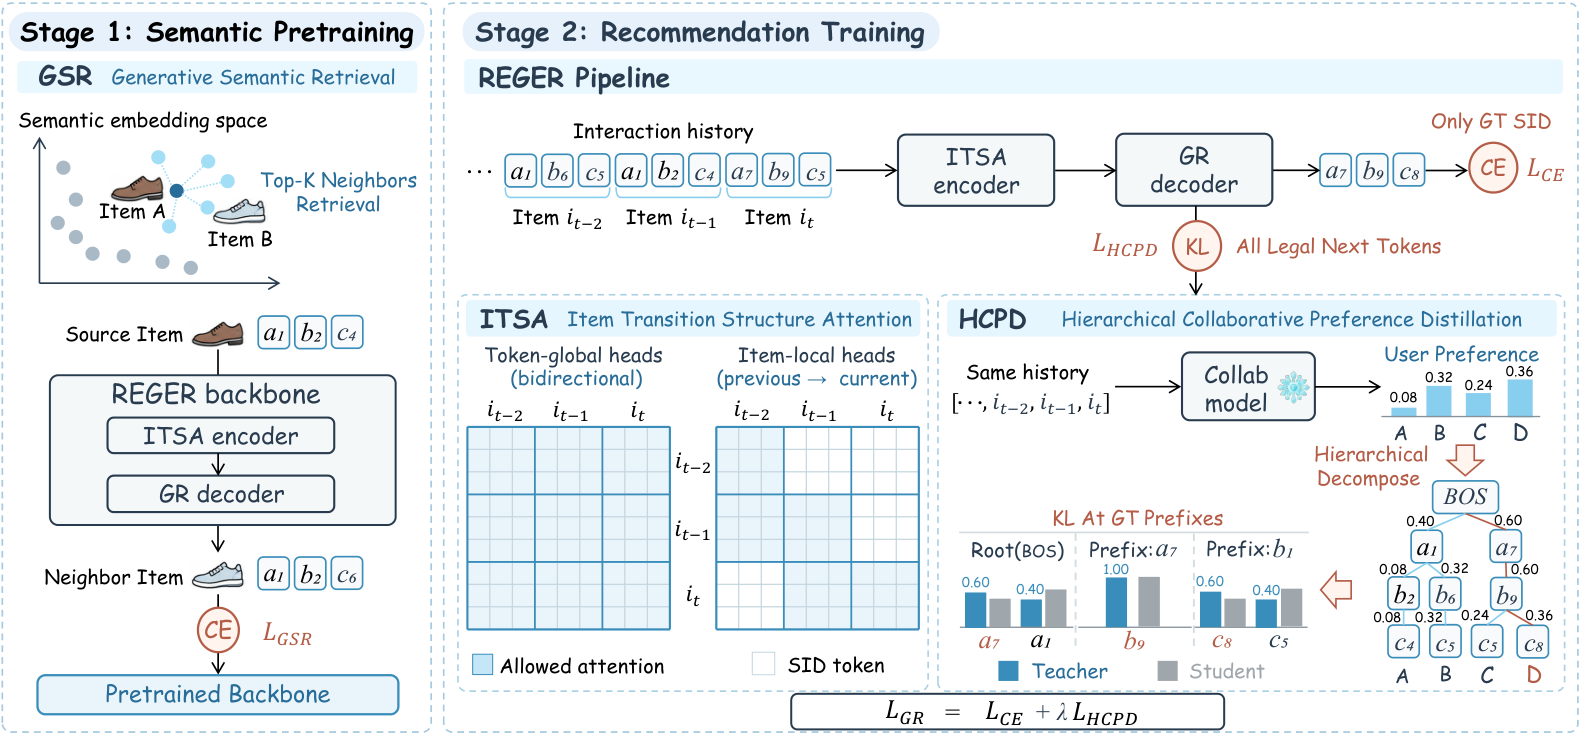
🔧 预训练阶段加了生成式语义检索(GSR):输入一个 item 的 SID,让 decoder 生成语义近邻的 SID,先让 token embedding 和整个 GR 模型学会“谁和谁像”,再去学用户偏好。
🧩 历史编码阶段提出 ITSA:把注意力头拆成两拨,全局头照旧做双向自注意力,局部头用对齐 SID 完整边界的窗口,只看当前 item 和它的前一个 item,把有向转移关系变成结构性约束而不是靠模型自己悟。
⚙️ 生成阶段提出 HCPD:把 SID 组织成前缀树,证明判别式推荐器估的物品偏好分布可以精确分解为各前缀上合法下一 token 的条件分布,item 级 KL 也能拆成前缀条件 KL 的加权和;据此在目标 SID 路径的真实前缀上蒸馏 teacher 的完整条件分布,和交叉熵联合优化。
📊 在 6 个真实数据集上做的实验,覆盖了主流的 GR baseline。
📈 相对现有 GR 方法是一致性提升,不是只在个别数据集上赢。
✅ 消融实验单独验证了偏好蒸馏这一项确实在起作用,论文同时报了 HCPD 的效率。
🧪 三个挑战(语义相似、转移结构、用户偏好)分别对应三个模块,拆得比较干净,方便复现时逐个开关。
总结一下:如果你在做生成式召回或者 SID tokenization,这篇的三段式思路可以直接拿来对照自己 pipeline 里哪一环是隐式的。要盯的指标是前缀条件 KL 有没有真的降下来,以及长尾 item 上的收益是否被头部吃掉。坑在于 HCPD 依赖一个判别式 teacher,teacher 本身训不好,蒸馏过去的就是噪声;另外局部注意力窗口和 SID 长度绑定,换 tokenizer 得重新调。比起只改 tokenizer 的那类工作,它更像是改训练目标,和 hybrid 检索路线不冲突,可以叠。
原文:AlphaXiv