小红书精读:Rethinking Positional Encoding and Interaction Granularity for CTR Prediction
CTR里的位置编码,可能一直是负收益
各位算法同学们,先问一句:Transformer 做 CTR,位置编码真的有用吗?这篇在 KuaiRand 上把 OneTrans 的 6 种位置编码全试了一遍,没有一个打赢直接不加位置编码(NoPE)。作者顺着这个反常识现象往下挖,重新追问了两件事:CTR 到底需要什么位置信息,历史行为该在什么粒度上交互。
📄 Rethinking Positional Encoding and Interaction Granularity for CTR Prediction(武大、腾讯、北大)
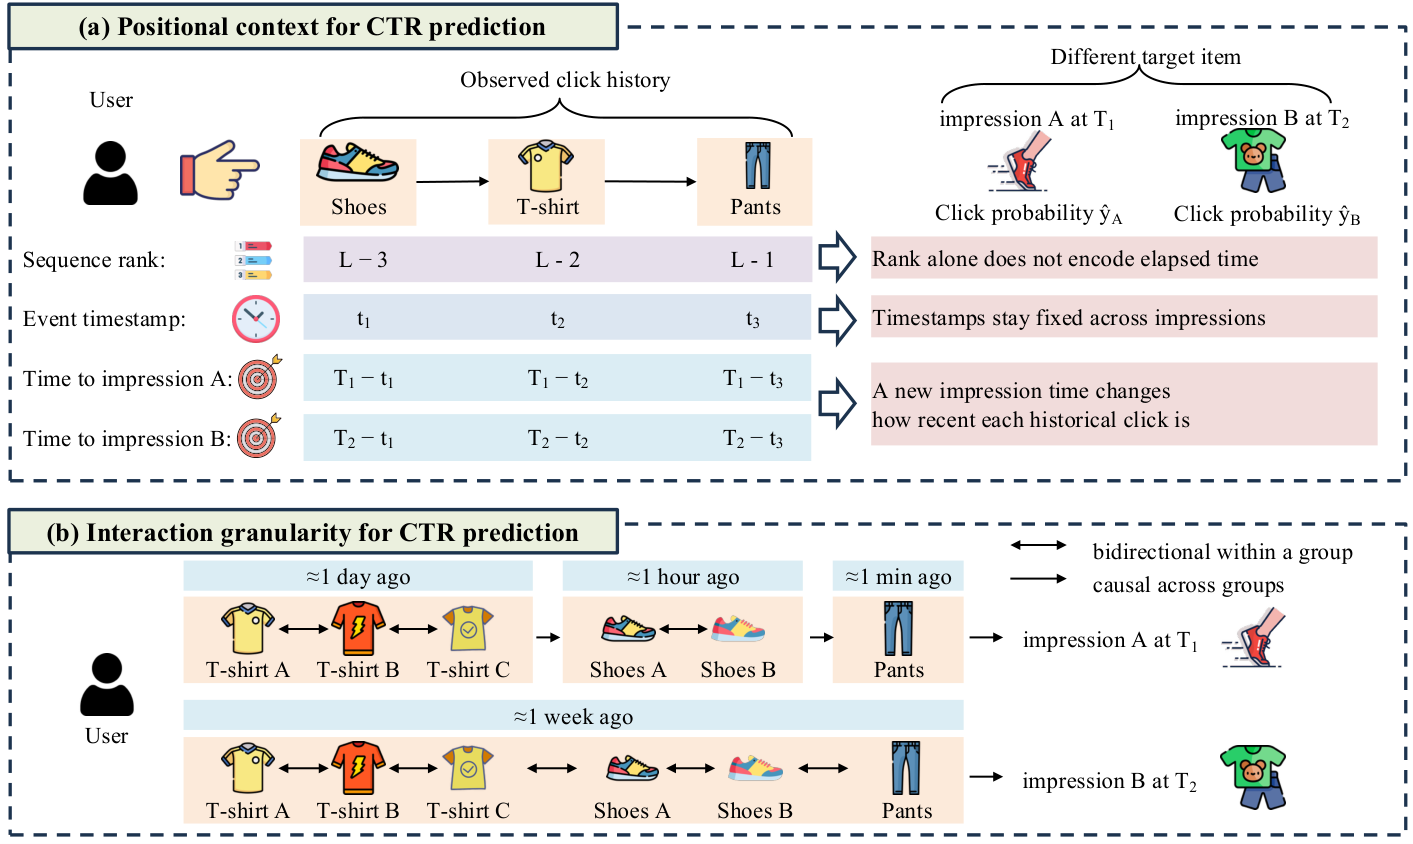
🔧 位置信息其实有三层:序列 rank、事件时间戳、以及行为到当前预测目标的相对时间。前两个在固定历史里不变,但“距目标多远”会随每次曝光变化,同一个 rank 在不同请求下含义完全不同,所以只靠 rank 或只靠时间都不够。
🧩 Factorized Rank Encoding 用低秩分解参数化 rank 嵌入。作者观察到学出来的 rank embedding 近似低秩,几个主方向就能还原大部分性能;参数量从 LD 降到 D+LK+KD,文中给的是 3.8 到 21.6 倍缩减。Target-Relative Time Encoding 则把“距目标的时间距离”做成由粗到细的可学习时间势,直接当 attention bias 用。
⚙️ 交互粒度上提出 Temporal Group-Causal Interaction:按目标相对时间把历史分组成时间桶,组内双向交互并加掩码 item 重建,组间保留因果顺序,最后压成 group summary 传给后续层。它比 token 级全因果放得开,又不像全局双向那样把兴趣演化顺序抹掉。
📊 四个公开 benchmark、11 个 baseline,在每个数据集上都赢最强 baseline,平均相对 AUC 提升 1.47%,TAAC 上最高提升 4.45%。
📈 这套 target-aware 的 rank+time 编码还能直接搬到别的 Transformer CTR 主干上;相对同一主干下 8 种位置编码配置里最好的那个,最高再涨 4.20%。
✅ 消融实验里,rank 和 target-relative time 两个分量各自拿掉都会掉点,说明不是只有其中一个在起作用。
总结感想:如果你的模型还在直接继承 LM 那套 APE、RoPE 加 token 级 causal attention,建议先在自己数据上复核一遍 NoPE 基线,确认位置编码到底有没有贡献,再决定上不上 FRE、TRTE。有两个需要留意的点。TRTE 依赖准确的曝光时间戳和分桶尺度,粗到细的粒度选错可能没有收益;分桶还会改变有效序列长度和算力开销,线上除了 AUC 也要看按时间间隔分层的校准。相比 SASRec 式纯序列表征,它的优势集中在“同一用户多次曝光、时间间隔分布很偏”的场景。
原文:AlphaXiv