小红书精读:PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn
相似度检索在职场推荐失灵了🔍
各位算法同学们,求职的工程师不点同行,点的是招聘官和猎头。也就是说,职场推荐的相关性本质上互补而非对称,用资料相似度做召回,方向从一开始就反了。这篇 LinkedIn 的落地论文把这个错位讲清楚了,还给出了能上线的解法。
📄 PAIR: Preference-Aligned Intent Retrieval for Premium People Recommendation at LinkedIn
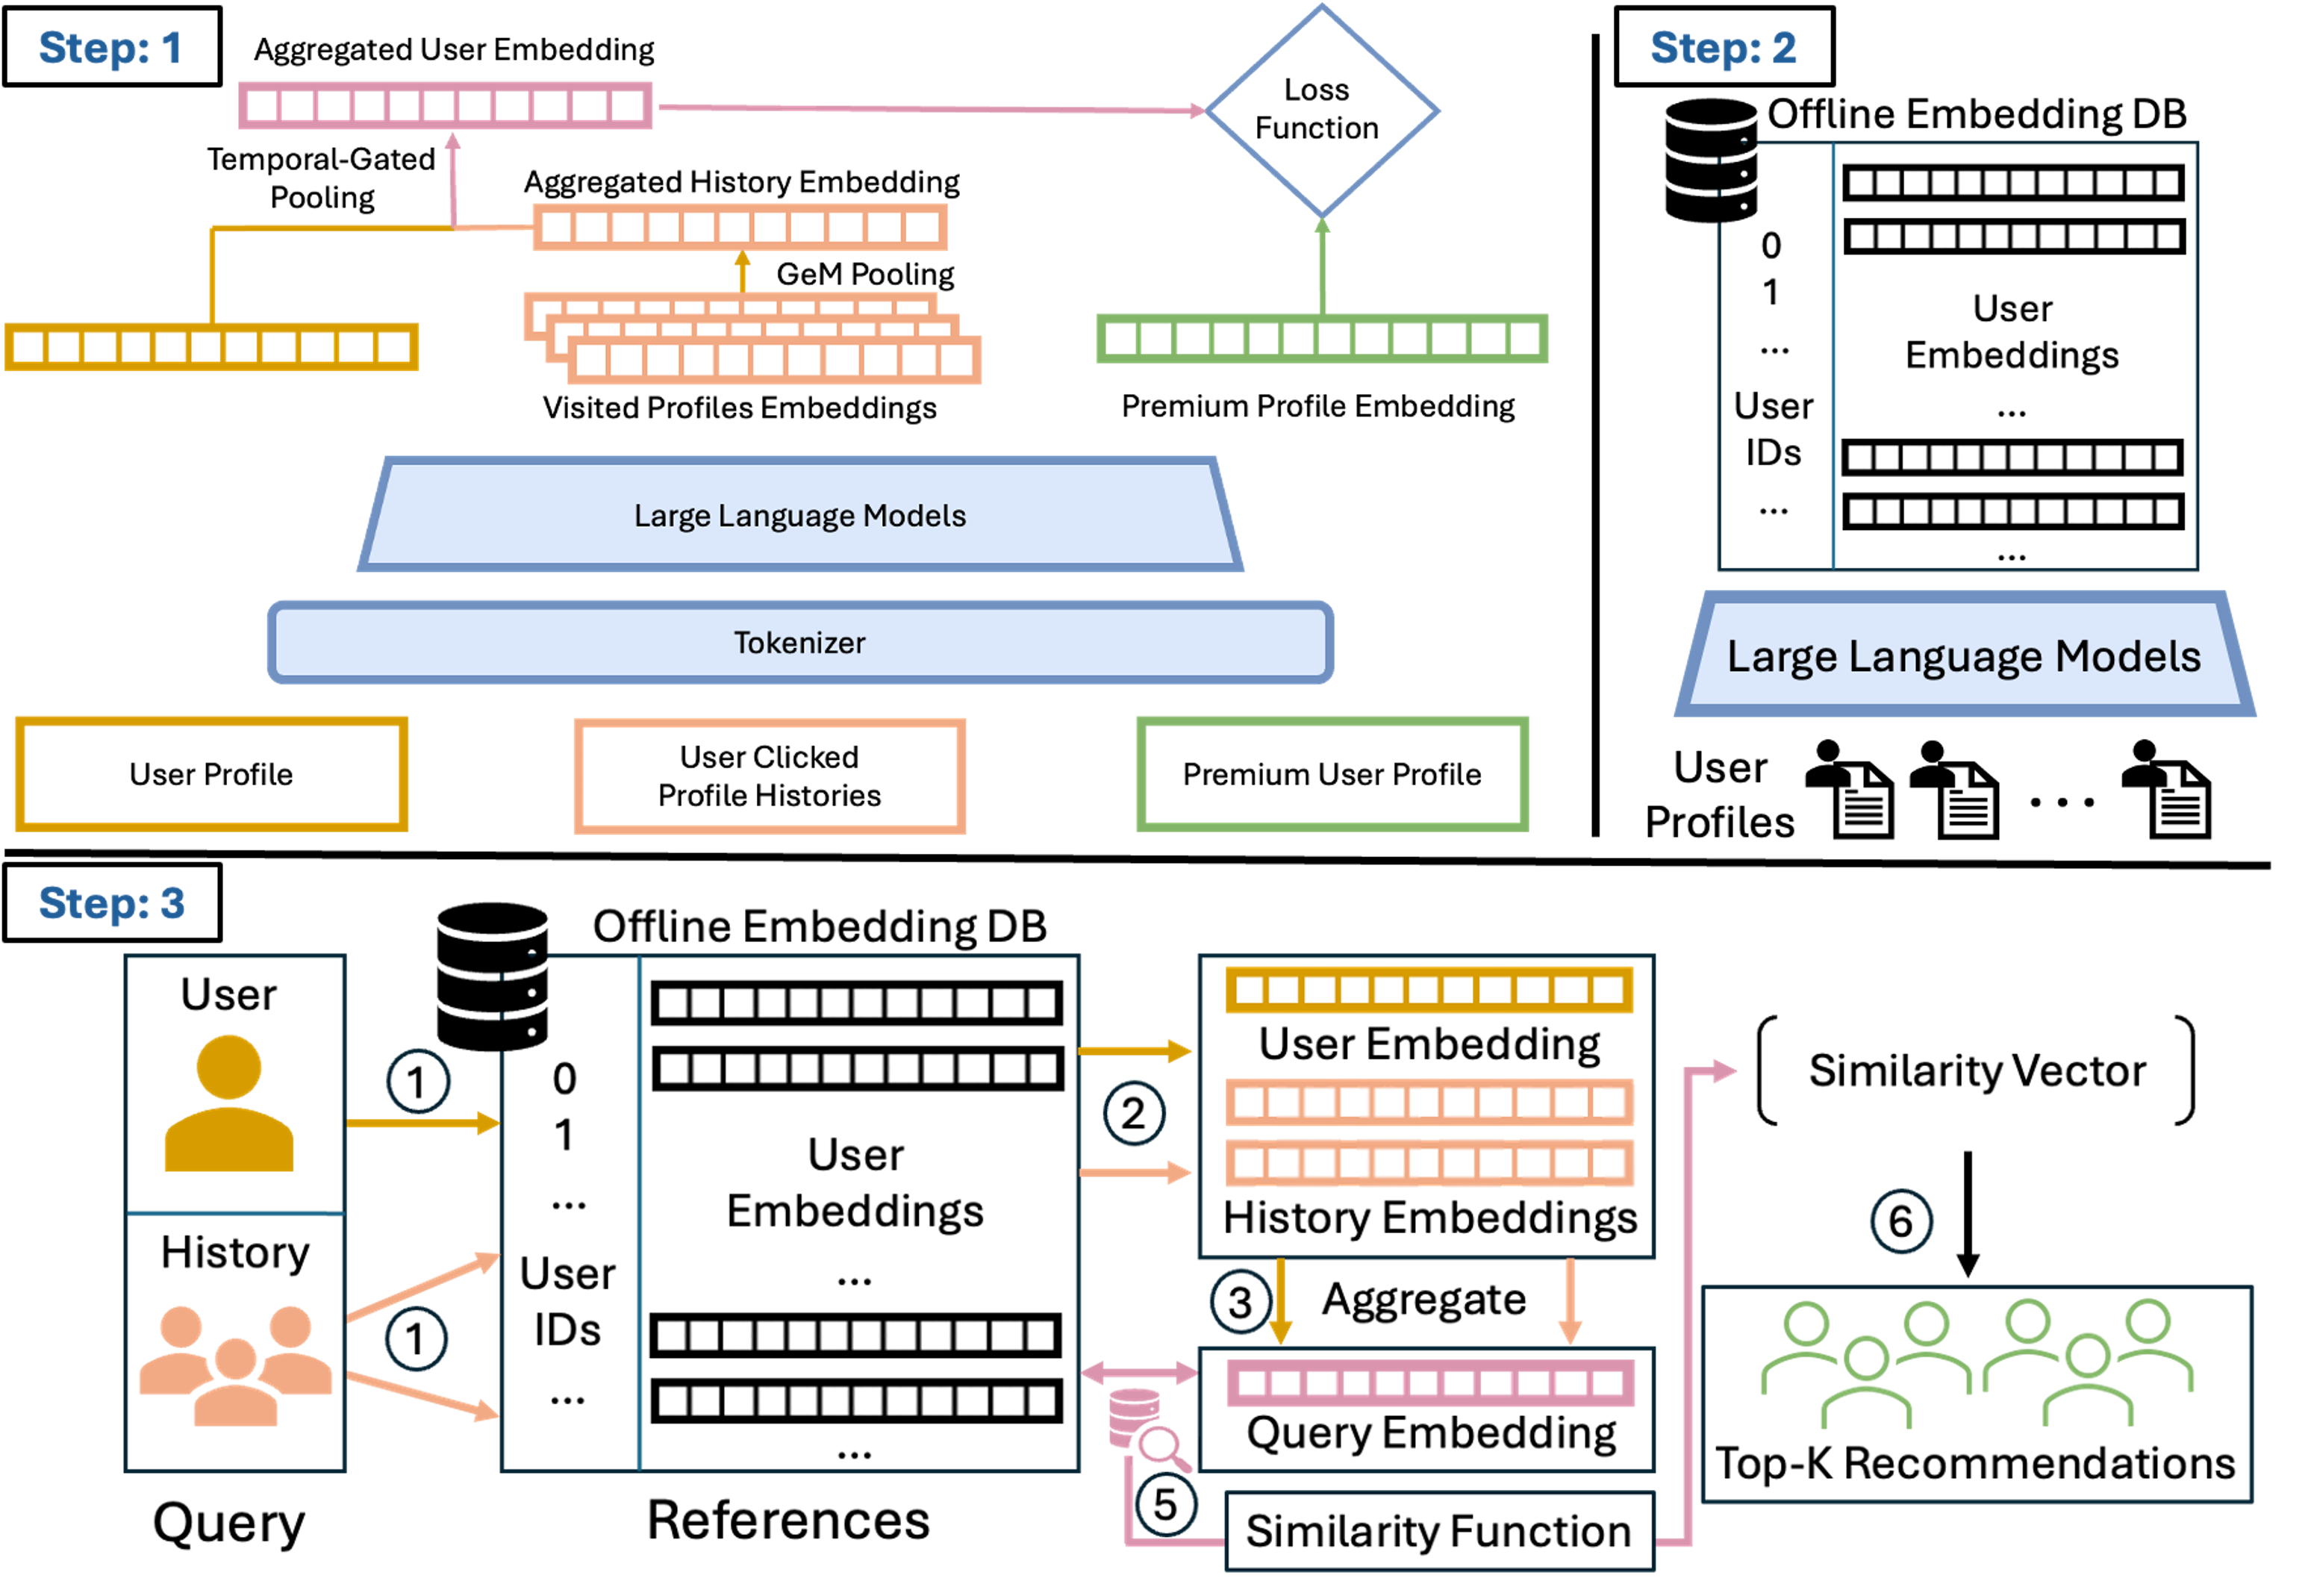
🔧 把监督信号从“相似”换成“偏好”:负样本不用随机 in-batch,而是取生产曝光日志里“曝光但没点”的候选,点击高于曝光未点击即构成偏好对。形式上像多负对比学习,但语义是曝光条件化的偏好,还省掉了 DPO 那套参考模型前向。
🧩 三塔结构:静态 profile 向量加一路用位置编码聚合最近点击历史的历史向量,加法融合。更新用户意图只做 O(Kd) 向量运算,服务端不用重跑 LLM 编码历史。
⚙️ Matryoshka 训练让同一个模型截断出不同维度,适配不同延迟和存储预算的多个推荐场景。
📊 离线 MAR@100:PAIR 0.6B 拿到 0.450,线上production embedding Holistic-171 只有 0.288,相对提升 56%;通用 0.6B LLM embedding 仅 0.192,约 2.3 倍。
📈 线上 A/B(Premium Browsemaps):CTR 提升 7.5%,Premium 留存提升 2.1%,延迟无可测回退。
✅ 同参数规模下,任务特定的偏好监督比堆模型规模更能决定召回质量。
总结感想:做跨角色匹配的都值得看,招聘、交易撮合、创作者对接品牌,这类场景里相似度召回天然吃亏。落地时盯两件事:曝光未点击负样本是否被位置偏置污染,以及历史窗口长度对意图漂移的敏感度。坑在于加法融合牺牲了序列建模表达力,意图基本只能按天级刷新,兴趣切换快的用户可能追不上。和 PinnerFormer 那类要序列推理的方案比,它明确是拿一部分效果换服务成本。
原文:AlphaXiv