小红书精读:SPAR: Stepwise Personalized Autoregressive Recommendation with Prefix-Balanced Semantic IDs
SID树解码,错一步就救不回来🔍
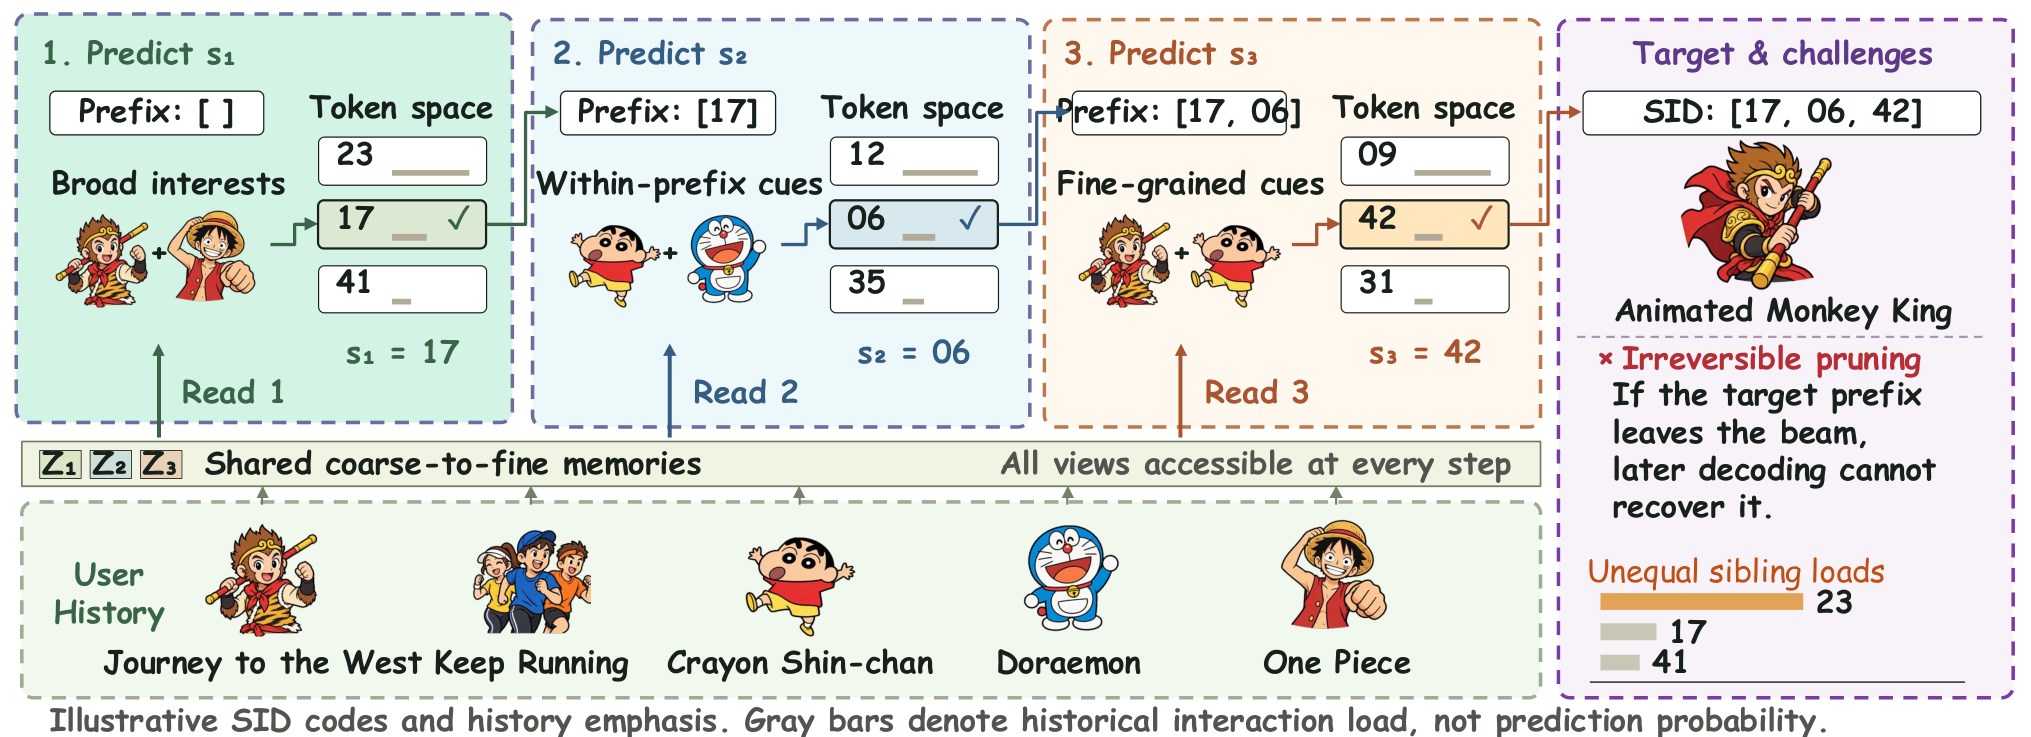
各位算法同学们,生成式推荐里最难受的一点是:SID树只要有一层选错父节点,后面beam开再宽也救不回来,因为目标前缀已经被剪掉了。这篇工作就在处理这个不可逆的剪枝问题,并顺带把候选分支负载不均的老毛病拉了进来一起修。
📄 SPAR: Stepwise Personalized Autoregressive Recommendation with Prefix-Balanced Semantic IDs
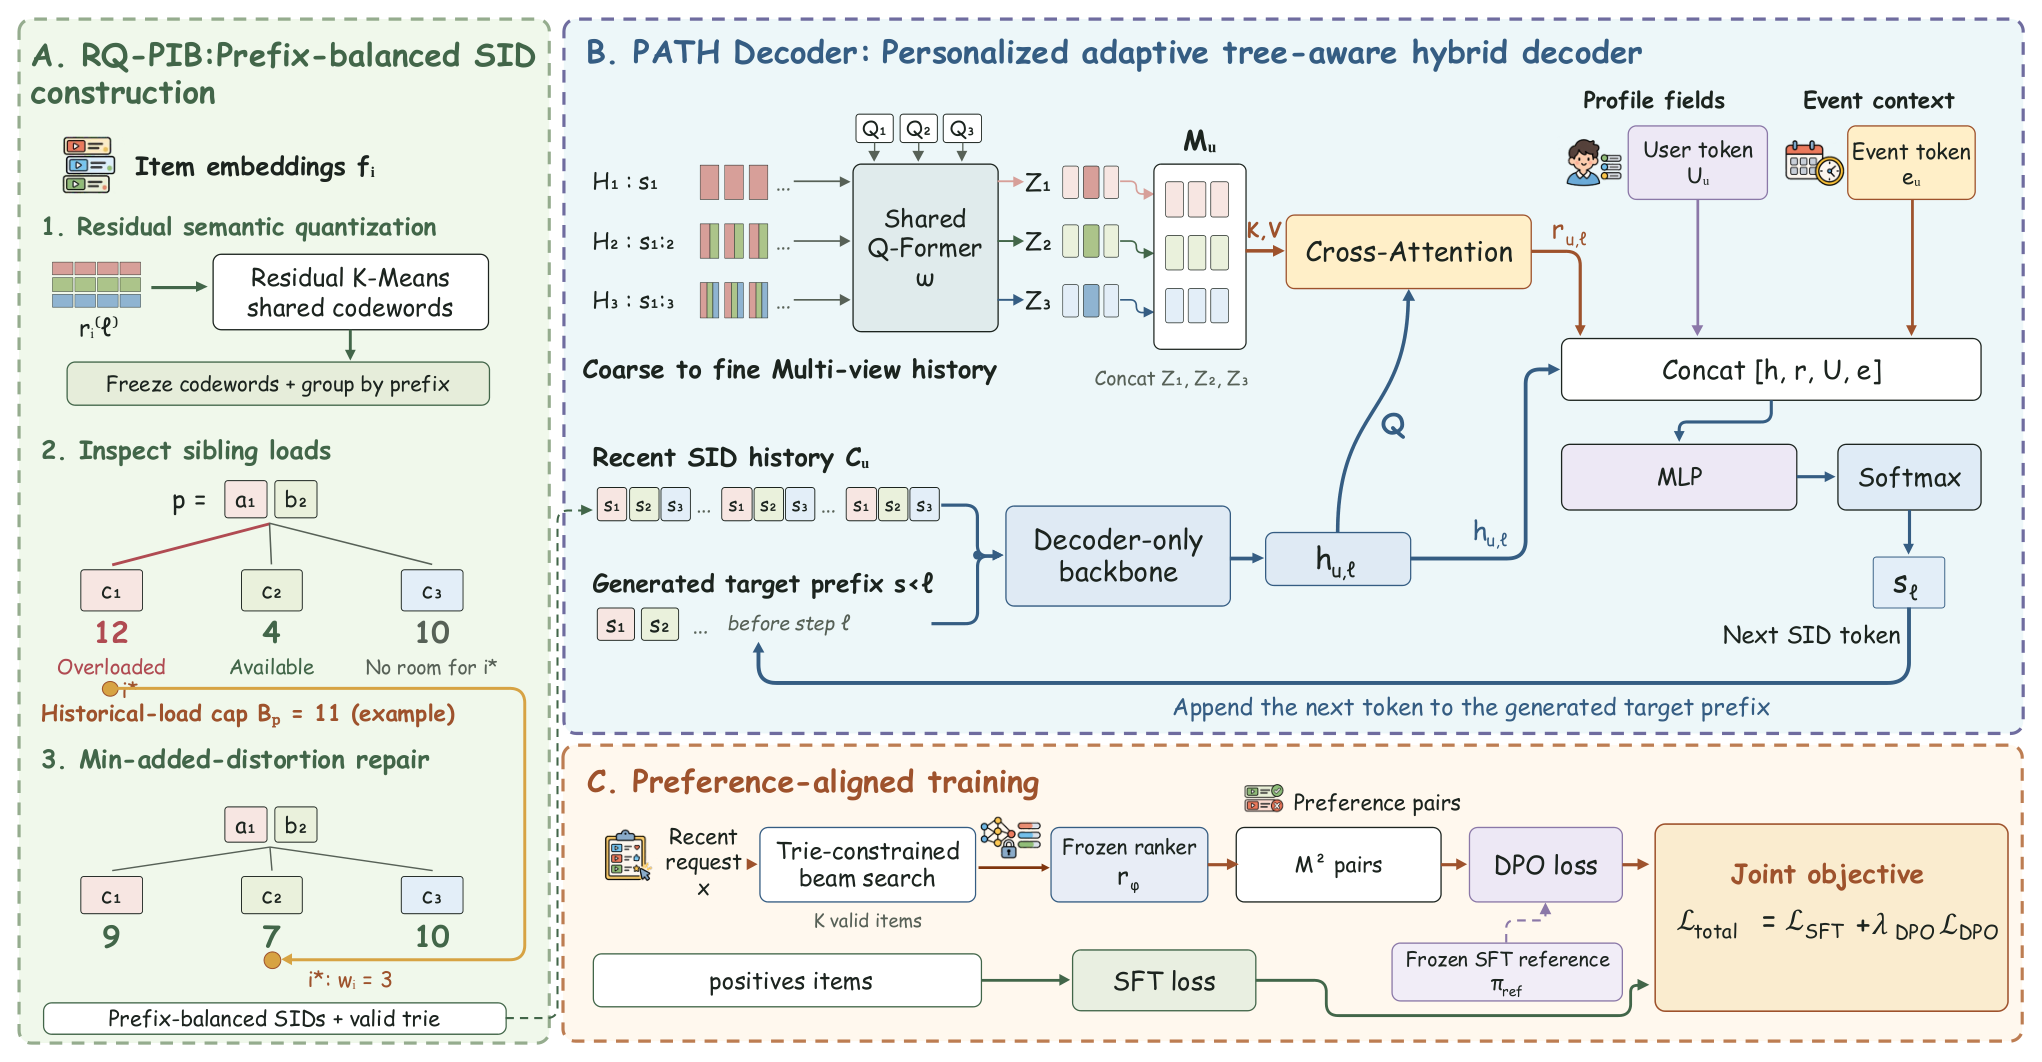
🔧 PATH Decoder:把长期行为按SID树深度压成由粗到细的memory bank,每一步解码用prefix-conditioned cross-attention按当前已生成前缀去捞证据,再与近期行为、用户画像、请求时event context拼接,并非给出一个固定user向量,让每步看到不同证据。
🧩 RQ-PIB:作者指出全局码本均衡是假象,同一个codeword挂在不同的父前缀下,条件分布可能极其偏斜。该方法在RQ基础上只在同父兄弟分支间重排交互负载,用最小语义重构误差换局部均衡。
⚙️ 两件事是耦合的:SID构造决定每层有哪些候选分支,解码器决定怎么给分支打分,只优化一头会出现候选空间与个性化证据错位。
📊 优酷大规模离线数据上,HR@10/20/50/100平均相对提升2.66%(对比最强基线)。
📈 目标前缀保留率平均涨5.79个百分点,说明不可逆剪枝确实少了。
✅ 流量加权后的最大子分支占比在各SID层平均降32.84%,热门路径的压制被削弱。
🎬 线上7天A/B,10%生产流量,人均观看时长+3.95%,播放转化率+3.38%。
总结感想:做生成式召回、尤其已经在跑SID+TIGER/OneRec这条线的人可以跟。要盯两个指标:target-prefix retention,以及各层兄弟分支的负载分布,只看整体HR容易被平均掉。坑在于RQ-PIB会改动物品码,SID一变就得重训或重对齐,语义重构误差也得现场验;另外prefix检索是逐步做的,线上延迟要单独压测。
原文:AlphaXiv