小红书精读:Structure-Aligned History Learning with Subspace-Structured Semantic IDs for Generative Recommendation
生成式推荐:量化和重建终于对齐了
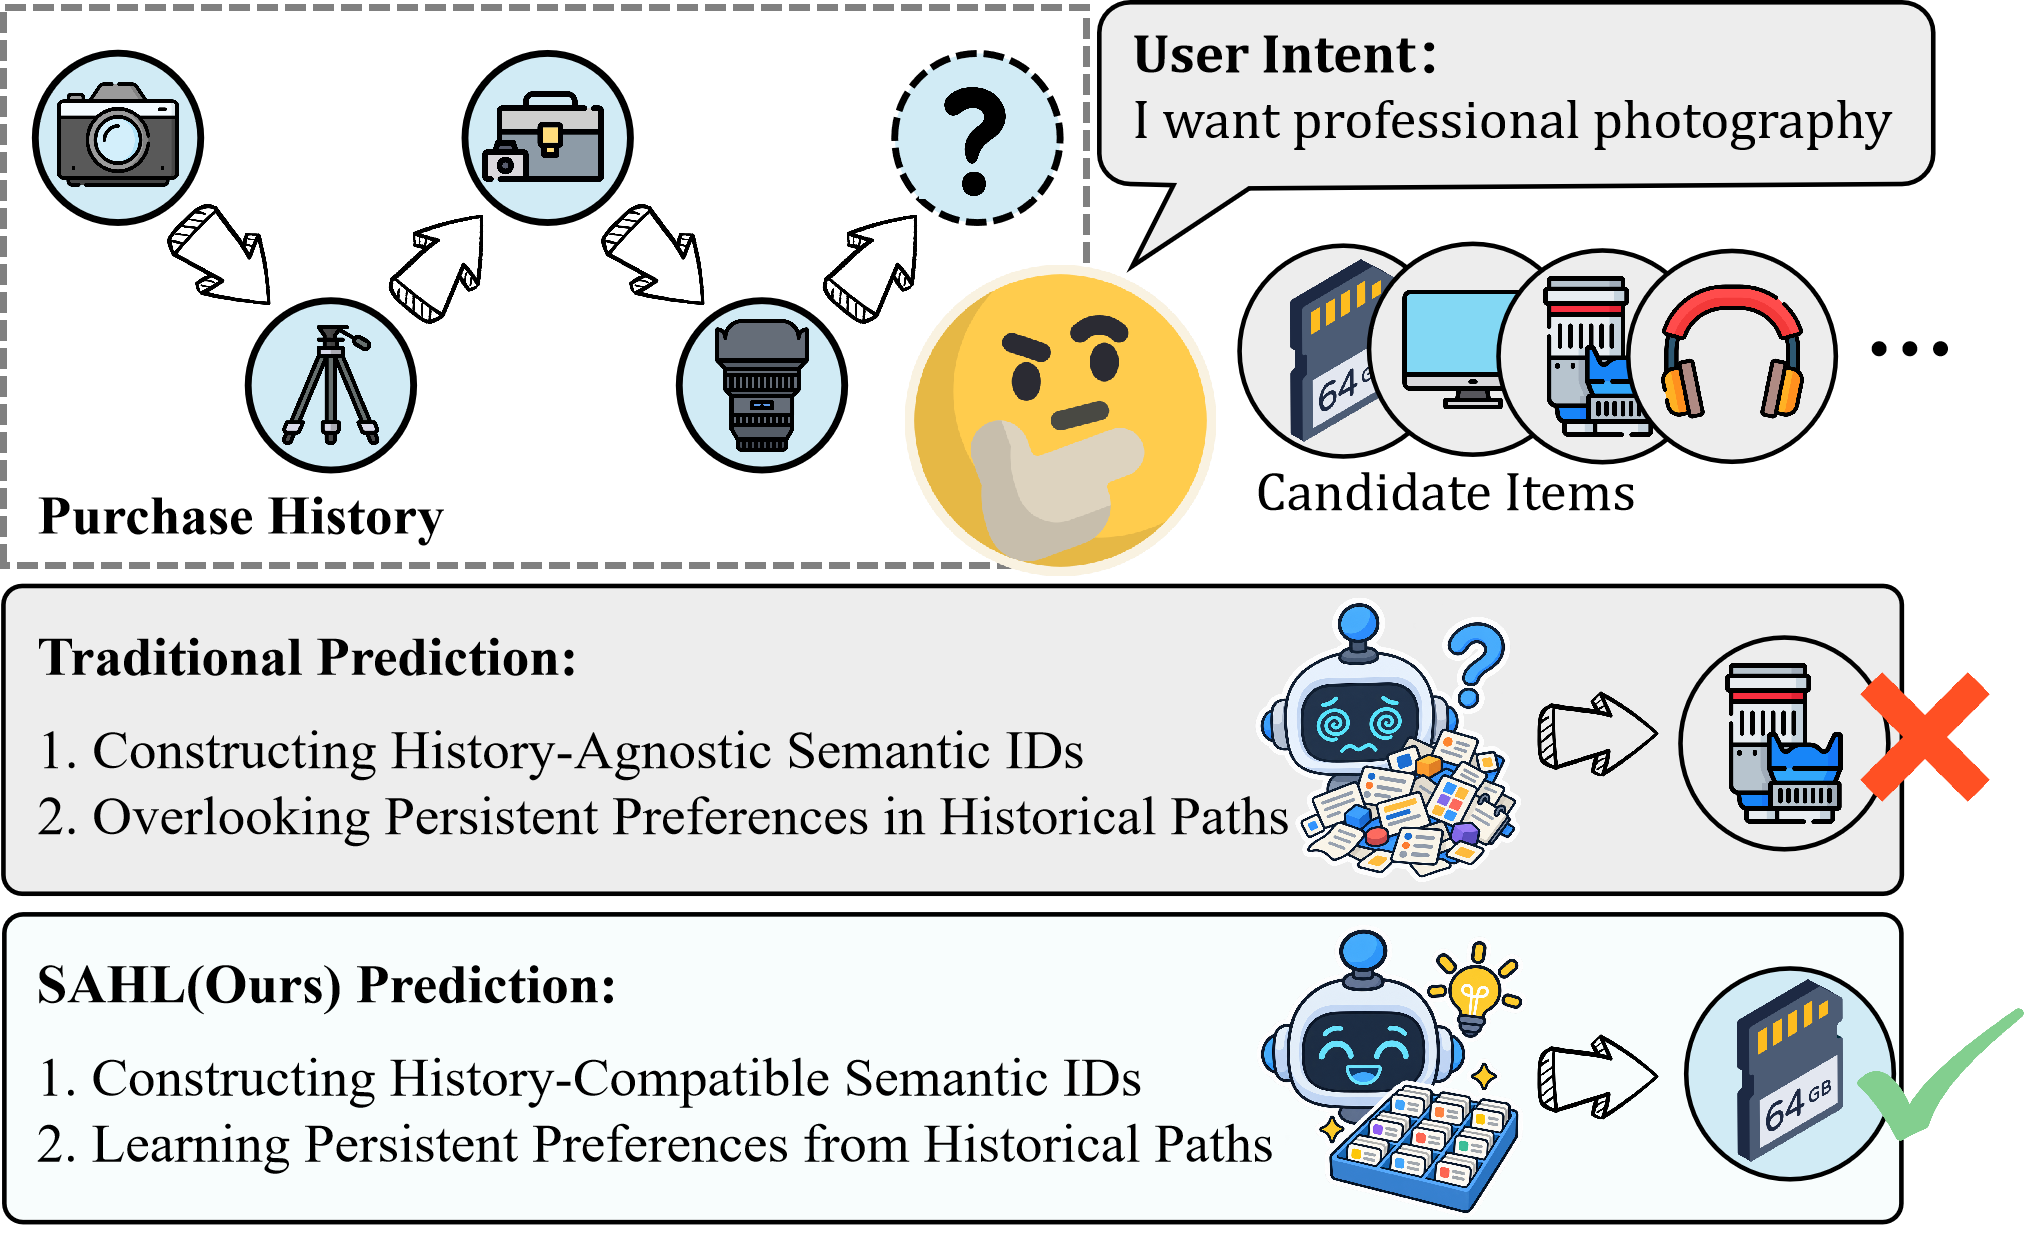
各位算法同学们,同一套模型、同一批数据,历史重建的“切法”换成量化器自己分好的组,NDCG@10 就能明显往上走——差别不在模型结构,而在“按什么粒度重建历史”。这篇就是把量化和历史学习这两段本来各练各的流程接了回去。
📄 Structure-Aligned History Learning with Subspace-Structured Semantic IDs for Generative Recommendation
🔧 SRBQ 先把去相关后的维度切成子空间,在每个子空间内做残差量化,再对码字占用加约束,直接产出 token ⊂ subspace ⊂ item 的平衡层级,而不是只给单 token 和整条 ID。
🧩 历史重建用的正是这套层级:token 级、子空间级、item 级三种掩码目标,跟量化阶段的结构一一对应,不用再人为拼 token 块。
⚙️ 用预测熵挑出不确定的转换优先重建,配课程学习:随机掩码 → 熵引导重建 → 无掩码的下一个物品预测,把历史重建能力带到推理阶段。
📊 四个 Amazon Reviews 2014 类目上,NDCG@10 比同架构 RPG 高 18.6%–30.0%,比 MHL 高 2.7%–6.0%。
📈 SRBQ 把码字平均峰值负载降 28.8%–32.4%,最差峰值负载降 37.3%–41.3%。
✅ 控制实验里,重建时用真实 SRBQ 分组优于同等大小的人造分组;打乱用户历史后收益下降,说明模型确实依赖用户自己的路径。
你们在做 semantic ID 生成式推荐、正卡在码本利用率和长距离偏好这两件事上,这篇的 SRBQ 和“重建粒度跟着量化结构走”可以直接参考。要注意的是训练被拆成三阶段课程,掩码比例和熵筛选阈值得重调,工程成本不低;而且验证只在 Amazon 2014 四类目,换成工业长序列前,建议先在自己的数据上对齐 RPG、MHL 两个 baseline,重点盯码字占用分布和 NDCG@10 的增益是否还在。
原文:AlphaXiv