小红书精读:OneChord: Distill What You Rank, Recommend in One Pass
蒸馏别蒸错:蒸你上线排的那个分布 🎯
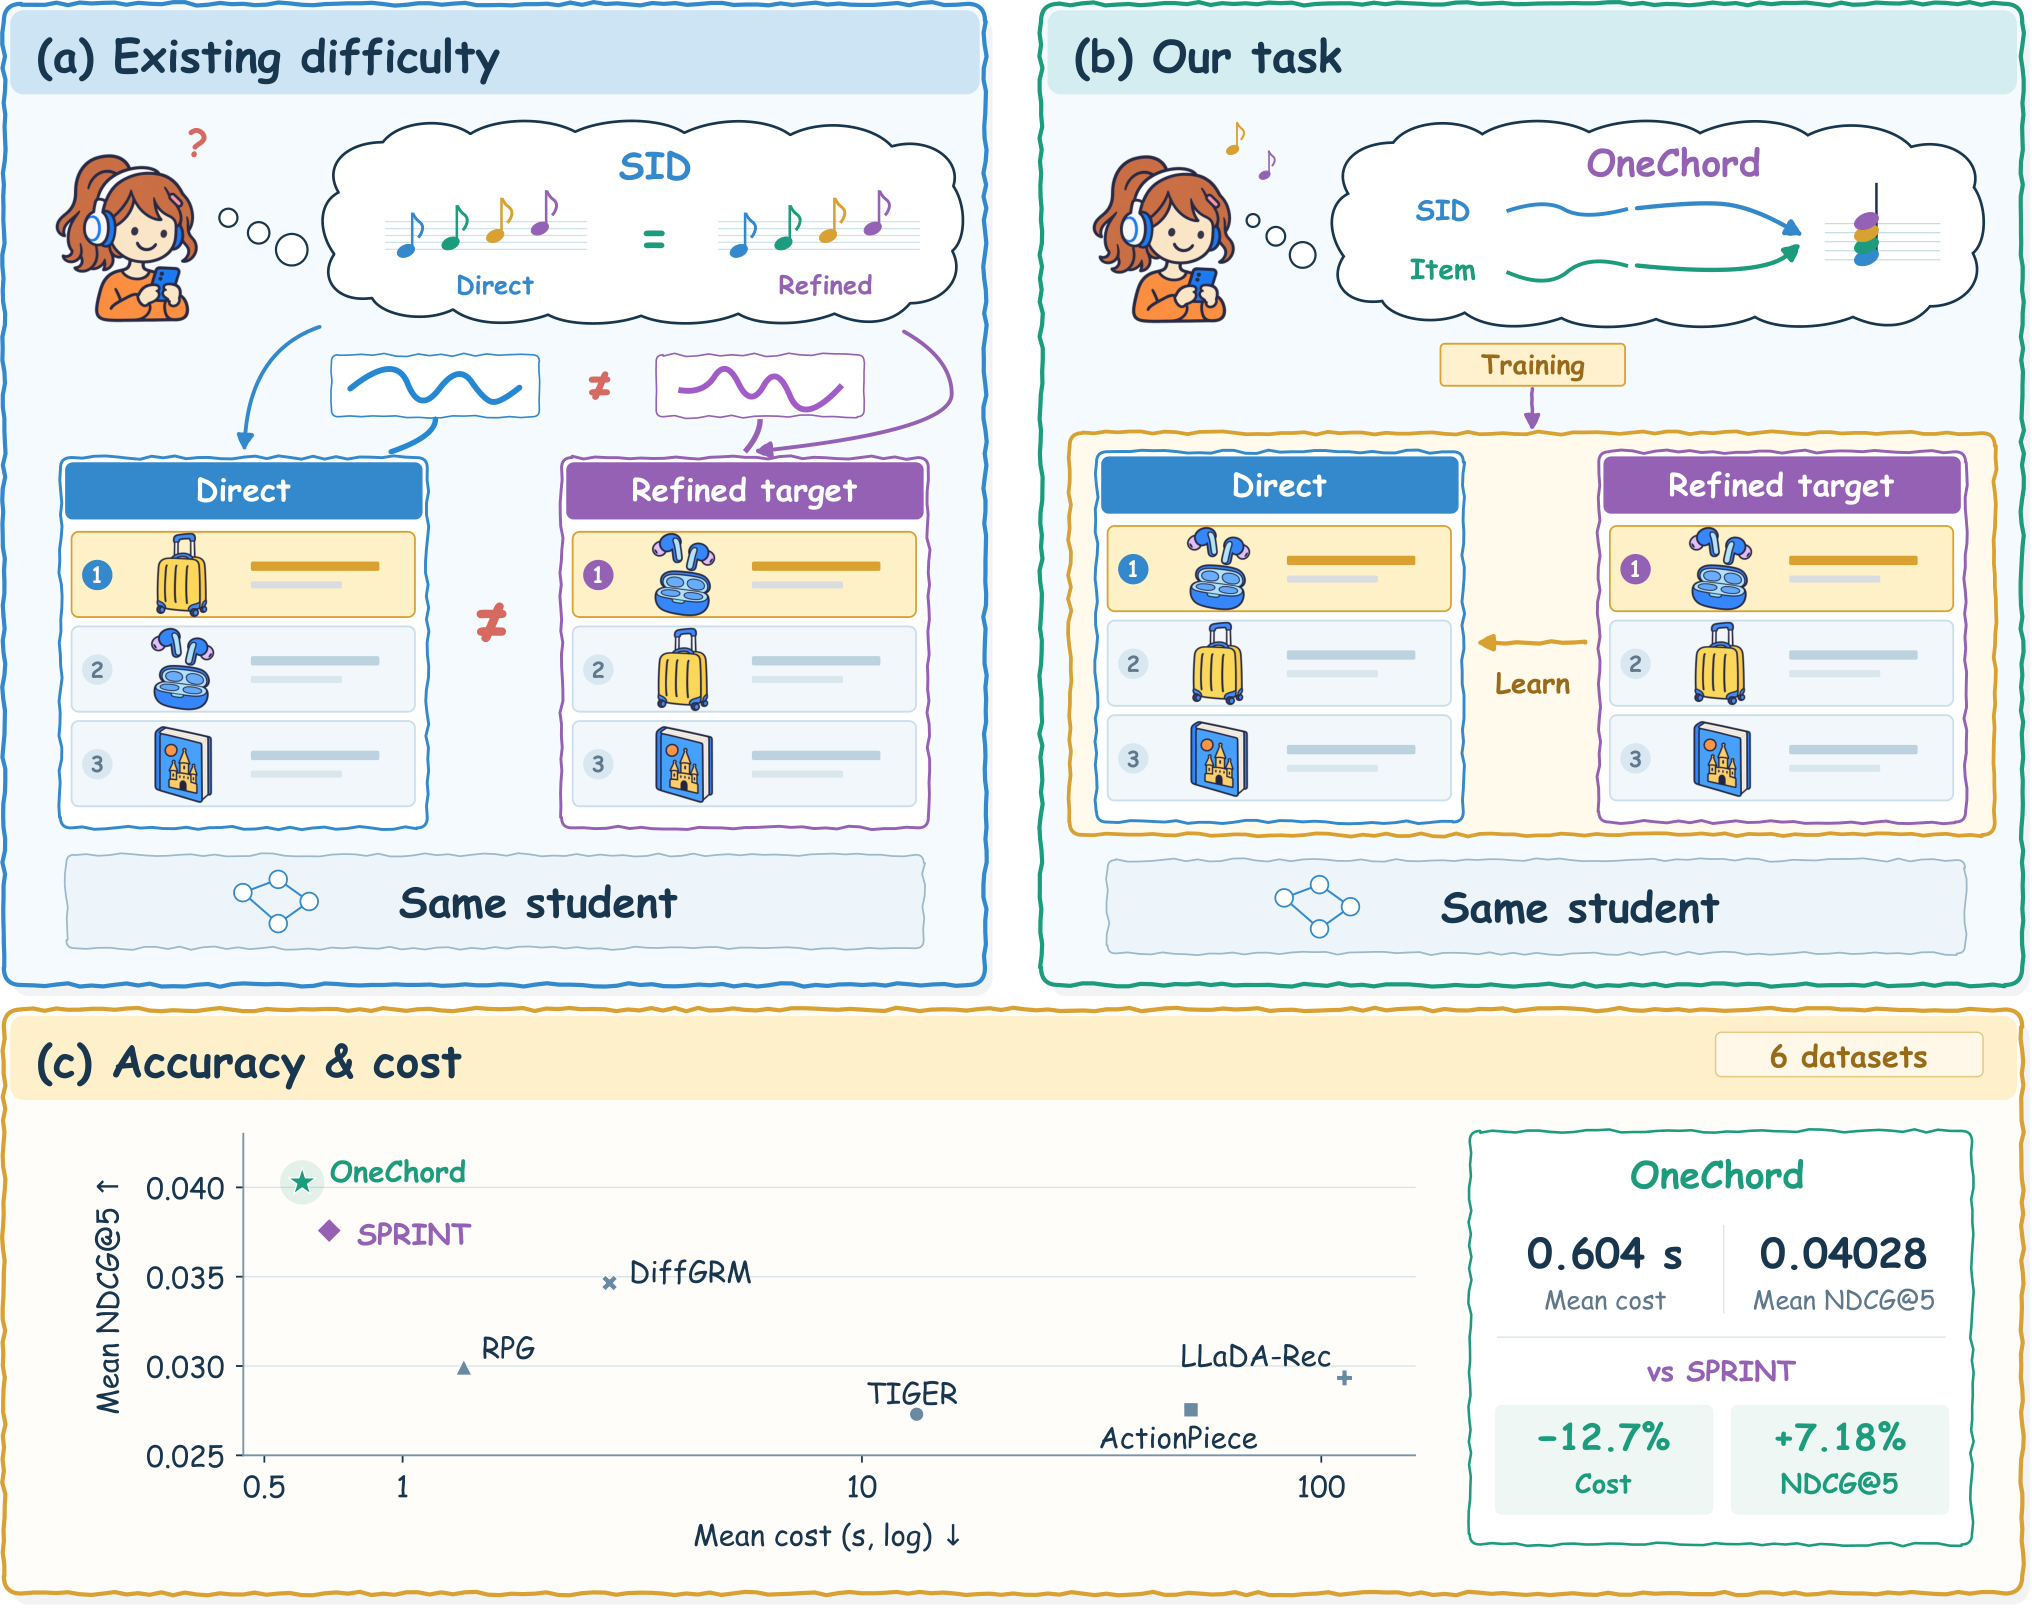
各位算法同学们:语义ID推荐里,训练时蒸馏的分布和线上真正参与排序的分布往往不是同一个,这篇论文要解决的就是这个错位:SID概率和item相似度到底怎么归一化、权重怎么配,直接决定谁进Top-K。
📄 OneChord: Distill What You Rank, Recommend in One Pass(中国科学院大学)
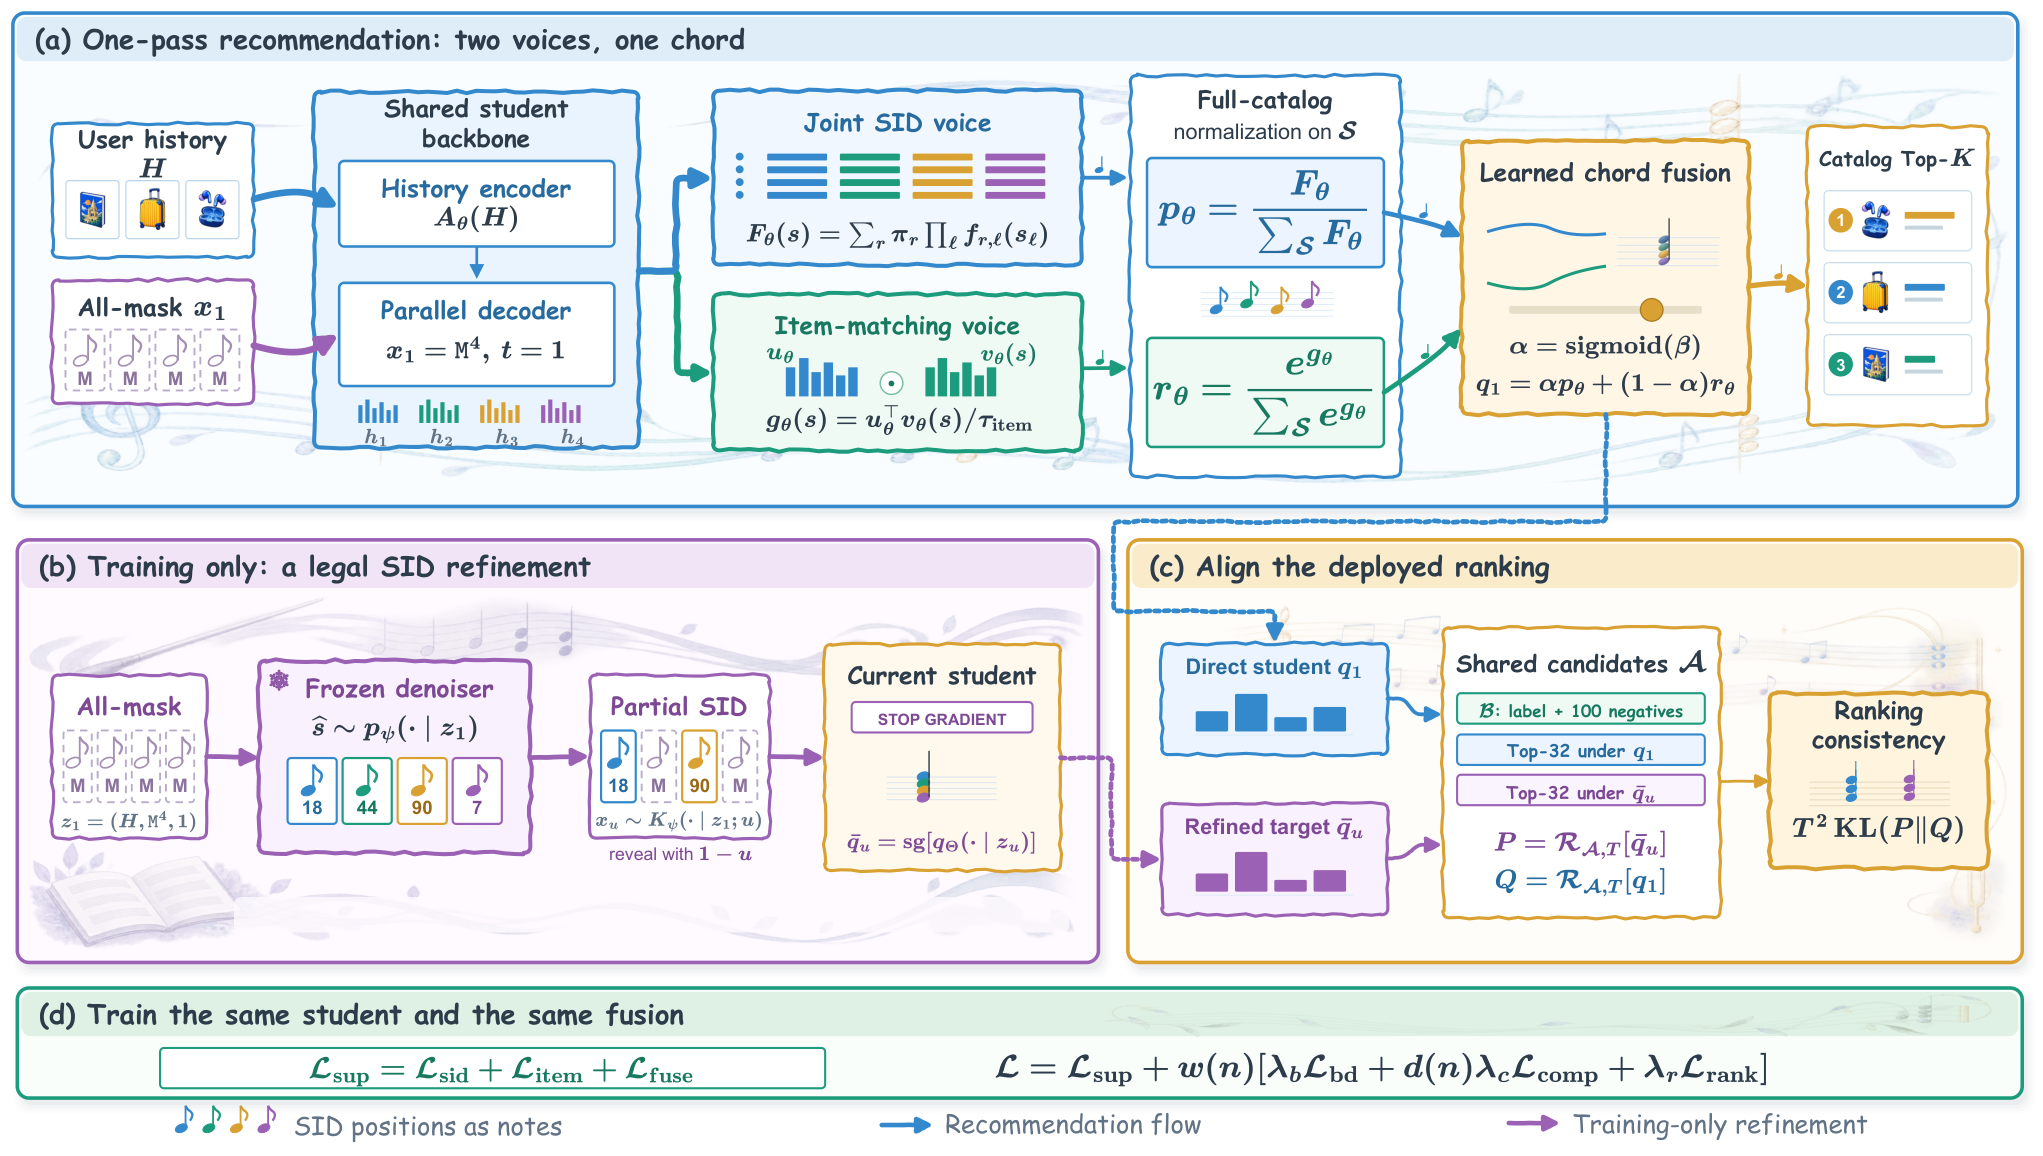
🔧 用一个可学习的门控α,把SID概率和item匹配分分别在全库上归一化后再融合,下一次点击的似然直接监督这个融合分布本身,而不去分别监督两个分支。
🧩 训练时由冻结的去噪器给出合法的部分SID,学生模型对这些中间态打分,得到“精修后的融合分布”;再在共享难候选集上做排序一致性对齐,其中候选集由label、100个负样本和两边各自Top-32组成,从而把精修能力压进一次前向推理。
⚙️ 论文给了两个命题:门控α的梯度等于α减去SID分支对真实目标的“责任”,固定分支时损失对α是凸的;候选条件化会让分支权重漂移——必须先全库归一化、再融合、最后取候选,顺序反了排序会翻。
📊 六个Amazon数据集上Recall@5和NDCG@5全部第一,相对最强基线平均+6.30%和+7.12%;Beauty上NDCG@5相对提升9.96%。
📈 全测试集生成速度比最快基线快1.04–1.18倍,准确率和延迟没有互相拖累。
✅ 对比SPRINT那类一次前向同时出SID分和item分的做法:平均NDCG@5 +7.18%,平均生成成本低12.7%。
💭 这套方法适合正在做生成式推荐或SID召回、并且线上确实要把code概率和item相似度融合的人。重点看最终融合分布上的Recall@5和单次生成延迟,别只盯SID分支自己的命中。需要留意两个问题:它依赖固定语义索引和冻结去噪器,换索引基本要重训;融合门控在数据集内共享,多场景混跑时要确认α没有被大场景带偏。
原文:AlphaXiv