小红书精读:Don’t Rewrite the SID Map: Topology Preservation for Generative Retrieval in Dynamic E-Commerce Search
SID别乱重写,beam开大反而藏坑 🔍
各位算法同学们,你以为线上用 beam size 1000 评估就稳了?同一批映射更新,beam 1 下 HitRate 掉 41.78%~62.05%,beam 1000 下只掉 8.33%~10.85%——宽 beam 靠多生成候选把漂移的严重性盖住了,很多系统其实是在一种虚假的安全感里运行。这篇来自淘天、南开和中科大的工作,用 67 天真实电商搜索日志把「SID 映射该怎么更新」当成受控变量拆开做实验,结论是别修,别让它坏。
📄 Don’t Rewrite the SID Map: Topology Preservation for Generative Retrieval in Dynamic E-Commerce Search
🔧 把映射策略本身当作实验因子:从全量重映射到完全冻结整条谱系都跑一遍,再单独控制训练策略,这样才把「映射改动造成的损伤」和「继续训练带来的修复」分开量化,而不是又提一个修复算法跟基线比。
🧩 量化出漂移的单调性与不可修复性:旧物品 SID 被改的比例从 0% 升到 72.75%,HitRate 单调下降,beam 1 下最多掉 42.66%;同样预算的 warm-start 之后,全量重映射依然明显差于保留拓扑的策略,说明模型已经把 SID 空间的隐式拓扑学进去了,短预算继续训练补不回来。
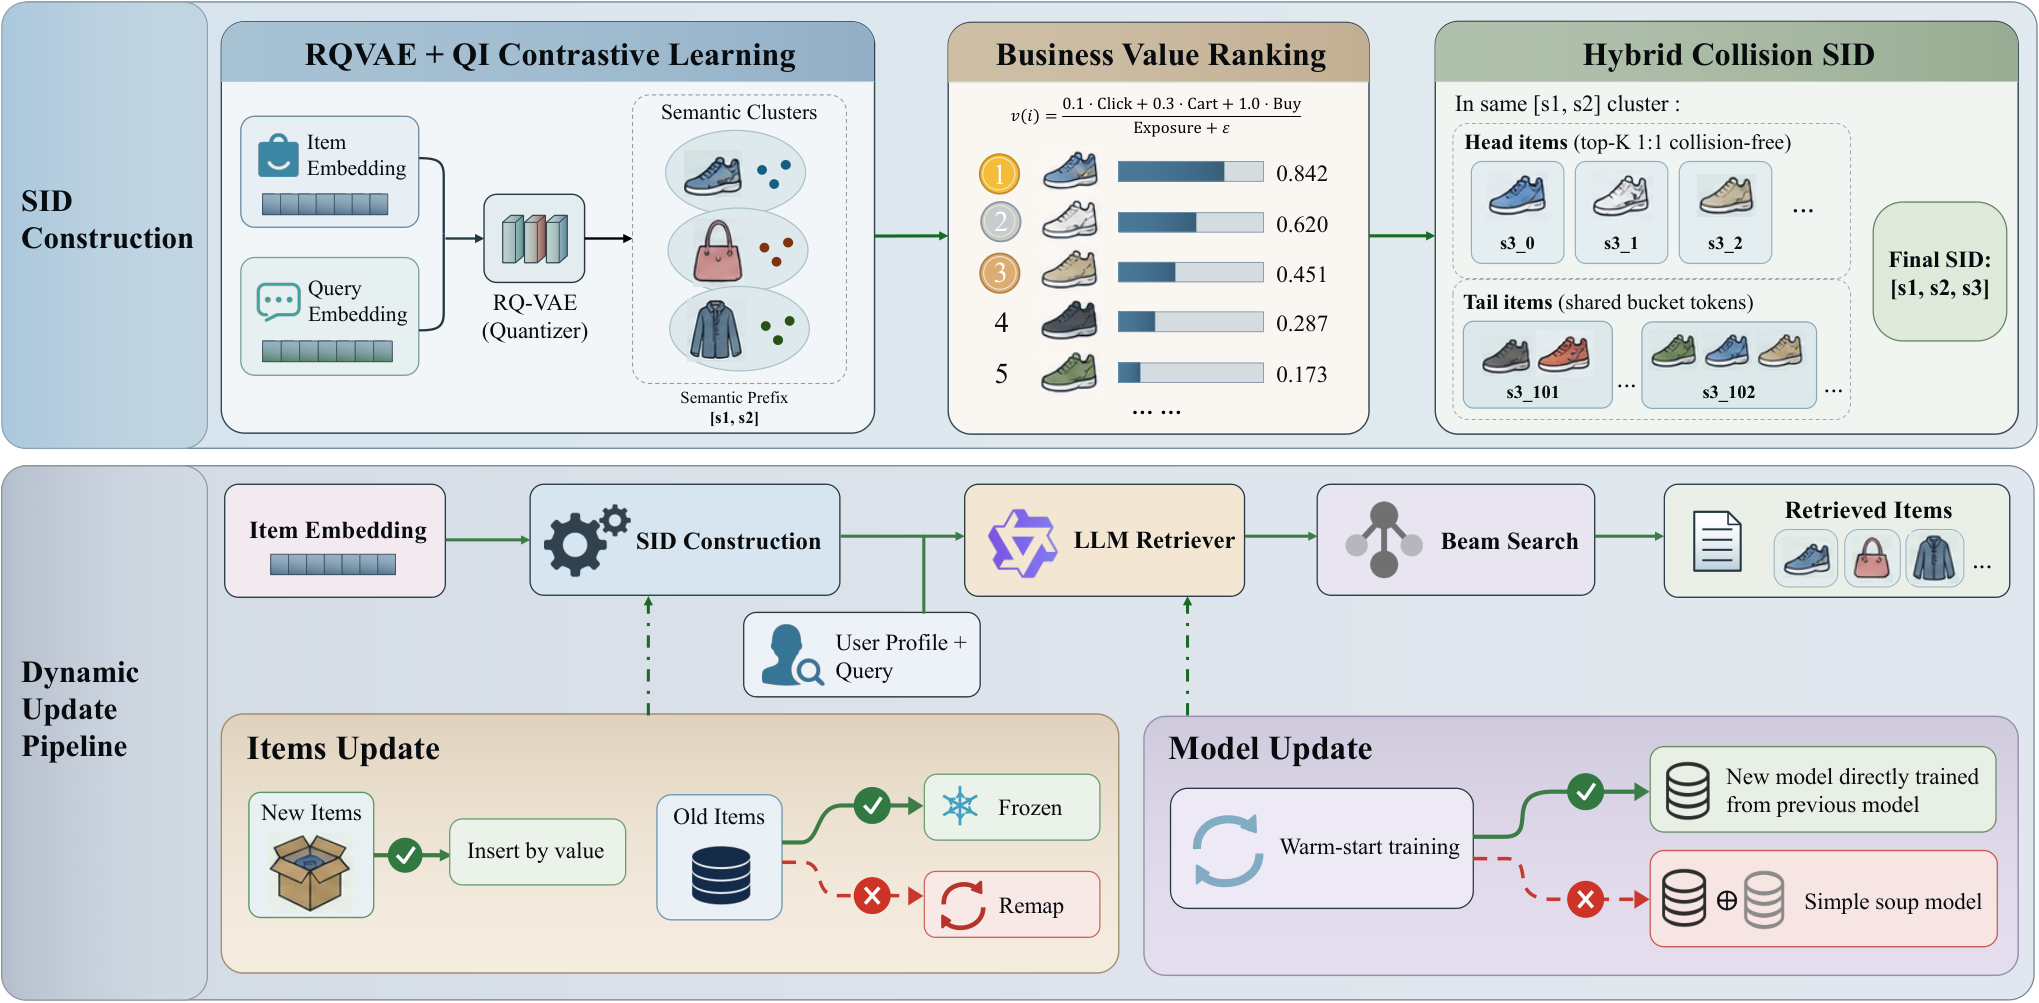
⚙️ 凝练成一条部署原则:新物品插入、旧物品冻结、能从上一版 checkpoint 热启动就热启动,否则直接冻结;绝不动模型已经学过的 SID。而且从旧模型微调出来的新模型,比新旧模型 souping 更管用。
📊 67 天日志受控实验,重映射比例 0%→72.75% 时 HitRate 严格单调下降,beam 1 下最大跌幅 42.66%。
📈 冻结旧物品加插入新物品,旧物品 HitRate 提升约 10%,新物品 HitRate 提升约 109%,并在两个不重叠的更新周期上复现。
✅ TmallAPP 三周线上 A/B:UCTCVR +0.29%,GMV +1.16%。
总结感想:如果你在做生成式检索,且物品库每天在长,这套「只插不改」的策略可以直接抄,落地成本比加对齐模块、加 adapter 低得多。要盯的指标是小 beam 下的 HitRate 和 MRR,别拿 beam 1000 的离线数字下结论。该比较的对手是全量重映射加热启动,不是冻结基线。坑在于:SID 空间会随新物品持续膨胀,碰撞只是被推迟;三 token 的固定长度 SID 能撑多久,论文没给答案,新物品占比升到一定量级后冻结策略的天花板值得先在小流量上压一压。
原文:AlphaXiv