小红书精读:UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence
长序列推荐第三条路,10k序列常数推理
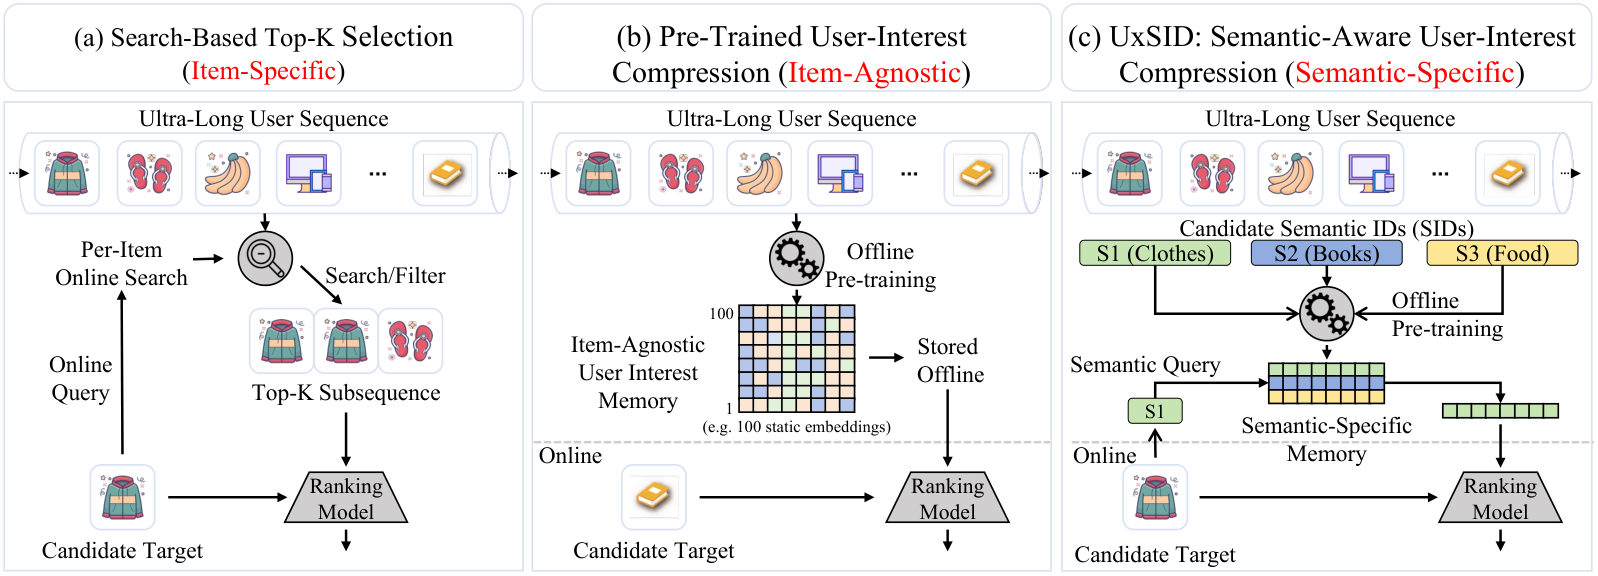
各位算法同学们,长序列建模不一定要在“每个候选都检索一遍”和“压成一坨用户向量”之间二选一。UxSID 走的是中间态:用 Semantic ID 把兴趣压缩成语义组共享的记忆,序列拉到 10k 级别线上仍是常数级推理,广告 A/B 收入涨了 0.337%。
📄 UxSID: Semantic-Aware User Interests Modeling for Ultra-Long Sequence
🔧 第三条路:语义组共享兴趣记忆。既不做 item-specific 的逐候选检索,也不做 item-agnostic 的静态压缩,而是让同一 SID 语义簇下的候选共享同一份压缩后的用户兴趣,保留目标相关性,但只暴露有限信号去引导压缩方向。
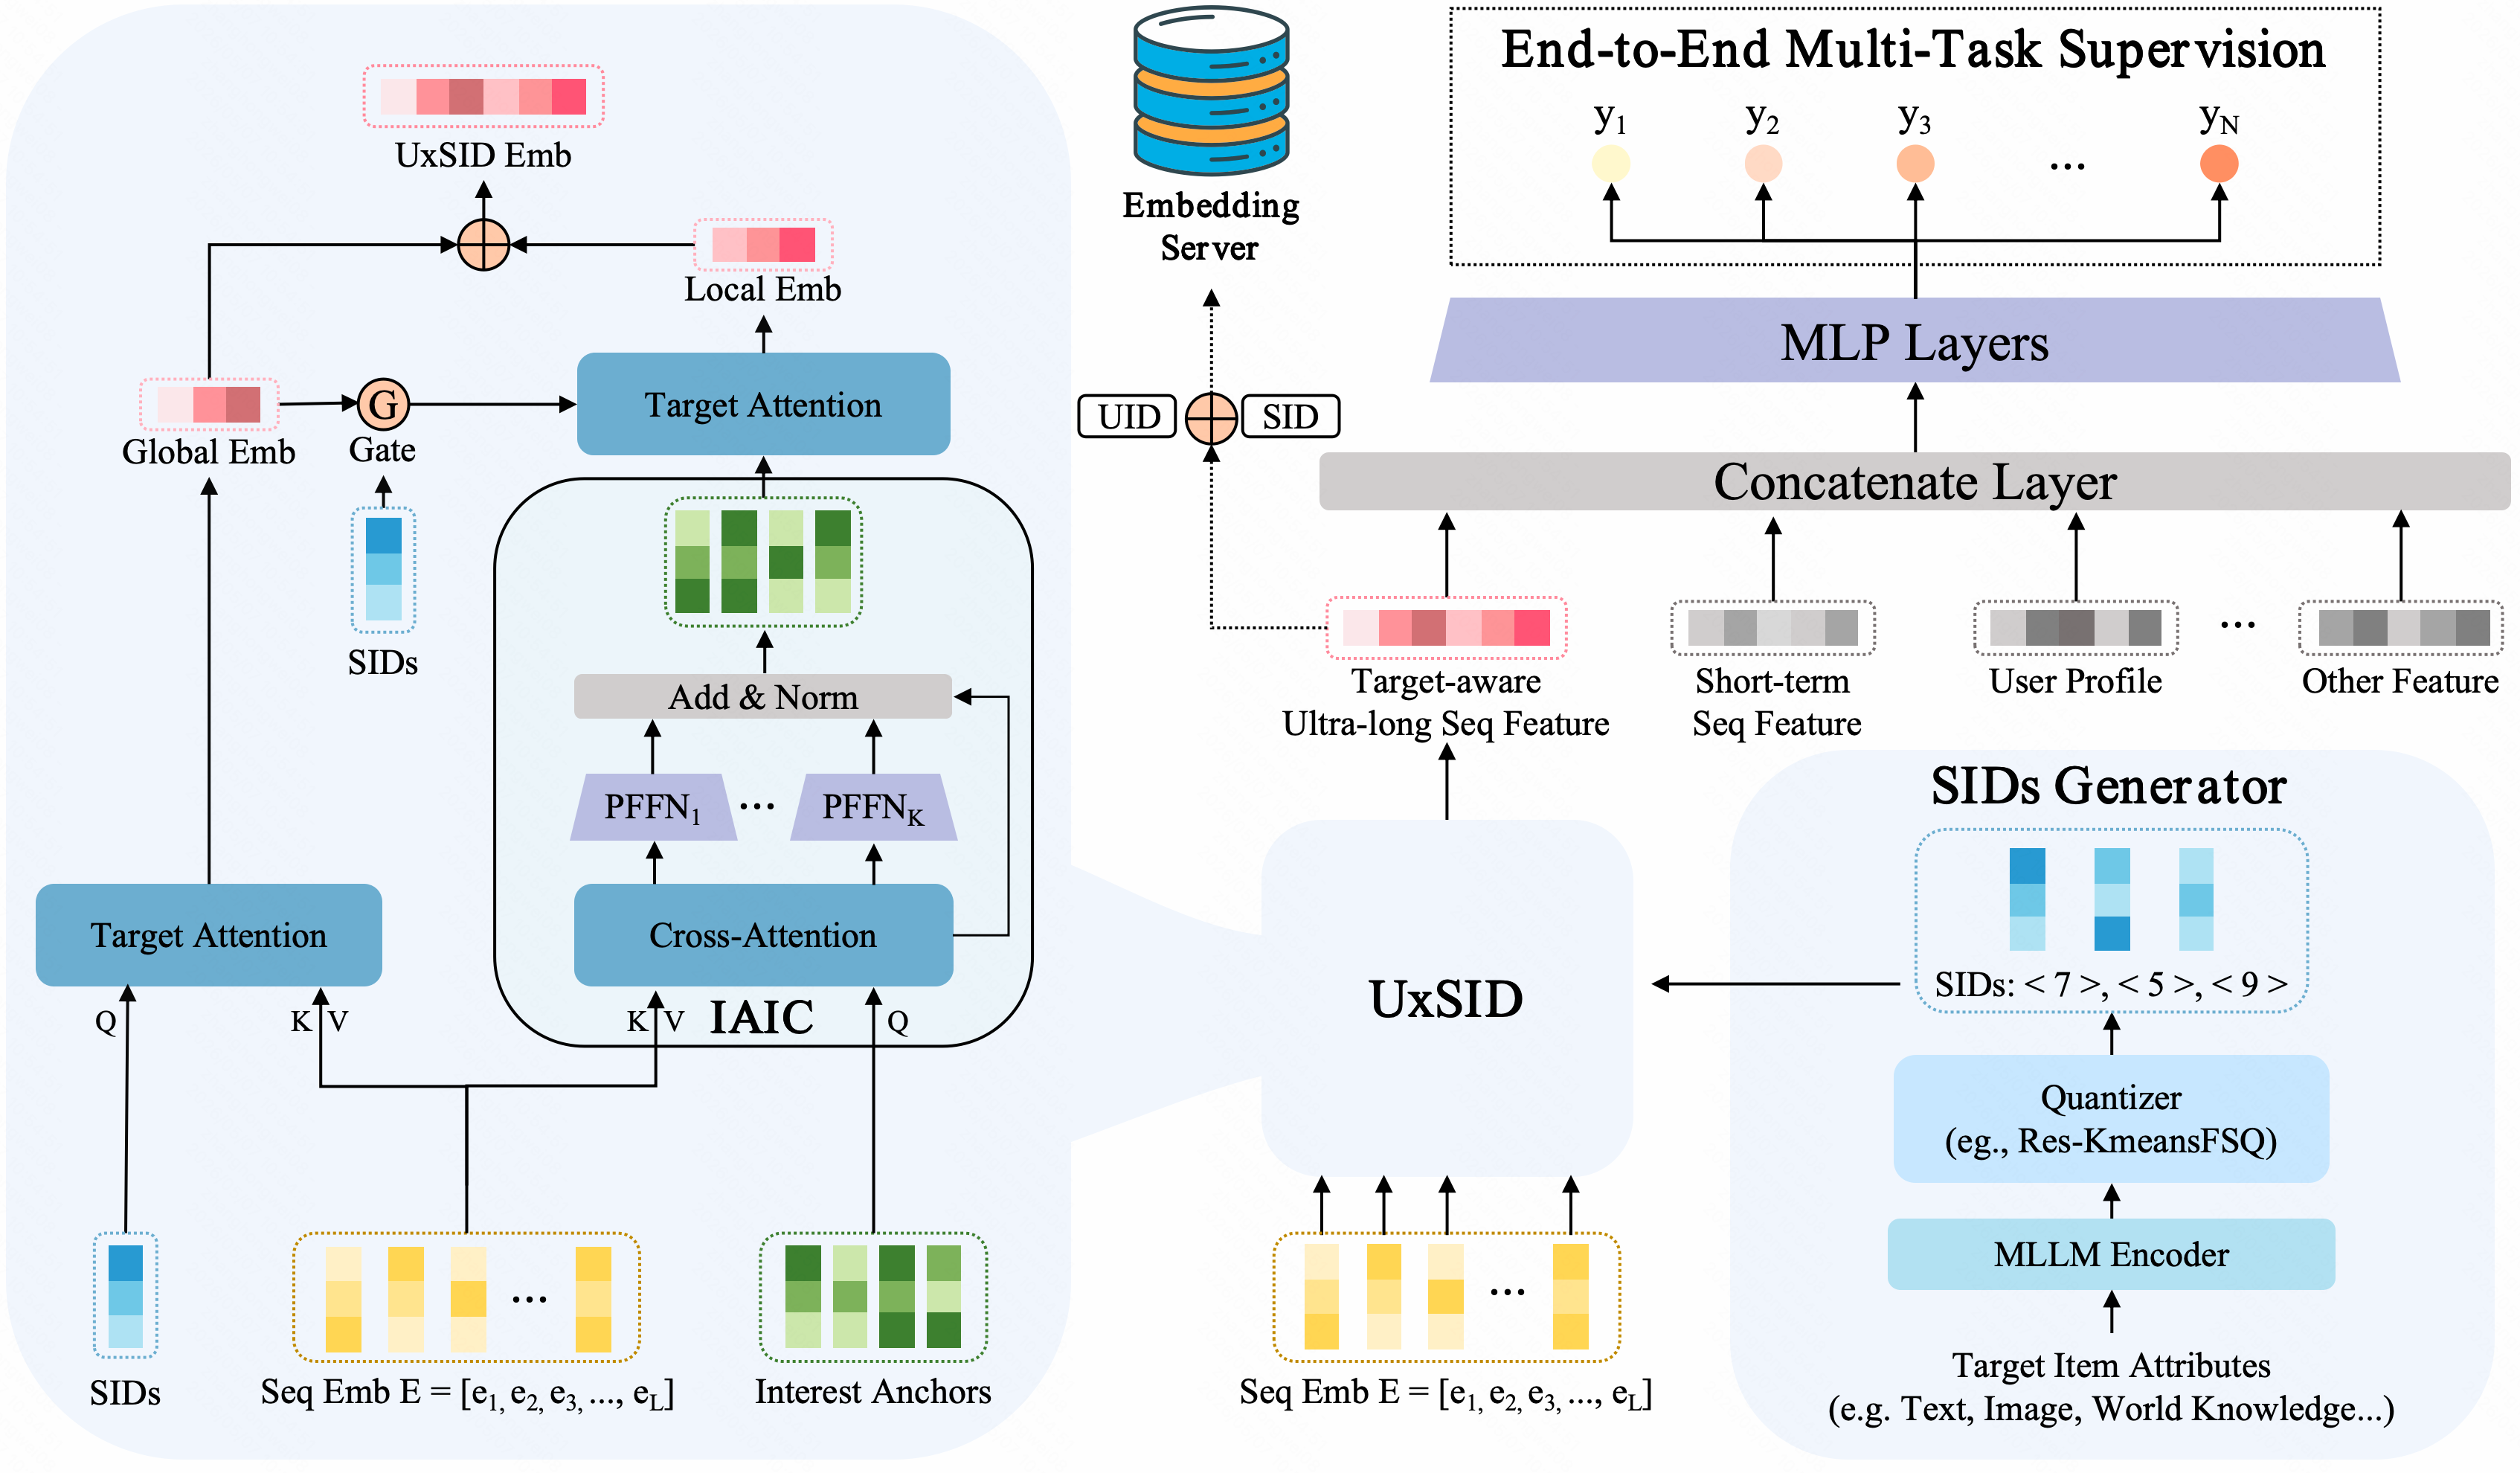
🧩 两级注意力拆成“压缩 + 探测”。IAIC 先把异构历史压成一组可学习兴趣锚点,用 PFFN 加正交约束逼每个锚点抓不同偏好面,防止表征塌缩;分层语义探测再从超长序列抽全局细粒度信号,用门控语义 query 动态融合压缩兴趣,放大目标相关、过滤噪声。
⚙️ 离线 embedding 和线上推理严格对齐,端到端训,不靠特判。
📊 公开 benchmark 上超过 SOTA,对比的是 SIM、TWIN 这类检索派和 MIMN、LURM、C-Former 这类压缩派。
📈 快手大规模线上 A/B,广告收入 +0.337%。
✅ 序列扩到 10k 交互量级,推理时间与资源占用保持常数级,满足了毫秒级延迟约束。
总结一句:这篇主要对做工业推荐、被长序列 serving 延迟卡住的人有用。要盯的不是离线 AUC,而是序列继续往上加时延迟曲线是不是真的平;另外 SID 质量基本决定上限,RQ-VAE 那套量化如果和业务语义对不齐,压缩出来的兴趣记忆可能只是换个方式丢信息。
原文:AlphaXiv