小红书精读:RecToolBench: Benchmarking Recommendation-Specific Tool Orchestration under Fuzzy User Intent
工具调用成功,推荐就对吗?🤔
各位算法同学们,先抛个反常识结论:工具调用的语法全对,最后推出来的东西照样可能是错的。这篇工作把”模糊意图下的工具编排”单独拎出来做成了 benchmark,戳的正是现在 agentic recommender 评测偏乐观的那块——老榜单要么假设用户把需求说得很清楚,要么只测单次函数调用。
📄 RecToolBench: Benchmarking Recommendation-Specific Tool Orchestration under Fuzzy User Intent
🔧 基于 MCP 搭了 13 个 server、32 个工具,覆盖商品、餐饮、位置三个场景,能力包括检索、评论情感、评分过滤、排序、地理推理、网页搜索,调用 schema 统一,换模型能直接跑。
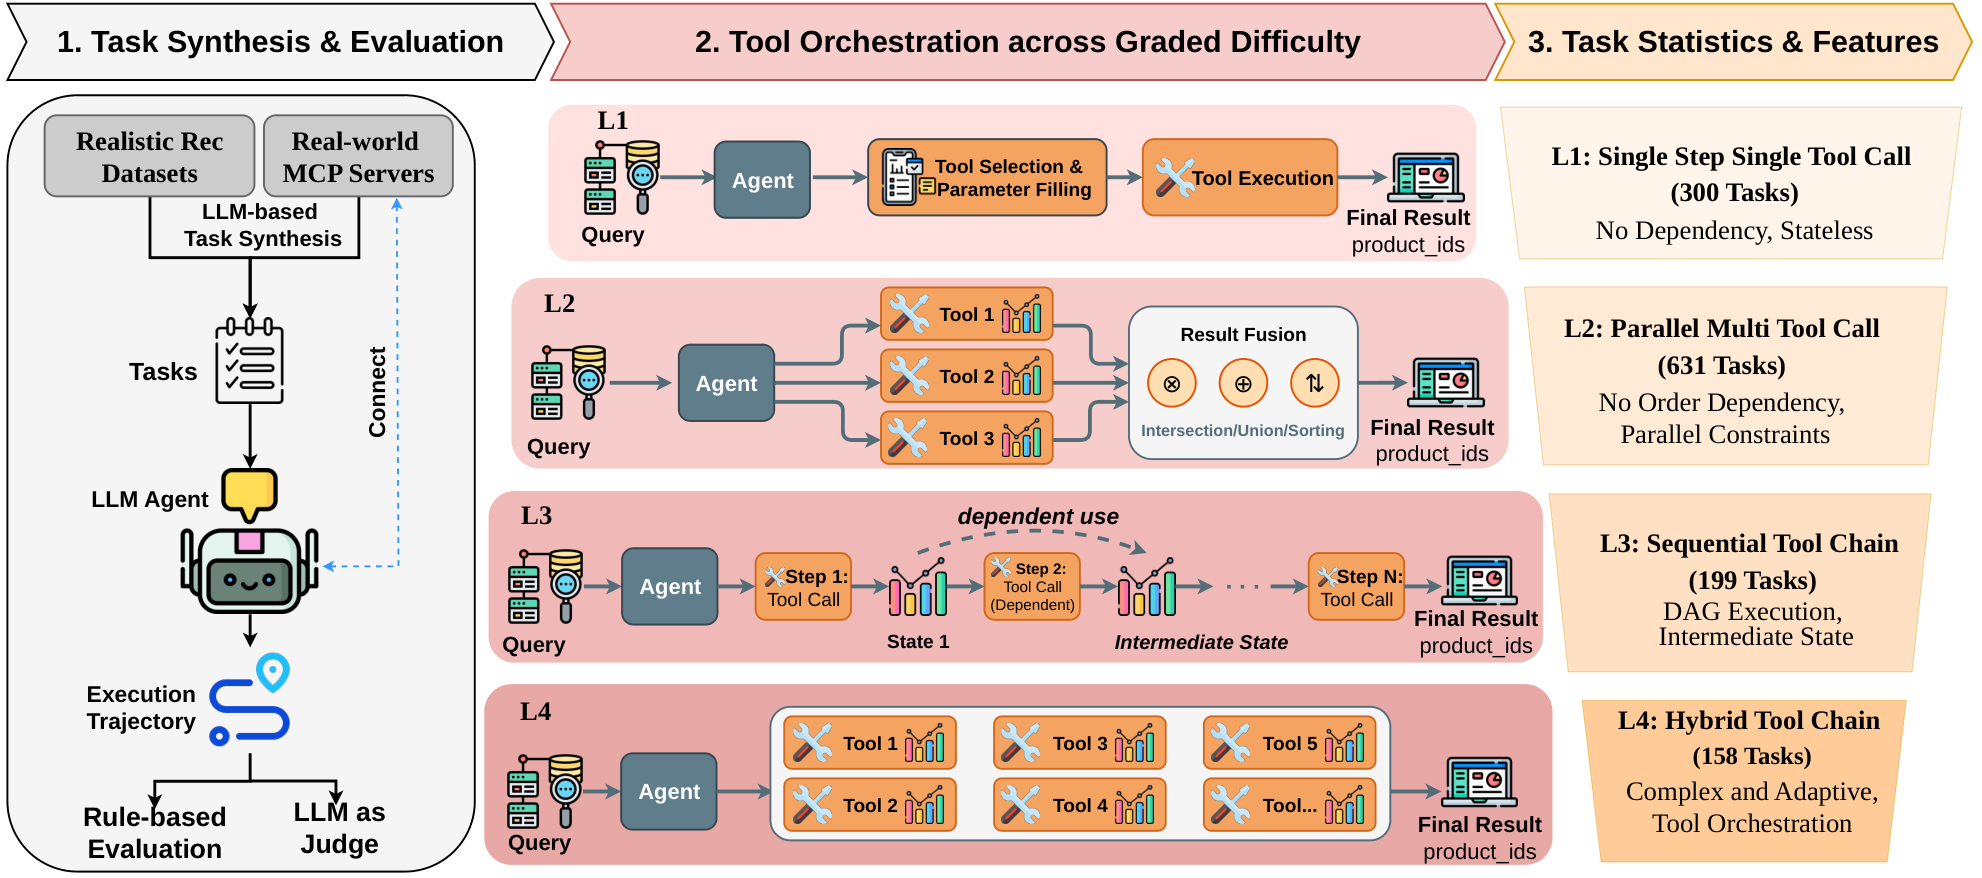
🧩 任务按四级难度递进:L1 单工具、L2 并行多工具、L3 串行依赖链、L4 混合编排,重点考中间状态能不能跨步骤传递。
⚙️ 构造走 synthesize–fuzzify–judge 流水线:先生成明确意图的任务,再按欠指定、软矛盾、模糊量化词、偏好不确定、隐式约束五类方式抹掉工具名和步骤提示,最后过滤可解性与歧义合理性;评测同时用规则检查执行正确性和 LLM rubric 打 grounding 分。
📊 1288 个任务:L1 300、L2 631、L3 199、L4 158,分布为 Amazon 675、Yelp 465、Foursquare 148。
📈 L1 上小模型调用格式合法,但工具选错、参数填错。
✅ L2、L3 里 schema 合规率依然很高,参数落地、并行拆解、依赖追踪却明显跟不上。
🧠 L4 反差最大:规则分不低,Hit Ratio 和 grounding 分数掉得厉害,执行成功和推荐正确之间有一条稳定的沟。
总结:如果你在做 agentic 推荐或工具调用评测,这个集子比通用 tool-use 榜单更贴推荐场景,适合当回归测试集用。坑在于模糊化和 rubric 打分都留了主观空间,任务分布也不均衡。实际用的时候盯三个指标就行——参数落地准确率、串行链路里的中间状态传递、最终 Hit Ratio,别被”调用成功”这个数字骗过去。
原文:AlphaXiv