小红书精读:H2CE: Modeling Geo-Semantic Interactions for POI Reranking with Heterogeneous Two-Stage Cross-Encoders
别急着上LLM:POI重排提22个点🔍
各位算法同学们,先说个反直觉的:在本地搜索的POI重排里,一个零样本LLM重排器被一个两阶段cross-encoder拉开了35.89个点。这篇CIKM’26论文讨论的正是”距离近但语义不太对”和”语义准但远一点”这类用标量加权解决不了的排序问题。
📄 H2CE: Modeling Geo-Semantic Interactions for POI Reranking with Heterogeneous Two-Stage Cross-Encoders
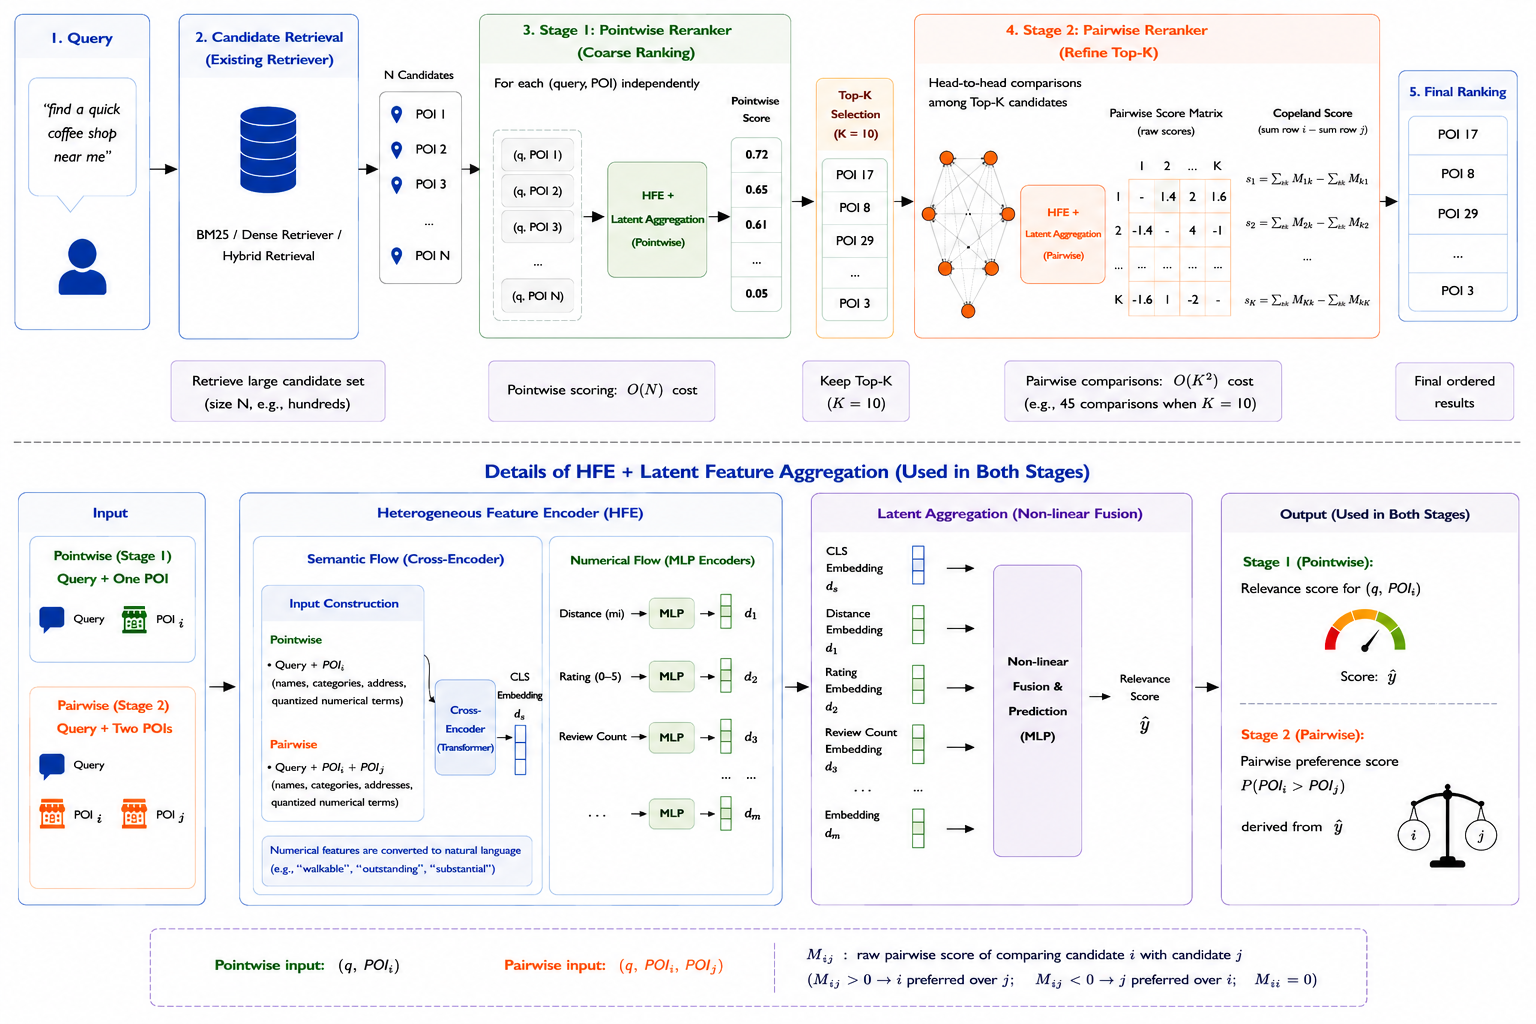
🔧 数值属性走两条路:分桶后的自然语言描述(walkable、near、excellent)塞进cross-encoder输入,让attention能对”近”“好吃”这类粗粒度概念做条件化匹配;精确标量交给专用MLP,保住数值大小信息不被分桶抹平。
🧩 融合不再是语义分和数值分的加权和,而是把CLS向量和数值embedding在隐空间做聚合,非线性交互因此能表达”走路距离类query距离权重大、best类query评分权重大”。
⚙️ 两阶段:Stage1对全部候选pointwise打分做粗排过滤,Stage2只对top-K做两两对比,用Copeland聚合出最终顺序,pairwise成本从O(N²)压到O(N+K(K-1)),论文里K取10。
📊 5,743条query的本地搜索测试集上,NDCG@5达到67.48%,比XGBoost LTR绝对提升+22.82%。
📈 比零样本LLM重排器RankGPT高+35.89%,比做过本地搜索微调的BGE reranker高+9.62%。
✅ RDQ@5为60.77%,比XGBoost绝对+20.96%;只看pairwise阶段,比纯pointwise版本再涨+1.98% NDCG@5。
🧪 消融覆盖数值特征、隐空间聚合、top-K pairwise和对齐训练,这几块都不是装饰。
总结一句:如果你在做本地搜索或重排、又卡在延迟预算上,这套”语义+数值双通道、top-K两两比较”的结构可以照着搭,但要盯两件事——K太小的话Stage1漏掉的好候选Stage2救不回来,分桶边界也得按自己业务的距离分布重调。另外它的基准是XGBoost和微调BGE,不是最强LLM listwise,别把结论外推太多。
原文:AlphaXiv