小红书精读:Language Models for Page-Level Layout Decisions in E-commerce Search
LLM评页面布局,打不过浅层模型🤔
各位算法同学们,如果我说“让7B大模型当裁判,判断搜索页这个位置要不要塞一个横向carousel,结果输给了一个拿embedding喂浅层分类器的做法”,你信吗?这篇来自Walmart Global Tech和UIUC的工作,第一次把“页面级布局决策”的离线评估做成了统一对比基准,结论跟当下LLM-as-judge的热度有点反着来。
📄 Language Models for Page-Level Layout Decisions in E-commerce Search
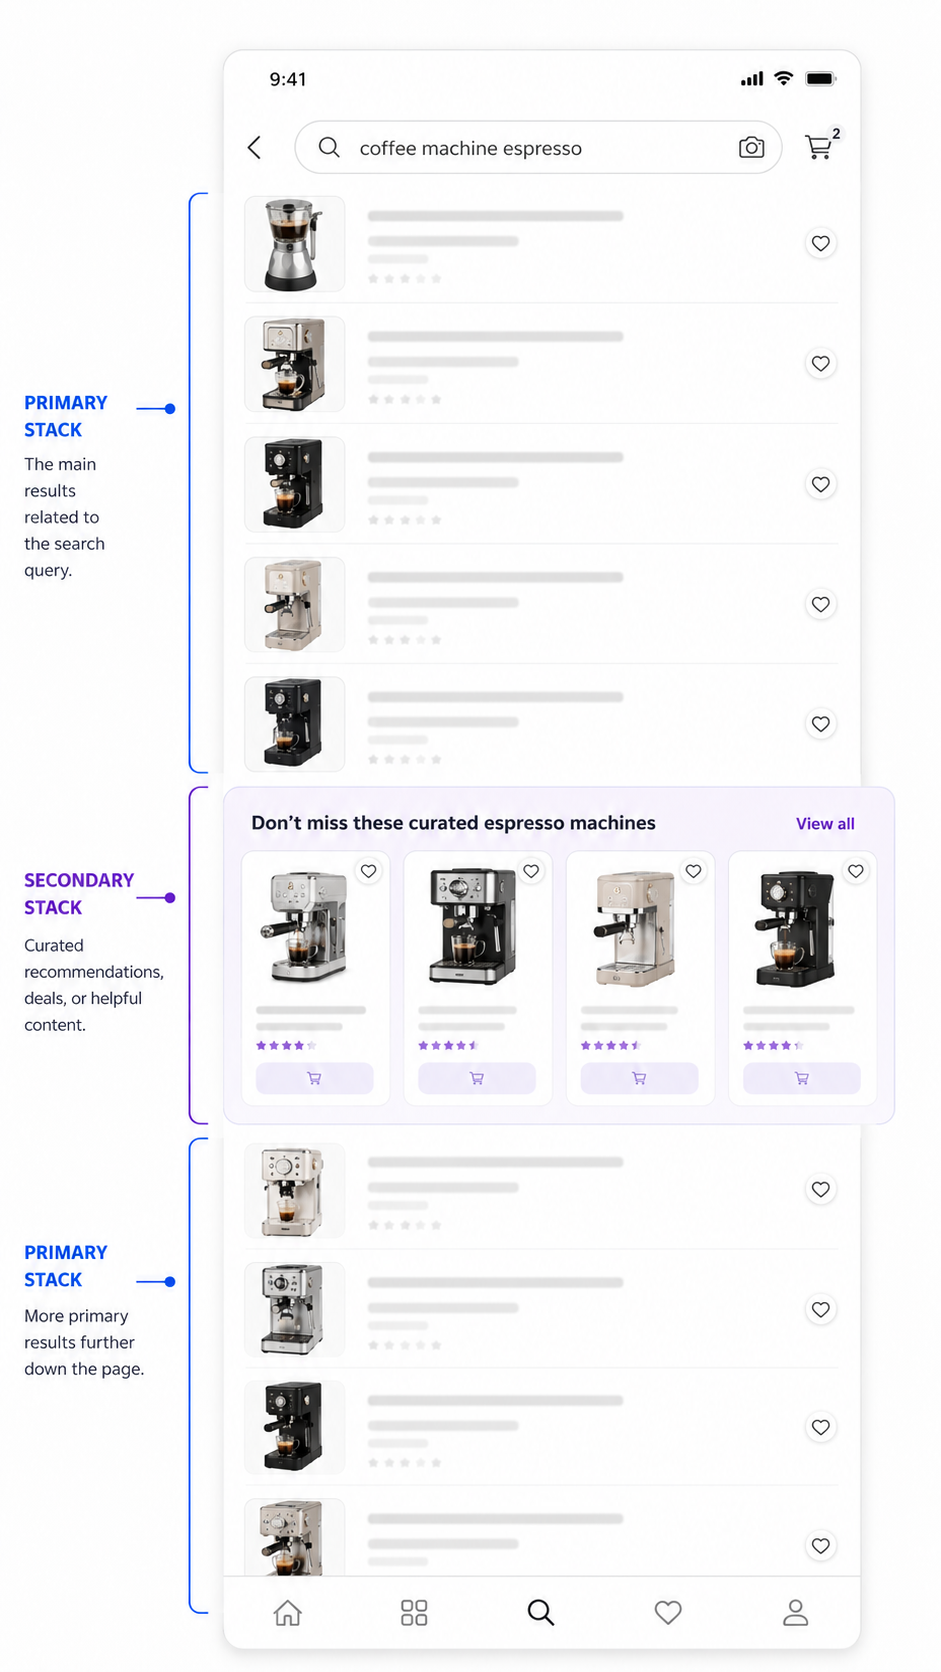
🔧 把“布局决策”形式化成二分类:给定query、主结果列表P、候选secondary stack S和插入位置i,模型只回答“加S更好(1)”还是“不加更好(0)”,监督信号直接取历史日志里的Add-to-Cart,绕开了传统排序评估里interleaving那套成熟工具的缺失。
🧩 标签构造挺讲究:假设用户自上而下滚动,所以只看stack位置及以下主结果的ATC;用户既没点stack、下方主结果也没加购的会话直接丢弃,因为无法确认他真的滑过了这个模块,这样正负样本都对应“确实见过stack”的会话。
⚙️ 三类方法同一套标签、同一数据划分硬碰硬:Mistral-7B-Instruct直接prompt判分、prompt派生特征喂轻量分类器、ModernBERT编码页面上下文再挂浅层预测。其中PDJ变体还把判断拆成6条判据(意图对齐、商品相关性、品牌热度、价值对齐、与主结果重复、打断成本),每条3分制打分,想模仿思维链的效果。
📊 摘要给出的核心结论:representation-based方法在预测用户engagement上一致优于prompt-based判断。
📈 同一份页面上下文,取文本编码器的表征再训个浅模型,比让LLM直接吐0/1和分数更稳——说明这类带UI约束、带滚动成本的任务,LLM的“直觉推理”不一定接得住。
✅ 但论文摘要里没给具体提升幅度,要判断能不能上生产,得回正文看指标口径、label正负比例,以及换一个engagement信号(比如点击而非ATC)结论是否还成立。
总结一下:做电商或内容平台、想改页面模块位置又不想每次都开AB的人可以看,思路是把“离线筛布局”当成有监督预测,而不是让LLM写评语。要盯的坑有两个:标签完全绑定ATC的定义,换指标大概率要重训;而且它只能帮你排掉明显差的布局,别指望替代线上AB,顶多把候选从100个压到10个。至于LLM-as-judge,至少在这个任务上,暂时不是最优解。
原文:AlphaXiv