小红书精读:LoopFM: Learning frOm HistOrical RePresentations of Foundation Model for Recommendation
知识蒸馏传标量不够?FM改传序列
各位算法同学们,把一个万亿参数的 FM 压成一个标量 soft label 去带 VM,这条路在参数量差到三个数量级时已经不太够用了:teacher 越强,能被那个数字带过去的比例反而越低。这篇想干的事就是给蒸馏换一条带宽更宽的通道。
📄 LoopFM: Learning frOm HistOrical RePresentations of Foundation Model for Recommendation
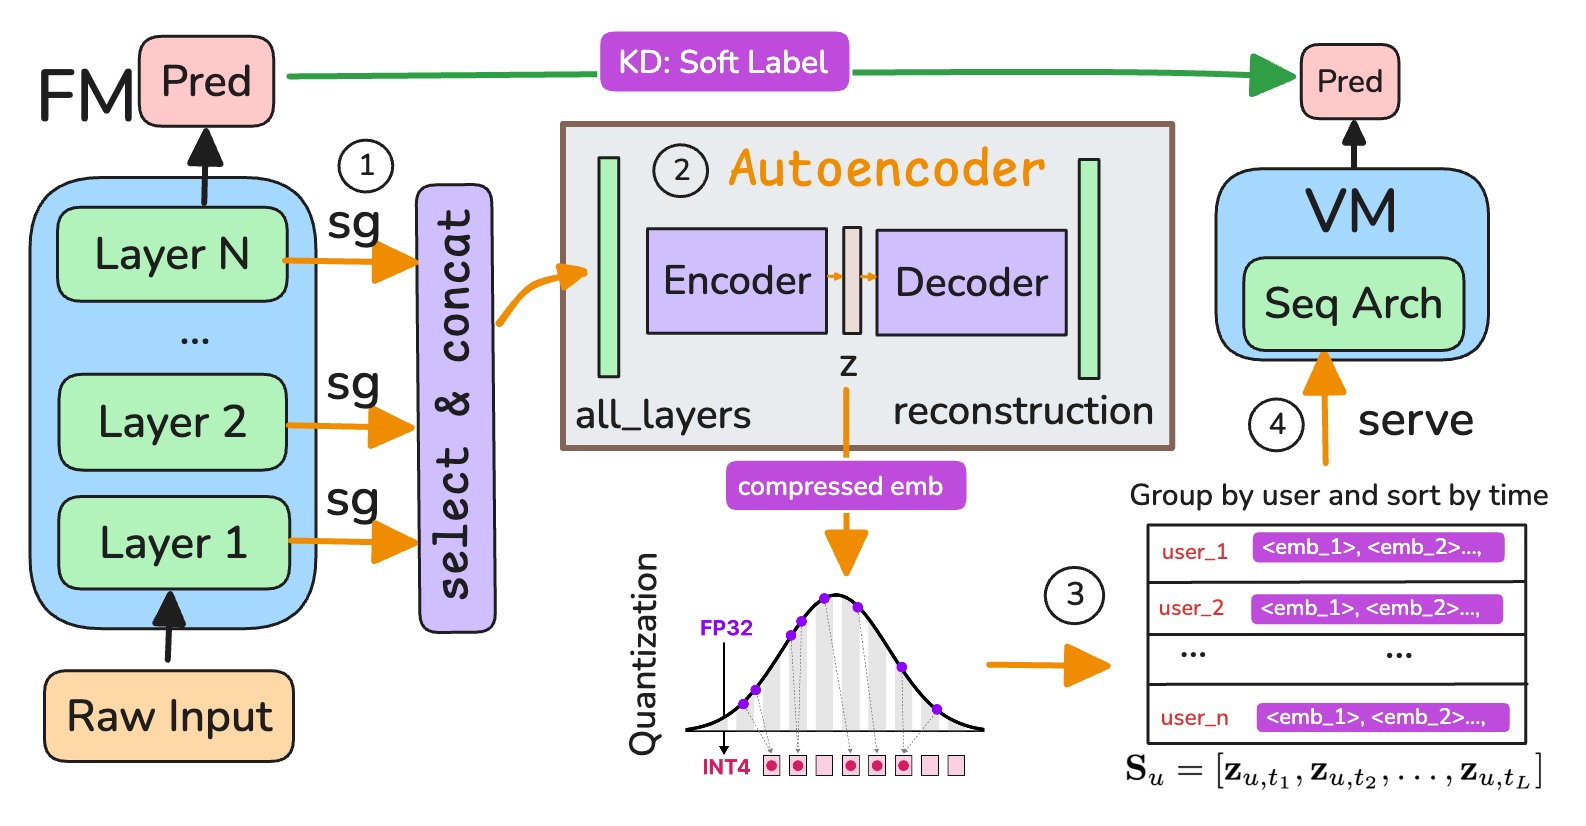
🔧 不走辅助 loss 去对齐当前样本的隐层,而是把 FM 的中间 embedding 离线抽出来、压缩、按 key(论文里是 user)分组成历史序列,直接当 VM 的输入特征。推理时不用实时跑 FM,也不要求和 FM 做架构耦合。
🧩 压缩是和 FM 一起训的自编码器,输出接 tanh 后做 INT4 量化,存储比 FP16 省 4 倍;还用 Matryoshka 式训练,任意前缀维度都算有效表示,部署时能按维度调效果和成本的平衡。
⚙️ 理论上把增益拆成三项:用户历史时序信息 + FM 跨特征带来的信息 − 压缩损失。transfer ratio 的下界随 FM 与 VM 的特征差变大而升高,压缩越好下界越紧,另外序列变长信息增益不下降。
📊 三个公开集:TaobaoAd 平均 +6.4% AUC(区间 +6.1~6.6%),KuaiVideo 平均 +1.0%,Amazon 平均 +0.5%。
📈 工业规模(十亿级样本、万亿参数 FM)上,在已有 KD 之上把知识迁移率大约翻倍。
✅ 线上转化:首次上线前半段 +0.5%,后半段两次独立上线分别 +1.03% 和 +1.22%。
🧭 序列长度、embedding 维度、上游 FM 规模上都出现了 scaling law,维度那一条的前提是下游 encoder 容量够。
我的判断:这套东西和 KD 是互补关系,不是替代,而且它把收益来源解释得比我见过的多数蒸馏工作清楚。坑也明显——离线抽取、存储、序列编码都带额外工程和延迟开销,embedding 维度加太猛但下游 encoder 撑不住就是白白烧存储。如果你在做两阶段推荐、teacher 已经大到 KD 收益越来越薄,建议盯两个指标:transfer ratio 有没有真的抬起来,以及压缩后相比原始 embedding 的 AUC 掉了多少;只报前者不报后者就得留个心眼。
原文:AlphaXiv