小红书精读:Optimizing Effective Training Time for Large-Scale Recommendation Systems
推荐训练40%的GPU时间在空转
各位算法同学们,你们以为训练慢是算子没调好?Meta 广告推荐最大的训练作业,端到端墙钟里只有 50-60% 真的在吃新数据,剩下 40% 花在初始化、编译、checkpoint、故障恢复上。这篇就是把这段隐形损耗拆开、逐项优化的工作。
📄 Optimizing Effective Training Time for Large-Scale Recommendation Systems
🔧 提出 ETT%:端到端墙钟里真正推进数据 cursor 的比例,写成 1 − (TTS + NoF×TTR)/总墙钟。它比 MFU 多覆盖训练循环之外,比 Goodput 多一层归因。
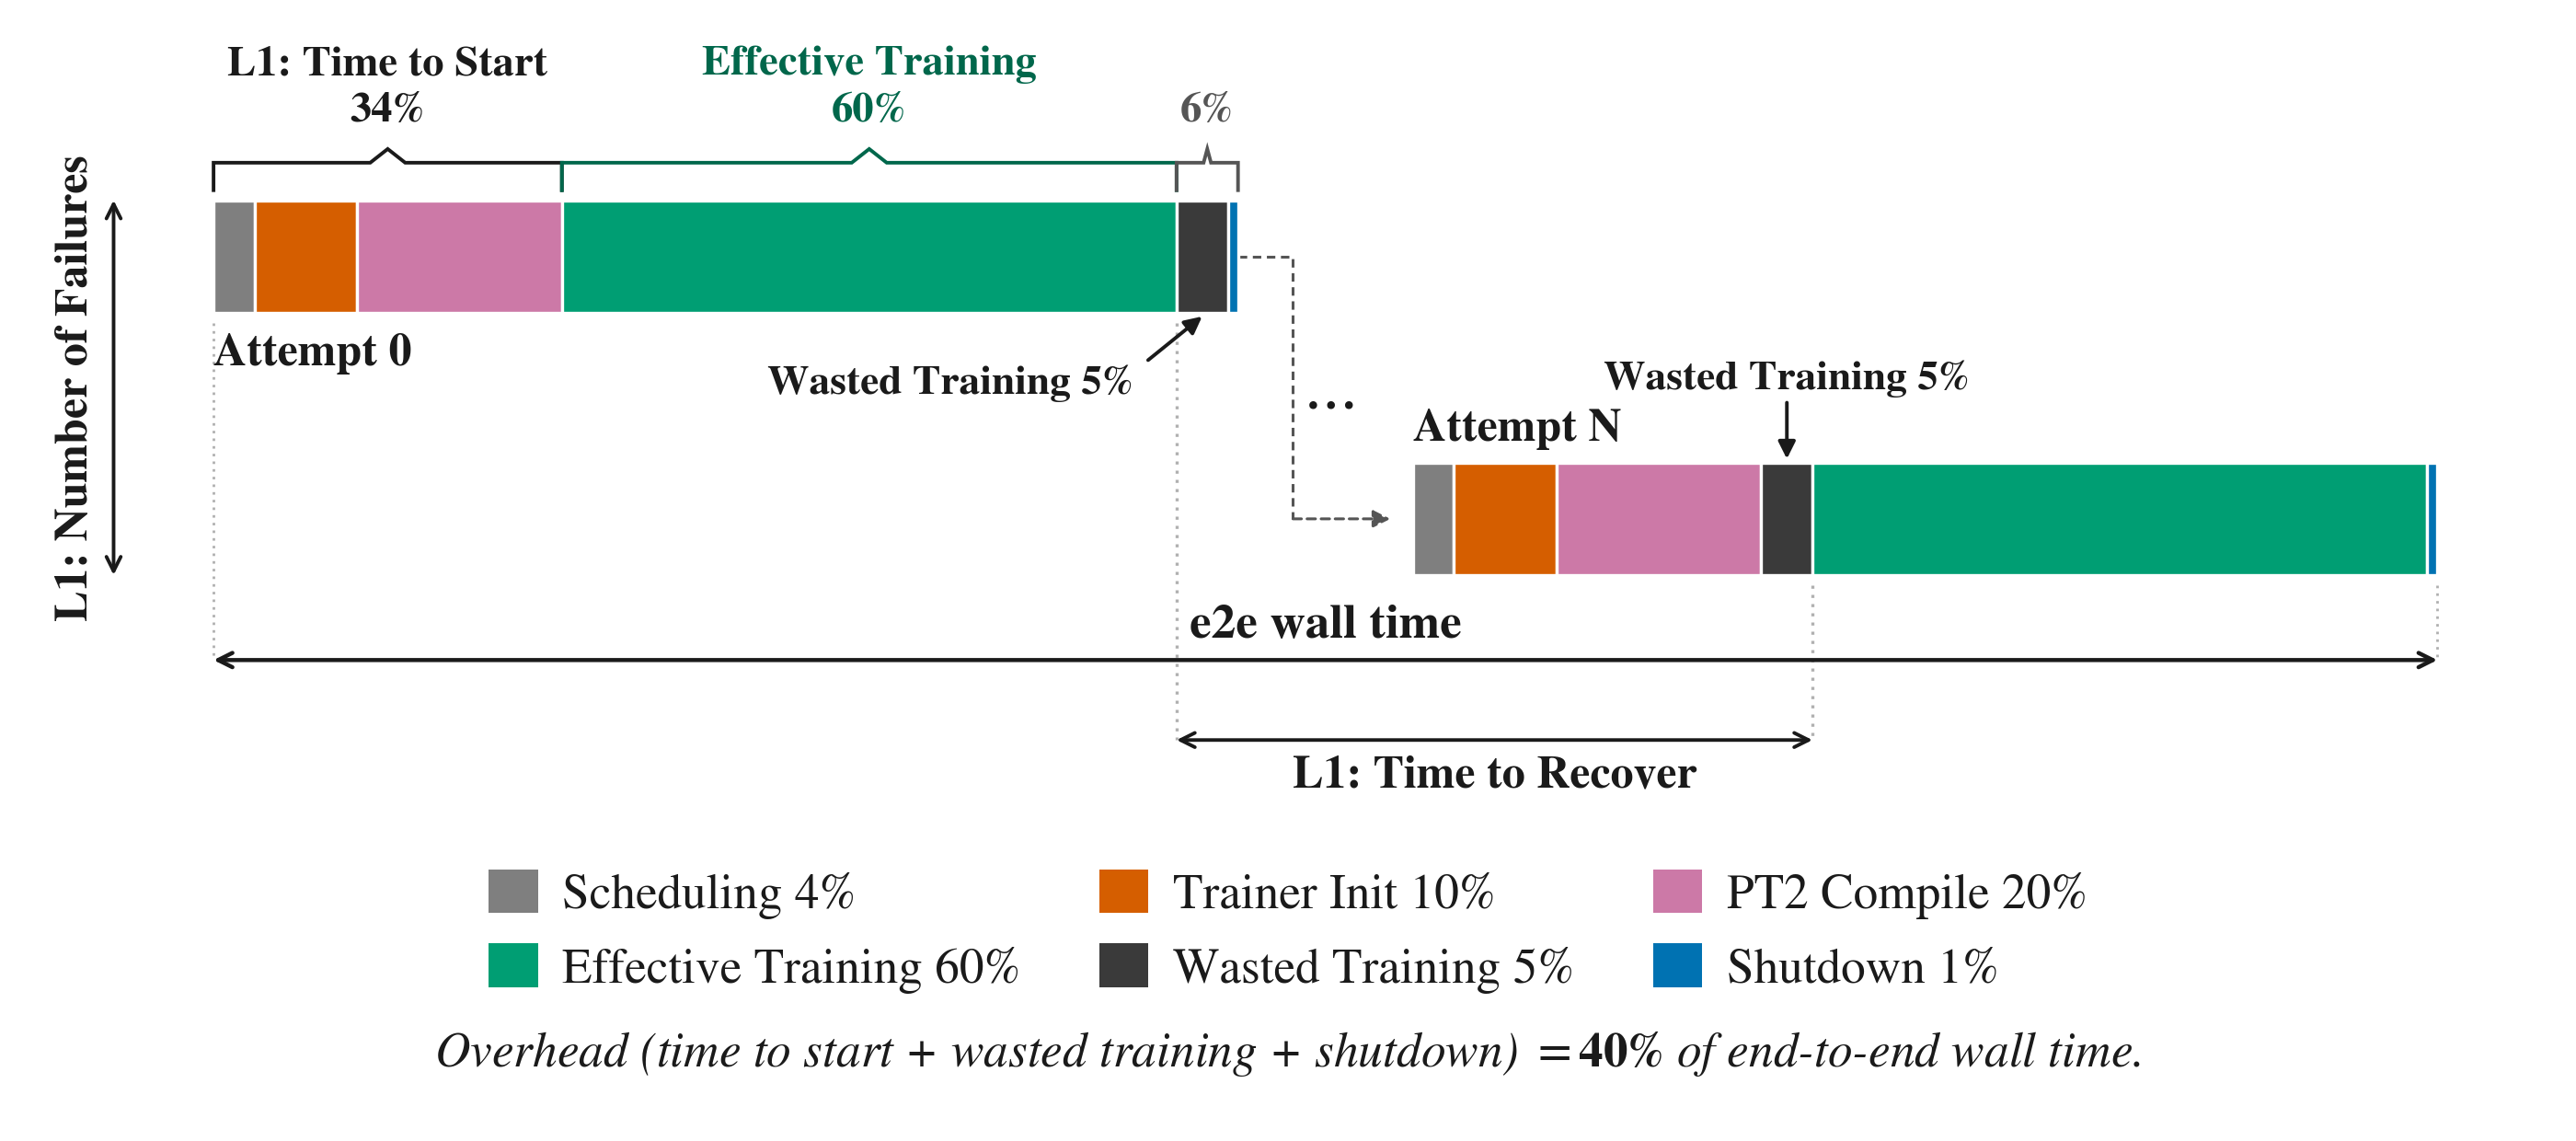
🧩 两级分解:L1 是 TTS、TTR、失败次数;L2 拆成调度、Trainer 初始化、PT2 编译、有效训练、无效训练、shutdown 六项,每项绑定一个系统和一个负责团队。指标跌了以后能直接问到人。
⚙️ 优化集中在初始化(通信消除、流水线重叠)、PT2 编译(动态 shape 处理、autotune 剪枝、可复用编译缓存)、异步 checkpoint、模型独立发布和恢复降本。方法本身都是成熟货,新意在选哪个、怎么算端到端收益、怎么别把收益还回去。
📊 7 个推荐模型、H100、8 到 2000 GPU;6 组配对实验里 ETT% 平均提升 15.5 个百分点,基线 59–85% 提到 80–93%。
📈 最大的作业 ETT% 打到 85%,全集群部署后从约 80% 升到 90% 以上。
✅ 恢复路径的优化贡献了总节省时间的 58%;TTR 的下降是 TTS 下降的 1.8–8.6 倍,因为重启会重做一遍启动阶段的活。
🔍 单个 128 GPU 作业的实测分解:151.5 分钟里有效训练 90 分钟,PT2 编译独占 30 分钟,Trainer 初始化 15 分钟。
判断:值得跟的是指标怎么拆、怎么归到具体团队,不是那些优化手段本身。如果你们在做日级刷新的推荐或排序训练,作业短、重启频繁,这套账本可以直接抄。两个坑:L2 埋点必须打在准确的阶段边界上,否则归因还是会变成跨团队扯皮;另外别只盯 TTS,重启会重复启动阶段的活儿,先压 TTR 收益更大。如果你们是几周长跑的 LLM 预训练,冷启动摊薄到 0.2%,这套优先级不适用。
原文:AlphaXiv