小红书精读:Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS)
🧩语义ID不是表示学习,而是递归聚类
各位算法同学们,语义ID(SID)这块的默认思路一直是“把item编码成向量再量化成码”,但换个问法它其实是个递归聚类问题——要聚的不是孤立item,而是一张节点带语义、边带协同信号的图。这篇华为爱尔兰研究中心的 GrIS 把这层窗户纸捅破了,顺手把 RQ-VAE 这类主流方法收编成“图是空的”退化特例,所以它不是在推翻谁,而是把设计空间重新摊开。
📄 Neither Black nor White: Balancing Semantic and Collaborative Signals with Graph-Informed Semantic IDs (GrIS)
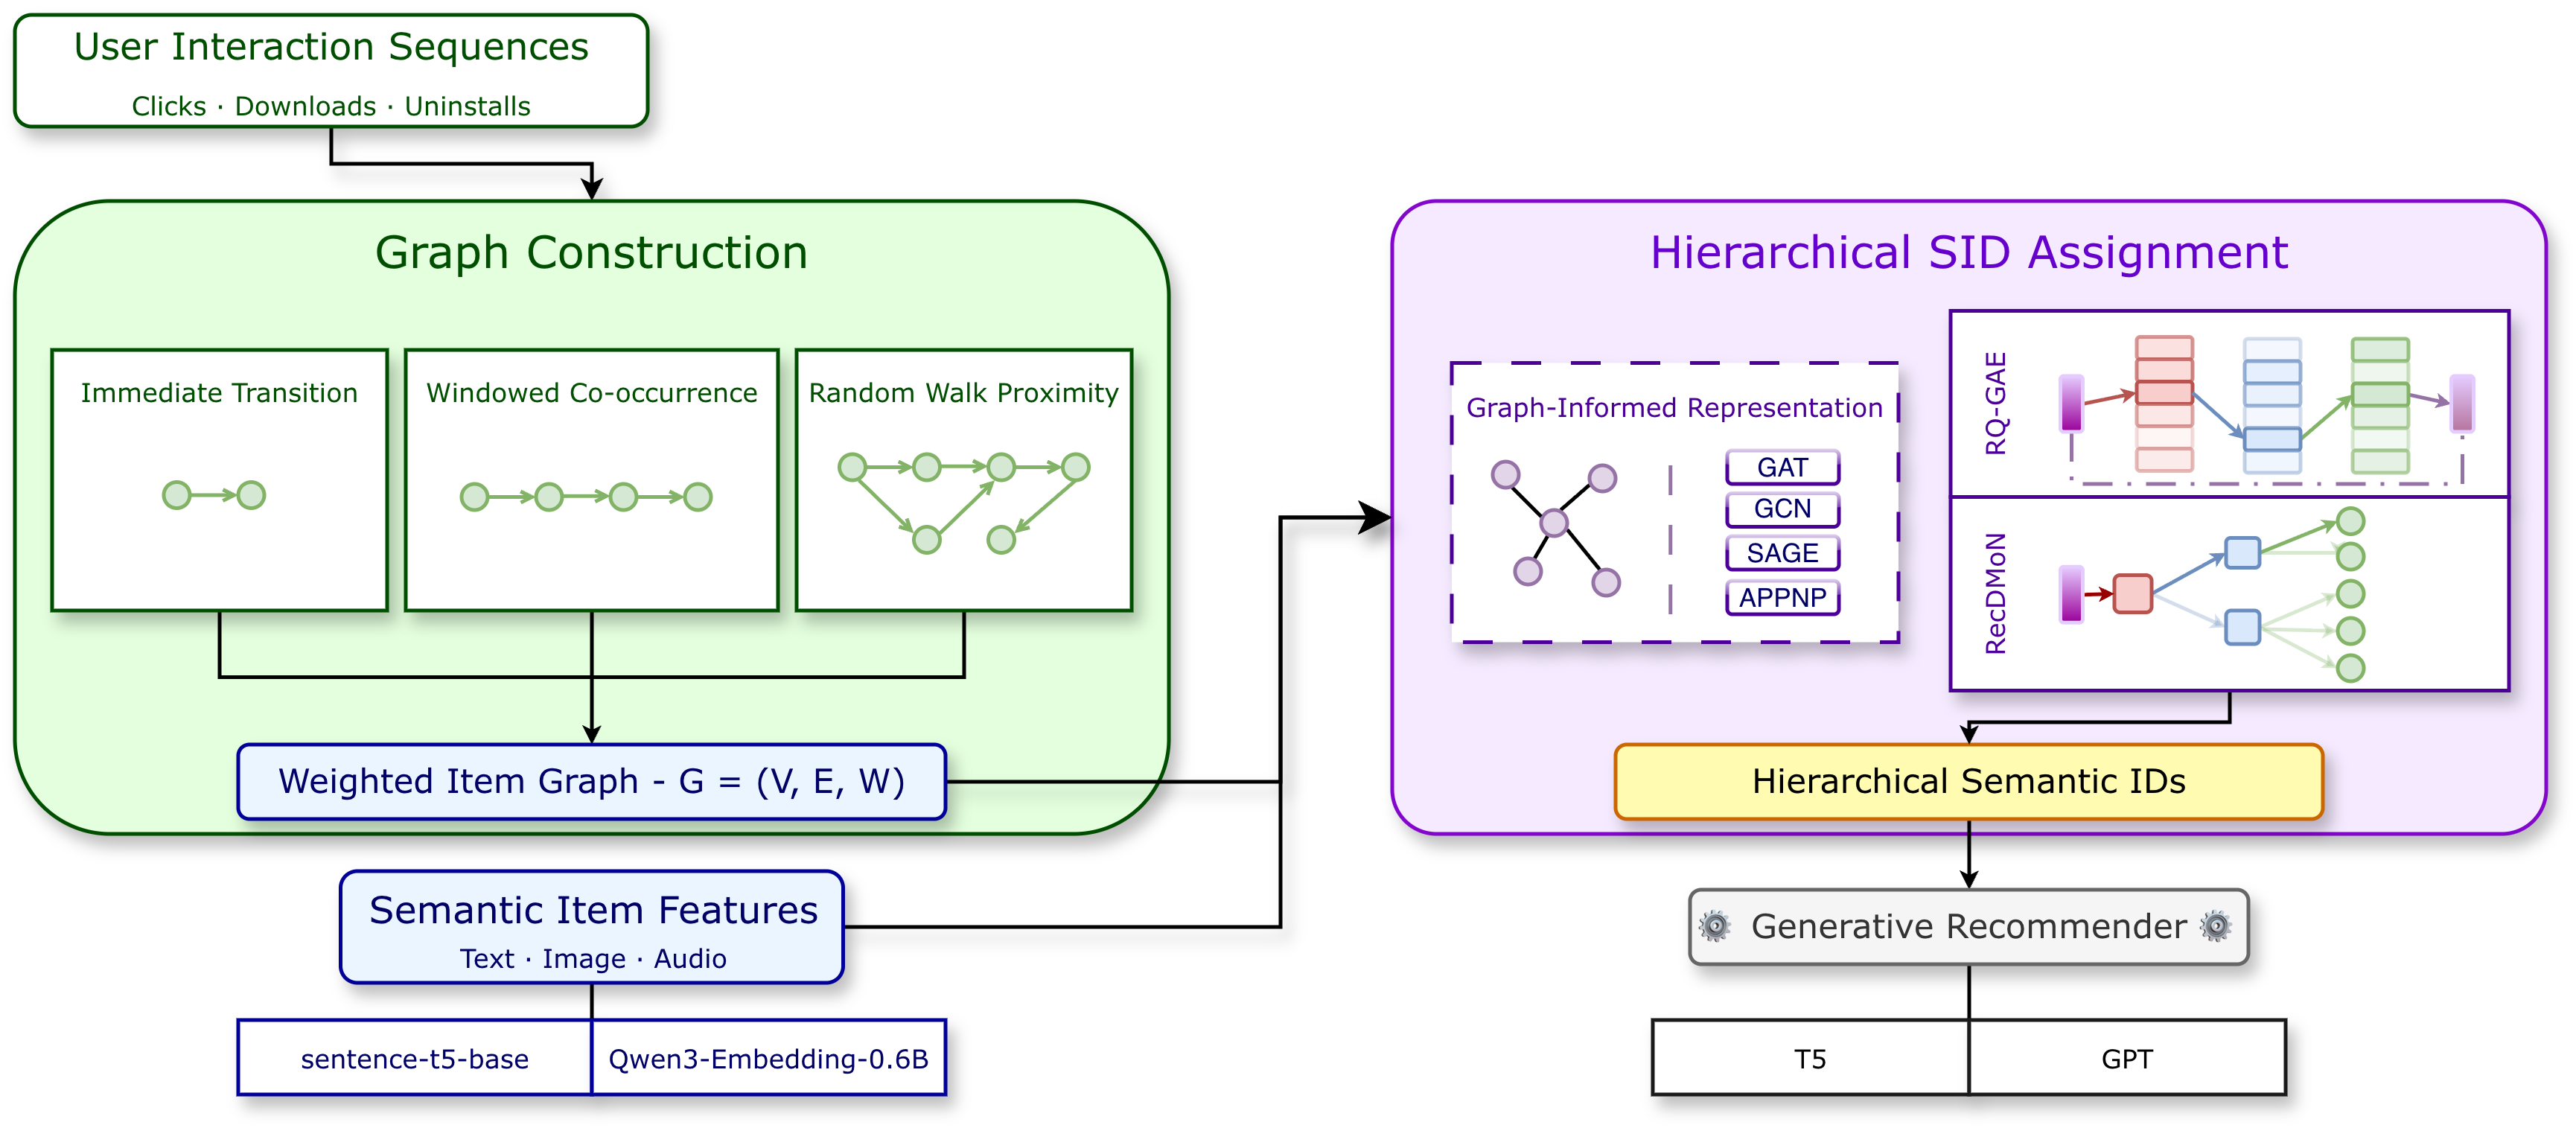
🔧 把 SID 构造重新定义成层次图划分:节点带内容语义,边带协同信号,分配 SID 就是递归地切这张图;内容和协同谁占主导,由图和划分算法共同决定,而不是先编码再量化时“顺便”带上。
🧩 拆出两条以前被当成一步的设计轴:图怎么建、递归怎么分。RQ-VAE、RQ-KMeans 正好落在“空图”这个角上,于是语义特征、协同图、划分器可以分别升级再组合,不用每次重写问题定义。
⚙️ 给了两个差异很大的实例:RecDMoN 用可微图池化直接学层次划分,RQ-GAE 保留残差量化骨架,加图感知的item表示和图重构目标。
📊 在多个真实数据集上,相比 CF-aware 的 SOTA 是一致提升,不是只在个别数据集上赢。
📈 最高提升 +52% Hit@10,而且用的还是文本元数据embedding,没上多模态。
✅ 图构建和划分是显式、可分别配置的模块,任一轴的改动都能单独评估、也能叠加,这点比“某个新tokenizer刷了个点”更实用。
总结:做生成式推荐 tokenizer 的同学可以跟这条线,重点盯 Hit@10、Recall 这类检索指标,同时看码本利用率、code冲突和长尾item的码分布。坑在图构建规则,共现阈值、边权、时间窗都得调;对比时要保证语义特征和下游生成器一致,否则增益可能来自特征而不是图。要是下游序列表征本来就够强,tokenizer 带来的边际收益会被吃掉一部分。
原文:AlphaXiv