小红书精读:Generative End-to-end Ad Retrieval at Douyin
生成式召回的两个死结,被一起解了🔧
各位算法同学们,生成式召回最难受的不是模型不够大,而是码本一扩,坍缩更狠、撞码更多。抖音这篇把这两个互相拉扯的问题塞进一个端到端框架里同时解,而且已经在广告线上扛着数亿日活。
📄 Generative End-to-end Ad Retrieval at Douyin
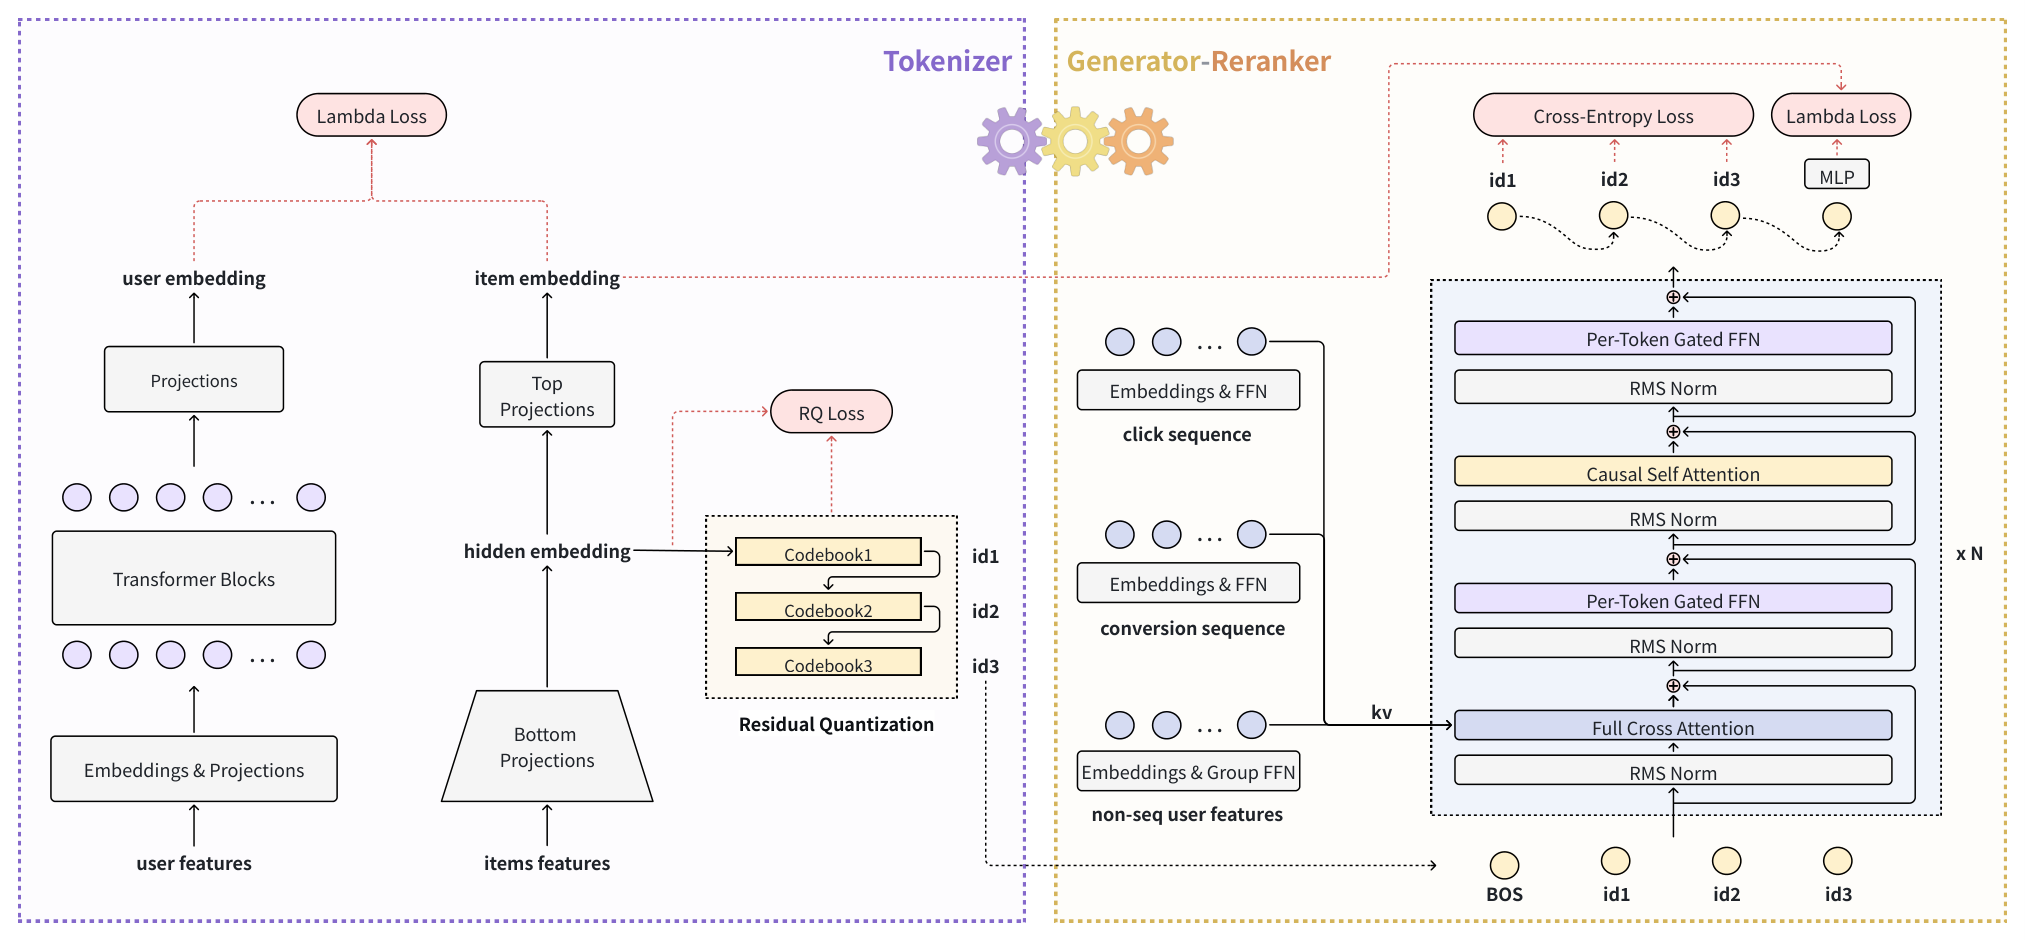
🔧 BasisVQ:用可学习的正交基重新参数化码本,更新时等价于整个潜空间做刚性旋转。没人选中的死码也跟着一起转,不会像普通线性变换那样被拉飞、永久失活。正交基用 Newton-Schulz 迭代求,前向先按 Frobenius 范数归一,保证收敛和数值稳定。 🧩 Prefix-aware BasisRQ:在残差量化每层做前缀感知的逐元素仿射变换,用前面各层的码去查缩放和偏置。表达力上去了,渐近时间复杂度没变,比 QINCO 那类 MLP 方案轻。 ⚙️ 联合重排头:直接复用生成器的自回归隐状态,多解一步,把撞到同一 token 序列的不同 item 区分开,用 Lambda Loss 和 tokenizer、generator 一起端到端训,不用再单开一条重排链路。
📊 论文称已在抖音广告服务数亿日活用户,大规模线上 A/B 有提升,但摘要没给具体百分比,这块得翻正文或等后续版本。 📈 稳定性上,Newton-Schulz 五次迭代就够;训练额外复杂度 O(d³),跟 batch size 无关;参数只多 O(d²)。 ✅ 推理端码本可以离线预计算并缓存,作者说推理复杂度与 vanilla VQ 一致,零延迟开销。
如果你在做生成式召回、VQ 码本或端到端召回,这篇的落点比较明确:别只盯离线 Recall,要重点看码本利用率和撞码率,再对比重排头带来的线上收益能不能覆盖端到端训练的成本。最大的坑是线上分布持续漂移下的长期稳定性,论文给了收敛分析,但码本几个月后会不会再次退化,还得拿自己的流式数据验。
原文:AlphaXiv