小红书精读:OneLatent: Latent Reasoning for Efficient Foundation Recommendation Models
推荐模型不写CoT,吞吐还快17倍
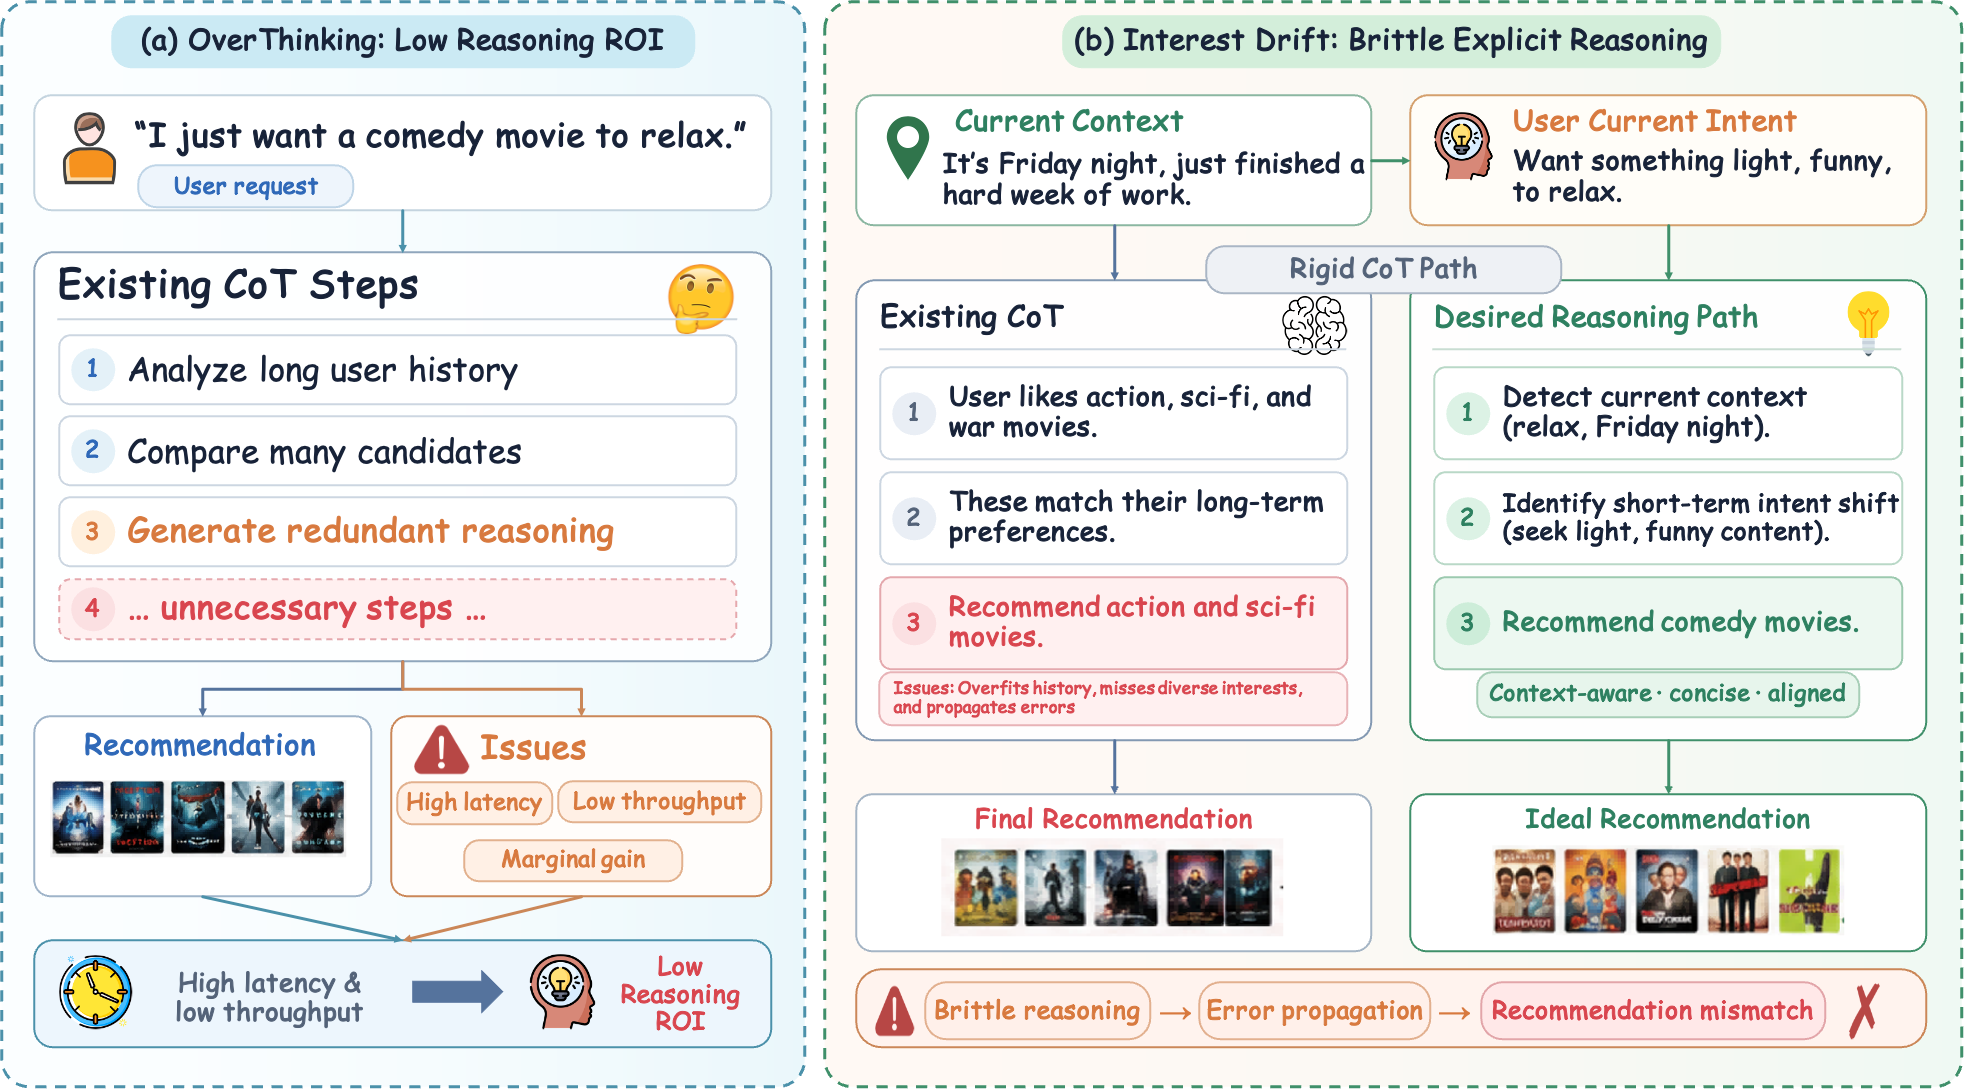
各位算法同学们,推理链写得越长,推荐就一定越准吗?快手这篇给出的答案有点反直觉:把整段显式CoT压成3个可学习的latent token,SID@64反而比Think版高17.44%,线上吞吐还高17倍以上。对于正在纠结FRM推理开销的团队,这个思路值得拆开看。
📄 OneLatent: Latent Reasoning for Efficient Foundation Recommendation Models
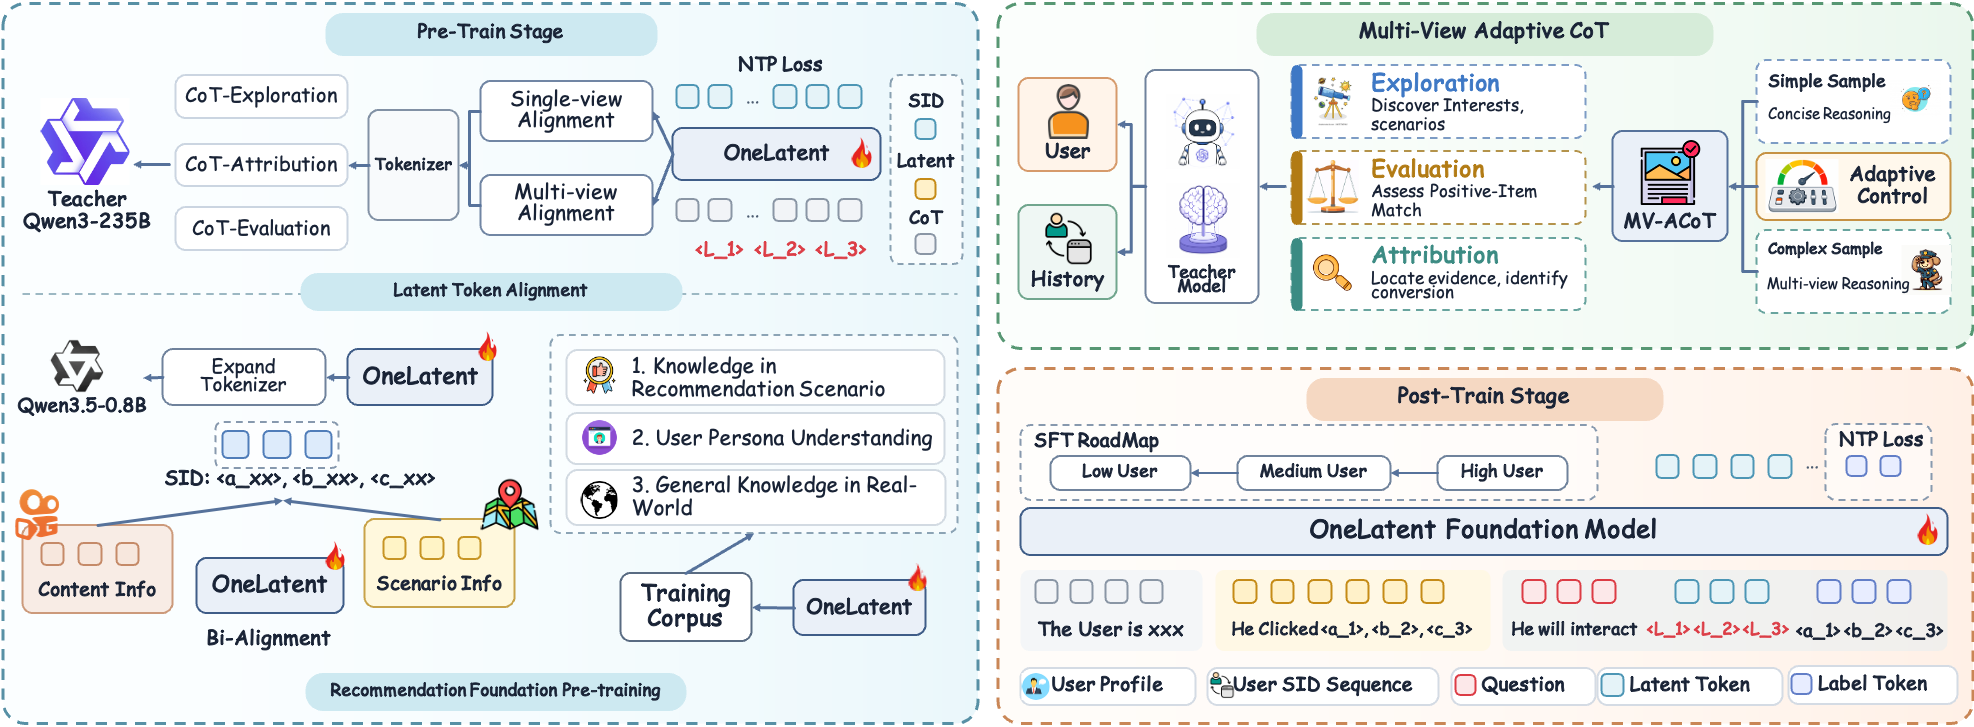
🔧 MV-ACoT:不靠人工模板,而是从兴趣探索、正样本评估、交互归因三个视角构造互补的教师CoT监督,并让推理深度随样本复杂度自动伸缩,缓解固定单路径推理带来的兴趣漂移。
🧩 三阶段latent token对齐:先在latent位置上做rationale预测学出上下文表示,再把同一个latent接口接到next-item预测,用渐进方式把教师CoT内化进3个共享的token ID,而不是样本级向量。
⚙️ 课程式后训练:分阶段激活latent推理,同时保留直接预测和latent推理两种模式,推理token开销恒定,不再随请求动态变长。
📊 工业规模快手数据集上,比显式Think变体SID@64提升17.44%,比No-Think变体提升9.33%。
📈 相比显式rationale解码,吞吐提升17.49倍;换到9B骨干,同样超过直接预测和显式CoT基线。
✅ 快手本地生活广告线上A/B,对比OneRec、OneReason等强基线,预估收入提升9.6%。
我的判断:做生成式推荐、准备把LLM当FRM骨干的同学可以重点跟这条线。要盯的是SID@64和吞吐的联合曲线,以及latent token到底是真在承载推理,还是只做了语义关联——论文自己也把这两者区分开了。落地有两个坑:latent token是全体共享的固定ID,效果强依赖教师CoT质量;另外单靠模型加速仍扛不住全量同步推理的延迟,必须配异步serving把基础模型推理挪出在线请求路径。
原文:AlphaXiv