小红书精读:Correcting to Predict: Pseudo-Value Correction for Multimodal Attribute Value Extraction
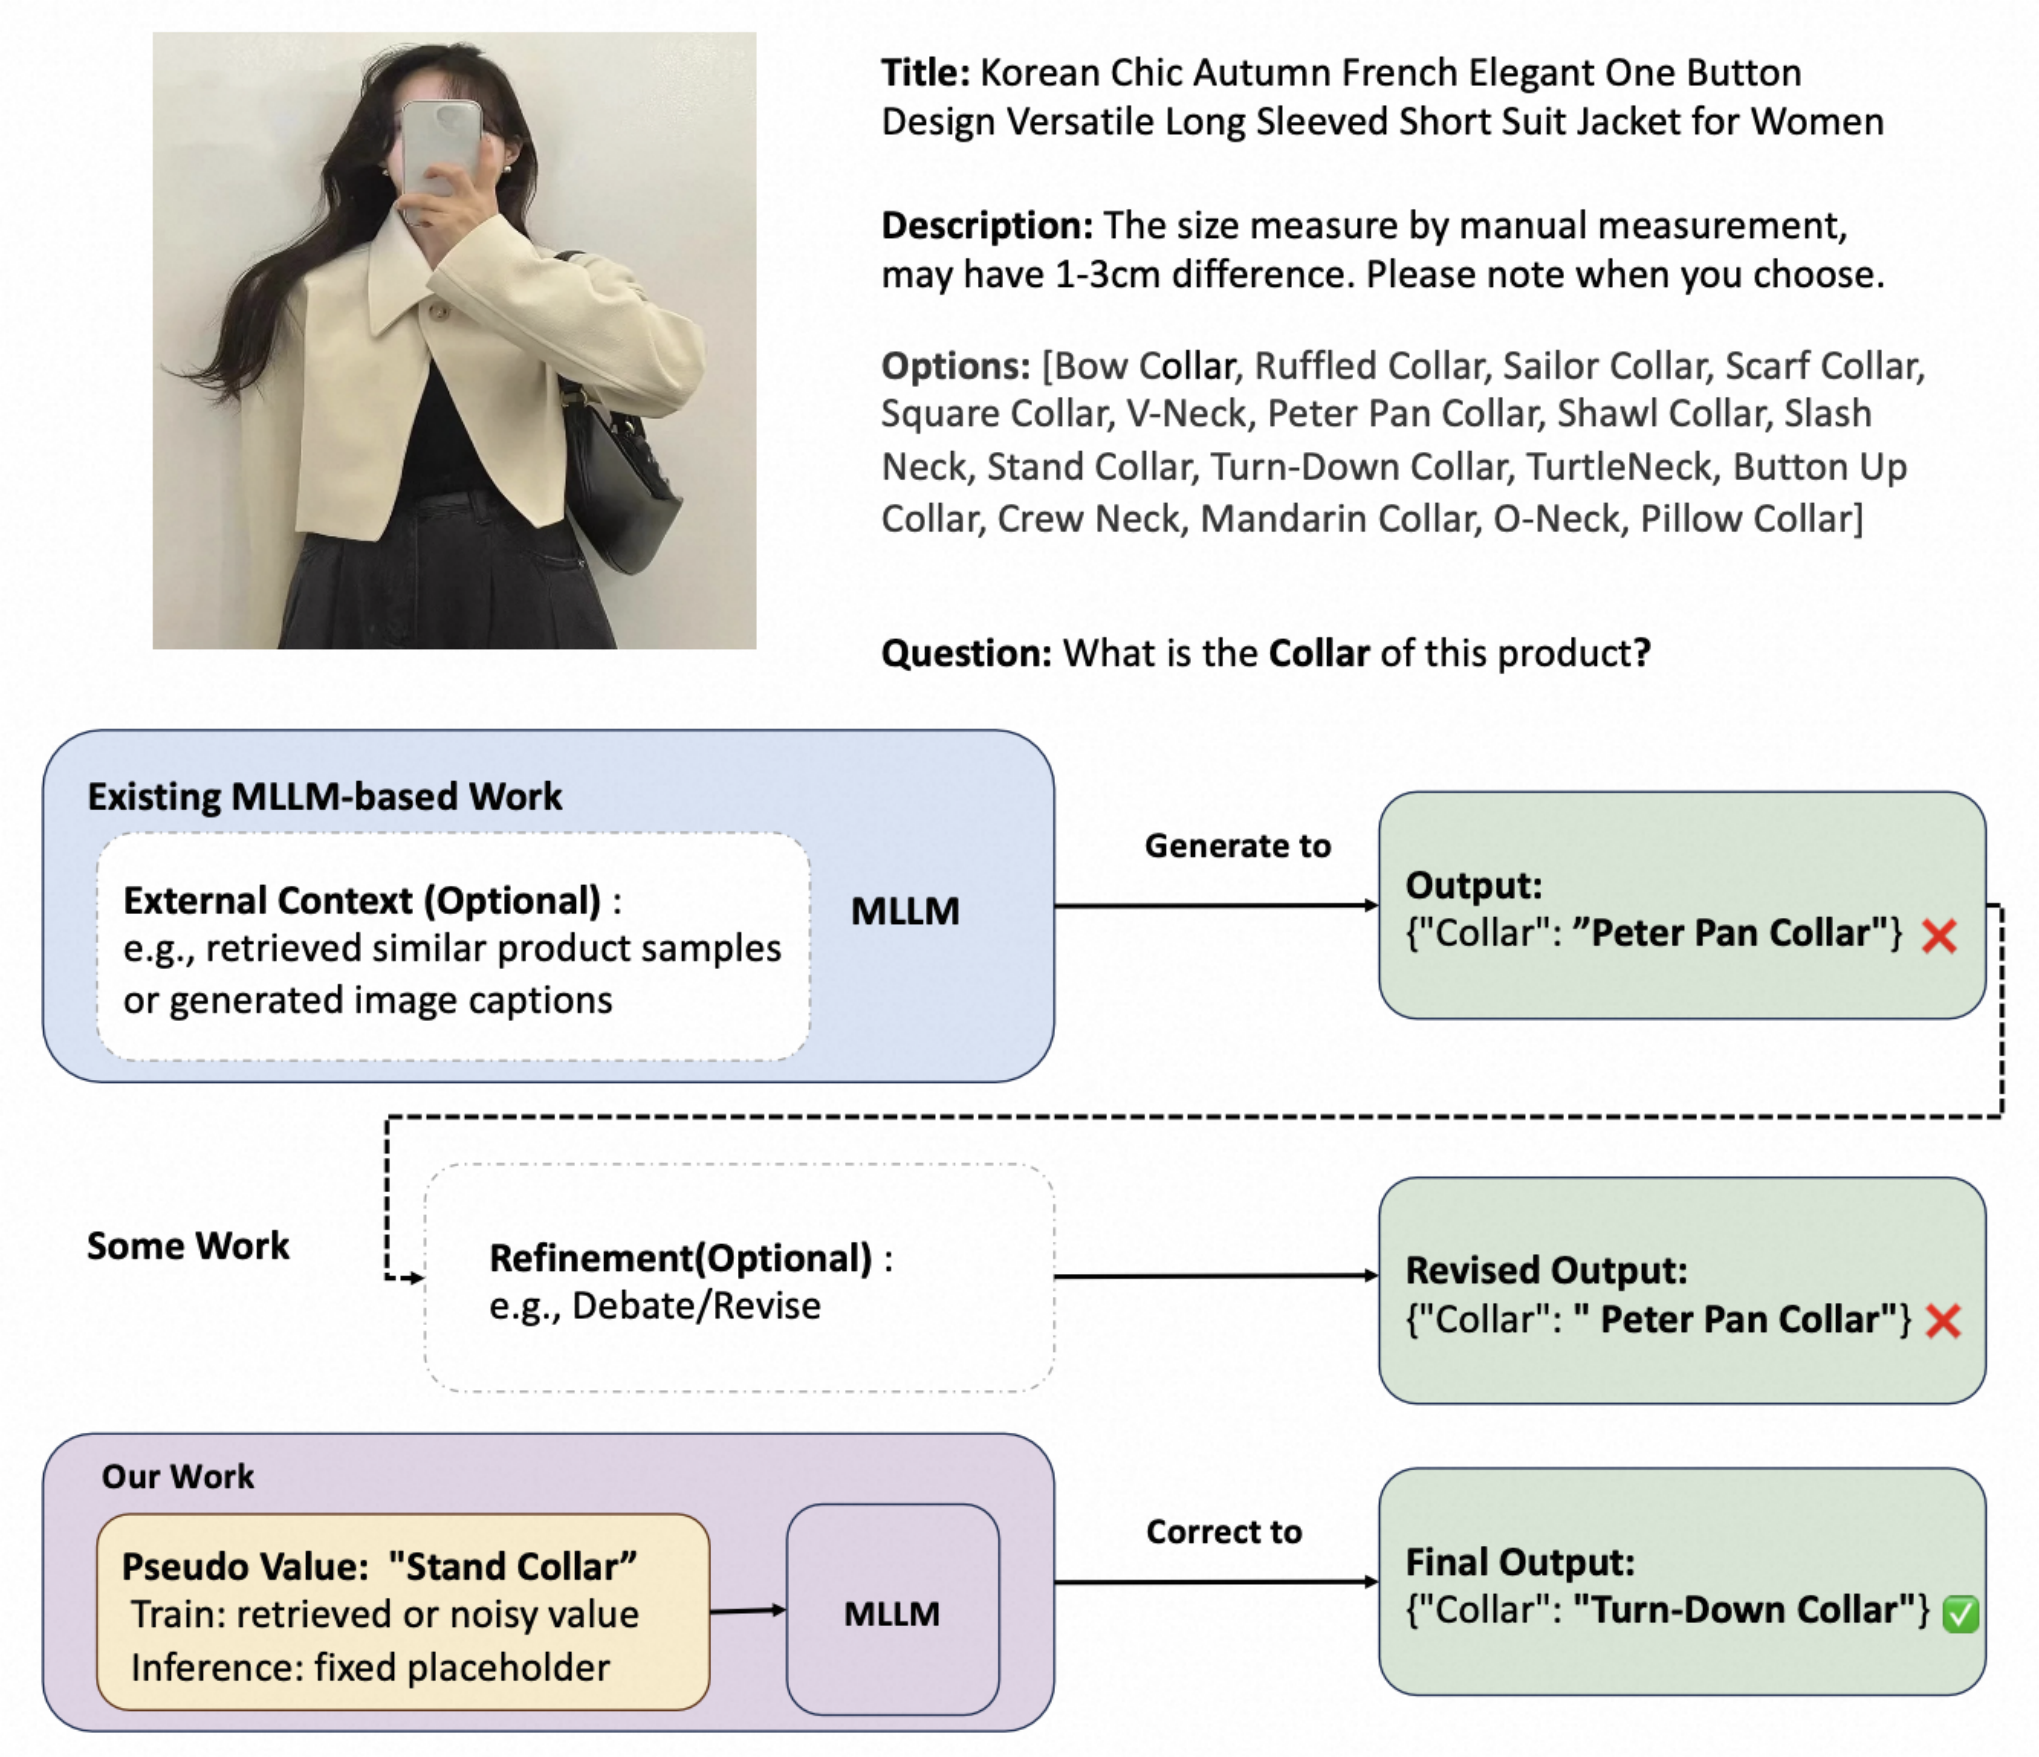
属性抽取换个思路:别生成,去纠错
🧭 各位算法同学们,多模态属性抽取里最坑的不是模型”看不见”,而是它明明看见了,还是照着候选值抄。阿里国际这篇 C2P 干脆把 AVE 从生成任务改成了纠错任务,线上三个业务指标都跑出正向,思路比结构更有意思。
📄 Correcting to Predict: Pseudo-Value Correction for Multimodal Attribute Value Extraction(CIKM ‘26,Alibaba International Digital Commerce Group)
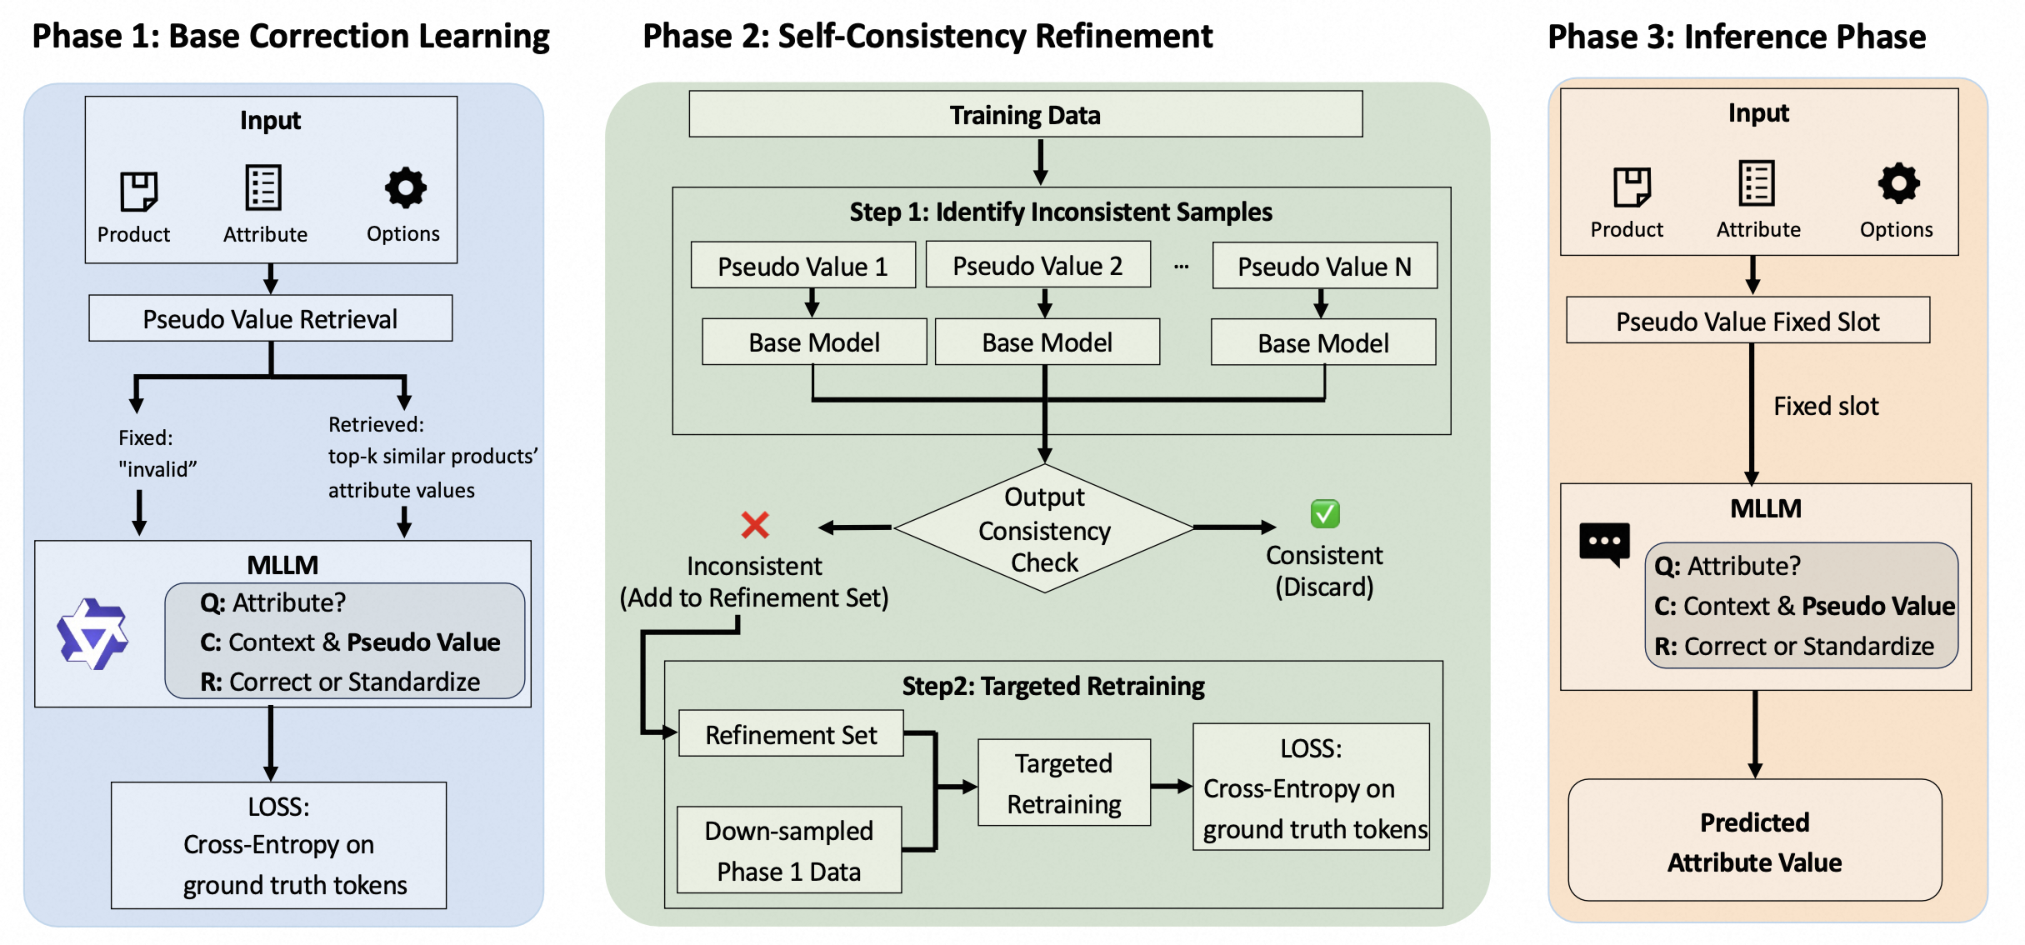
🔧 输入里塞一个”伪值”:可以是检索到的候选,也可以只是一个占位符,模型的任务变成按图文证据判断该保留还是改掉。检索结果从”可信上下文”降级成”待验证的假设”,这是它和 RAG 路线最本质的分歧。
🎲 训练时故意喂各种不同的伪值,逼模型学”看证据”而不是”抄输入”;再加一个自一致性精炼阶段(SCR),专门捞出那些换个伪值预测就变的样本回炉,因为预测会变说明它依赖的是输入猜测,不是商品本身。
⚙️ 推理时不需要在线检索、也不需要多轮迭代,固定一个占位符就能触发学到的纠错行为,单次前向出结果,这是它能进生产环境的前提。
📊 离线评估用公开的 ImplicitAVE 榜单加一个大规模工业数据集,提升主要集中在歧义属性上,也就是 Boot Style、Season 这类必须图文联合推理、语义相近值容易混的字段。
📈 线上在 AliExpress 做了 A/B,卖家采纳率、属性完整度、用户互动三个方向都是一致正向,属于真实流量下的工业验证,不是只刷榜单。
✅ 效率层面省掉了在线检索和迭代精修,一次前向预测,延迟和成本都可控。摘要和正文截断处没有给出具体提升的百分点,想看准确数值得等完整实验表。
🧠 如果你的场景是电商属性抽取落地,这篇的价值在于视角:把检索候选当假设而不是上下文,比”再加一轮自我反思”更治本,因为自我纠错和投票类方法的问题就是初始预测没被证据锚住,后面越修越错。要盯的坑是两个:伪值的构造方式直接决定学到的纠错行为,线上候选质量或类目分布和训练差太远时可能退化;对比对象要锁死 EIVEN、MVP-RAG 这类,重点看歧义属性子集,而不是整体平均分。
原文:AlphaXiv