小红书精读:SPARQL-LLM: Real-Time SPARQL Query Generation from Natural Language Questions
每问1分钱的Text2SPARQL ⚡
各位算法同学们,Text2SPARQL 现在的瓶颈早就不是准确率了,是“一个问题要等多久、烧多少钱”。这篇工作的看点在于它把 runtime 和 cost 摆到和精度同等的位置,而且是真上线跑的,不是只刷榜。
📄 SPARQL-LLM: Real-Time SPARQL Query Generation from Natural Language Questions
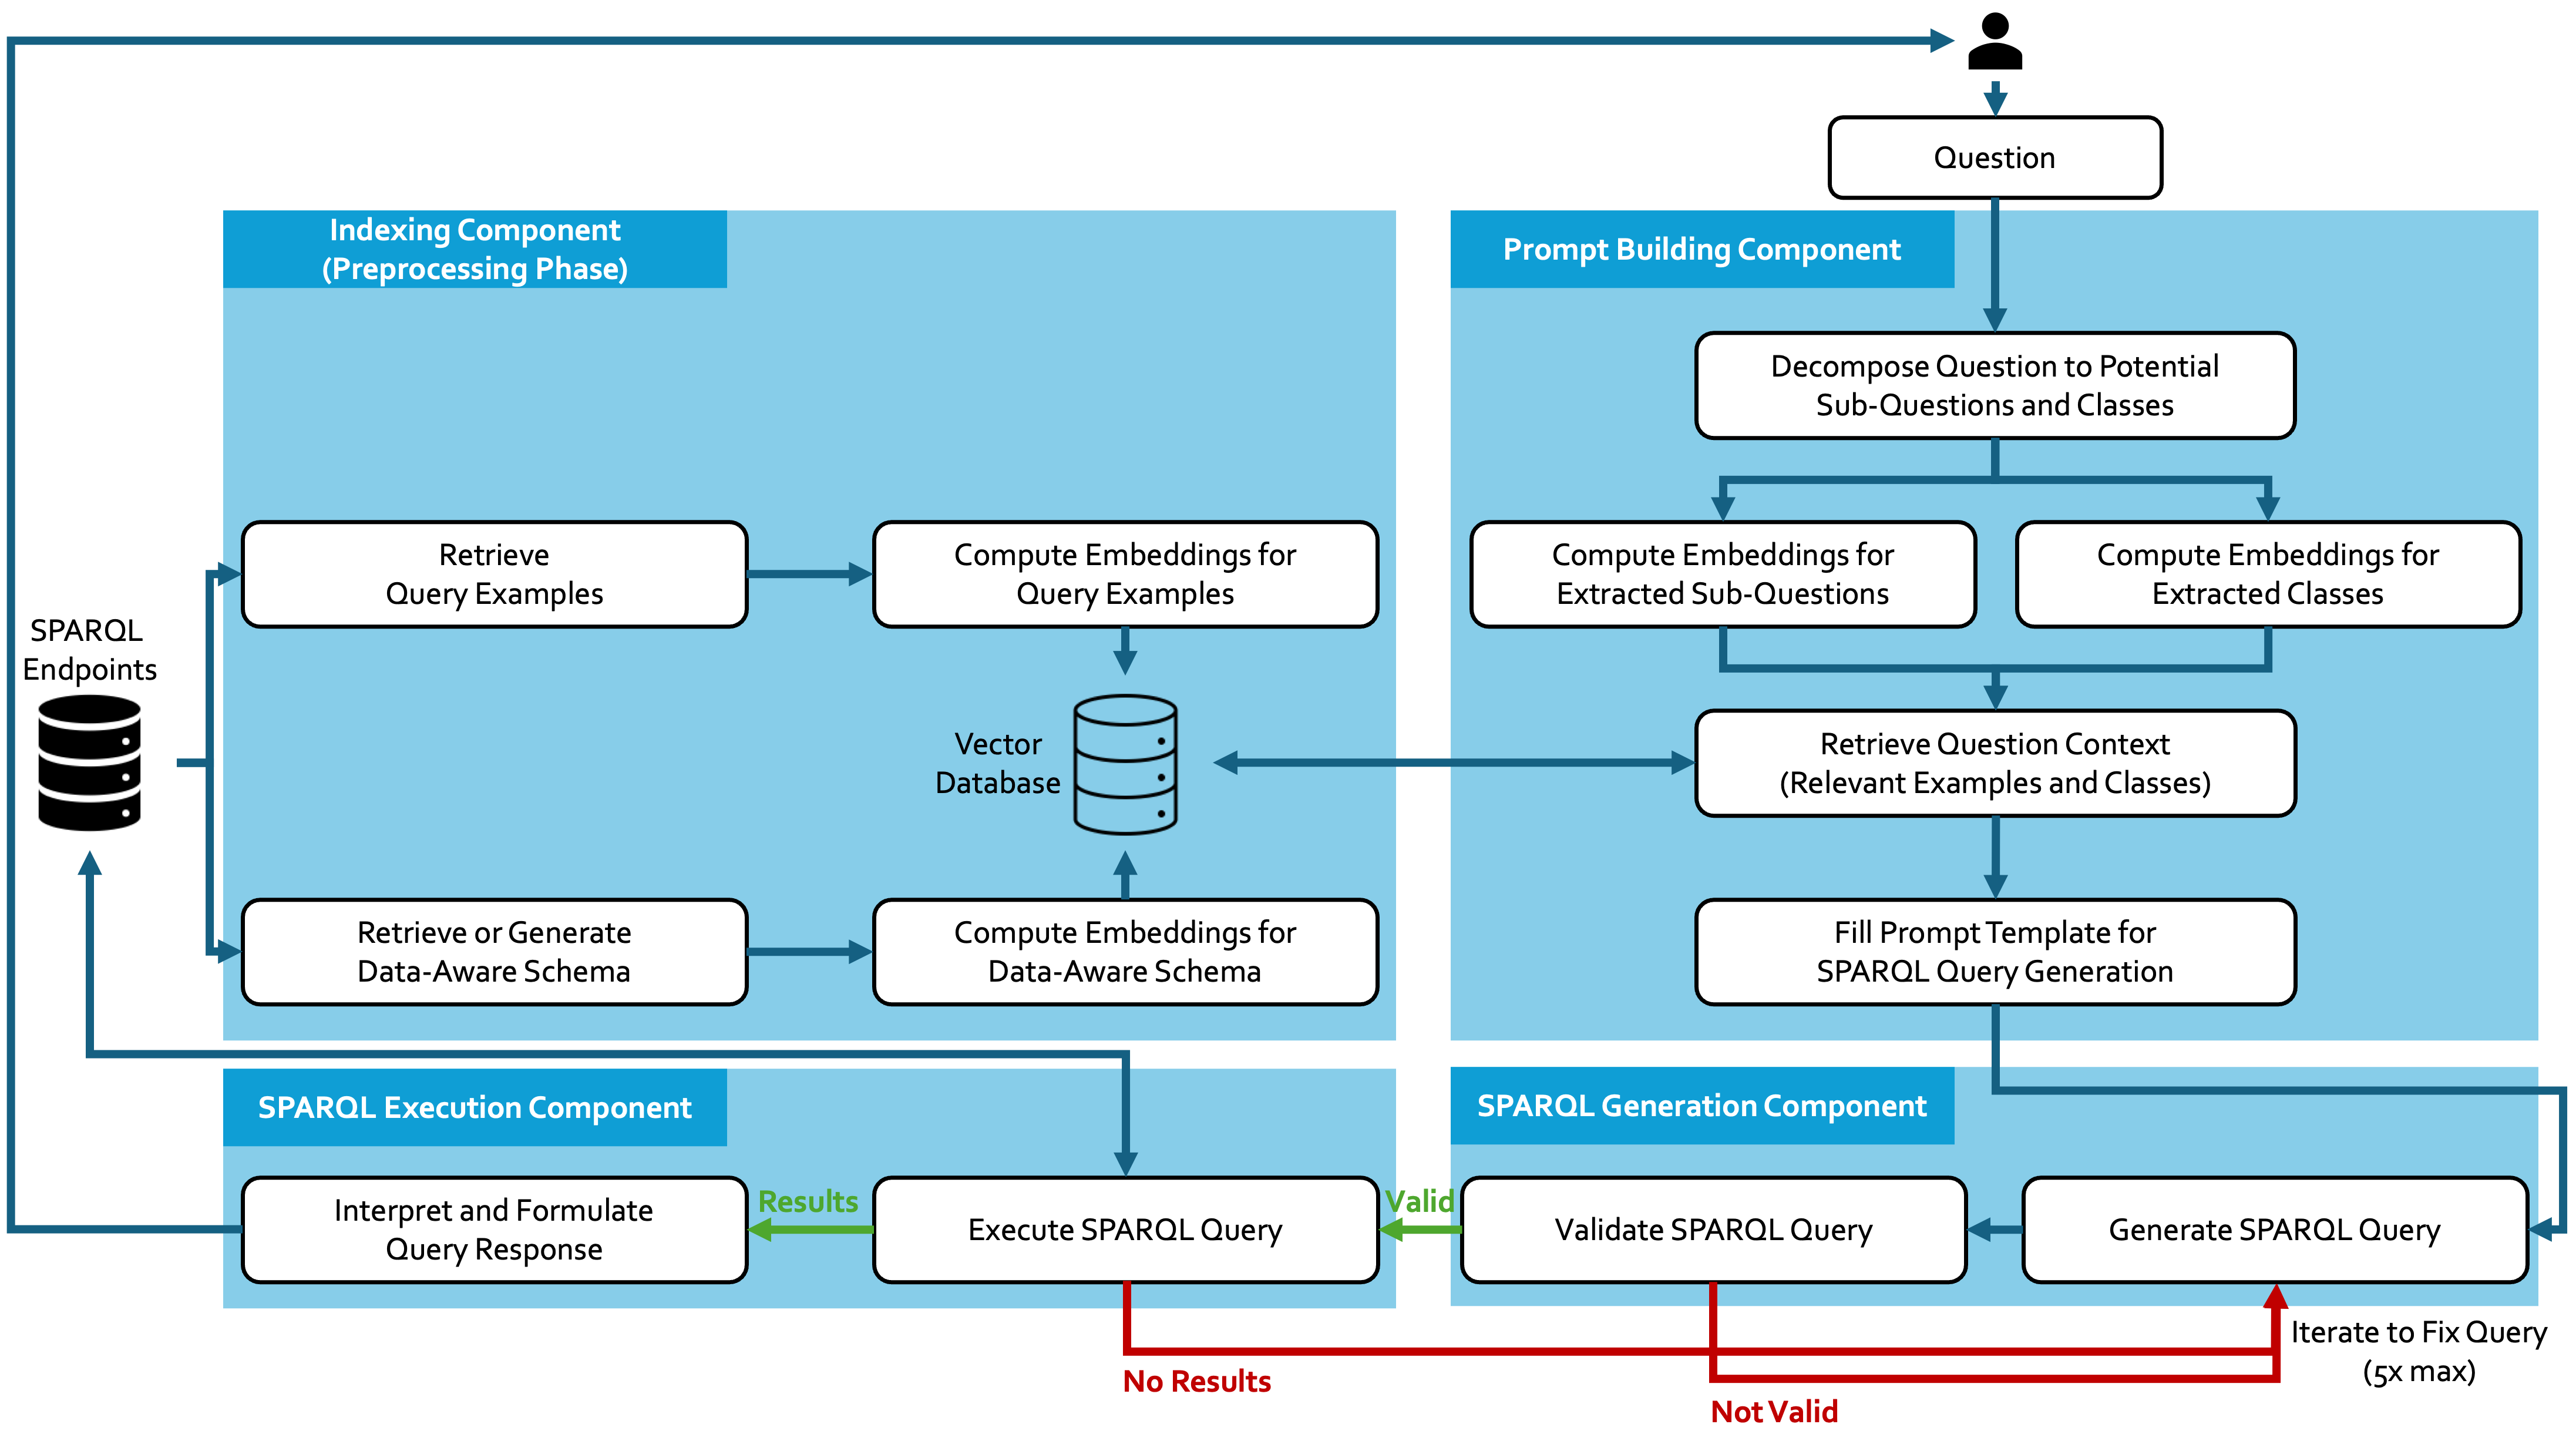
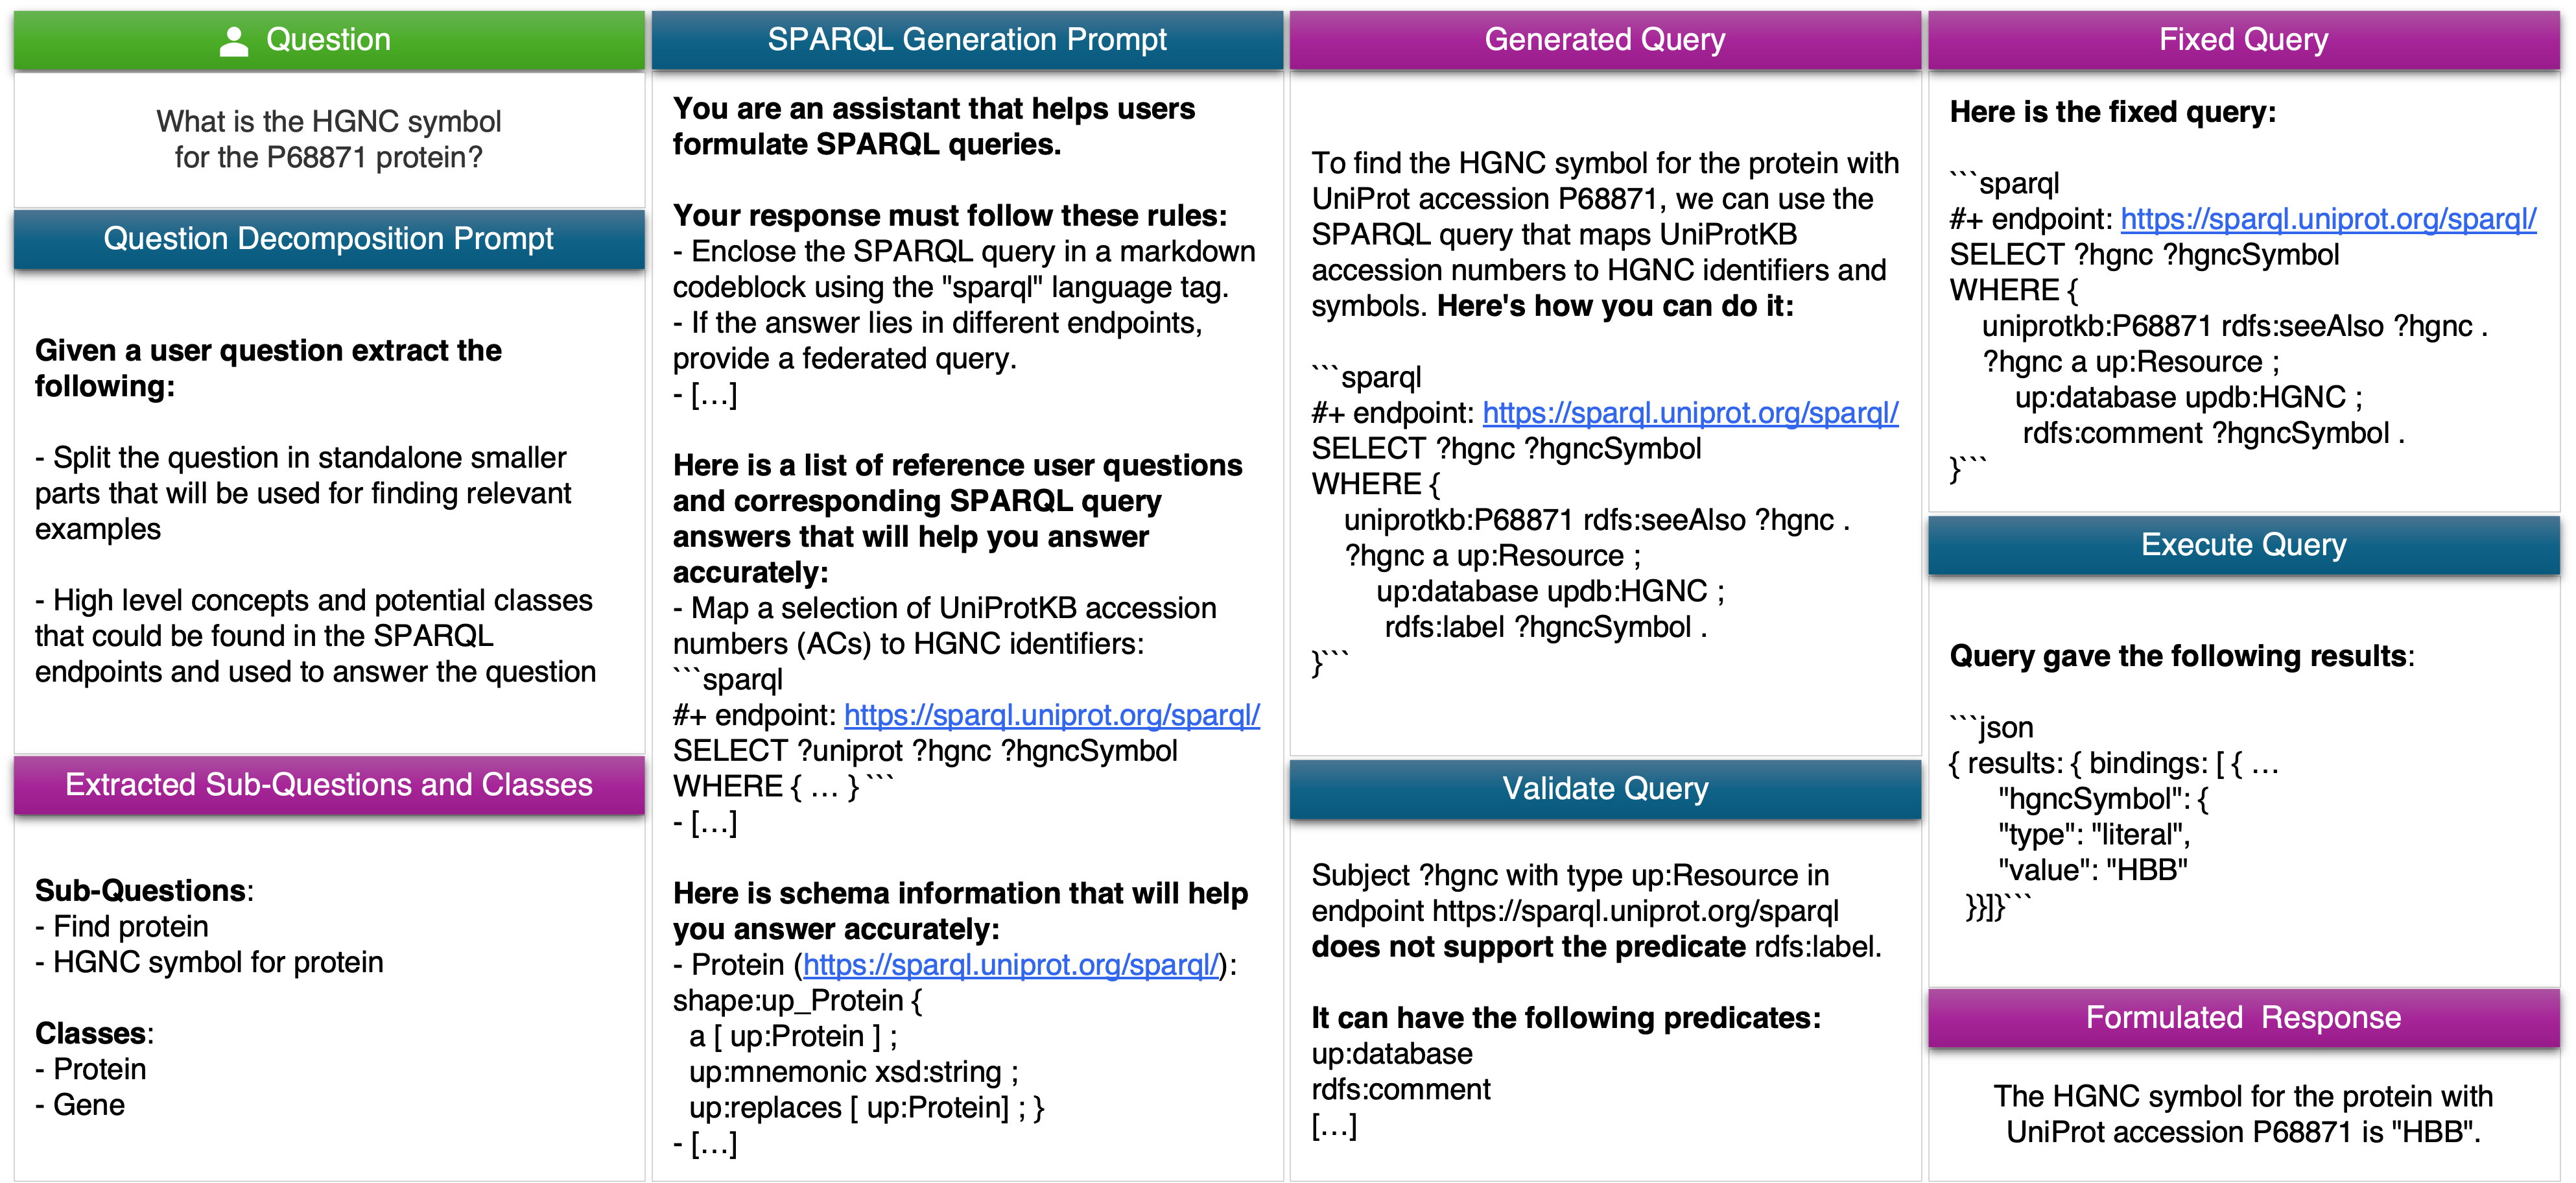
🔧 混合路线:检索式 KGQA 负责先验知识,从端点里捞出人工写的问题–SPARQL 样例对,加上数据感知 schema(VoID 统计)拼进 prompt;再用 agent 式的迭代校验检查生成的查询能不能跑通。不像纯 agent 那样每个问题都把 schema 从头摸一遍。
🧩 元数据轻量且从端点自动抽:用 triplestore 无关的 VoID 生成器扫 schema,另配一个自研工具在耗时和元数据完整度之间折中,适合数据常变、元数据得随时更新的 RDF 库。门槛也不高,很多端点本来就有现成 query examples。
⚙️ 强调用“人写的样例”而不是模型自造样例,理由是自生成的过程性知识平均下来没什么收益,用户意图和真实 SPARQL 写法之间的鸿沟太大。系统切成元数据索引、prompt 构建、查询生成与执行三块,端点对任何 triplestore 都适用。
📊 在 multilingual 公开挑战赛上,F1 比第二名高最多 59%。
📈 延迟最低,比第二名快最多 27 倍,单问题成本最多 0.01 美元,这才是“实时加低花费”能落地的关键。
✅ 英语、西语、德语这类高资源语言都能接,也能写出复杂的生物信息学查询;评估覆盖了生物信息学三个主流知识图谱,并做了消融,分别看样例和 schema 各自的贡献。
⚙️ 代码在 GitHub 开源,线上部署在 expasy.org/chat,属于点开就能用的那种。
总结:端点稳定、schema 有人维护、又要压 token 成本的场景,这套检索加校验的混合思路比纯 agent 划算。要盯的指标是 F1、p95 延迟、单问成本三条一起看,只报准确率的对比参考性不大。坑在于它吃高质量的人工问题–查询样例,冷启动没样例、schema 又乱的小众图,收益会掉下来,建议先在自己的端点上跑一遍消融。
原文:AlphaXiv