小红书精读:IDProxy: CTR Prediction with Multimodal LLMs for Cold-Start Recommendation at Xiaohongshu
新内容零交互,小红书让MLLM顶替ID
各位算法同学们,新 item 没有交互数据,CTR 模型基本等于瞎猜——小红书这篇的做法是:不给新 item 学 ID embedding,直接让多模态大模型按图文内容“现编”一个 proxy embedding 顶上。工业落地报告,不是实验室玩具。
📄 IDProxy: CTR Prediction with Multimodal LLMs for Cold-Start Recommendation at Xiaohongshu
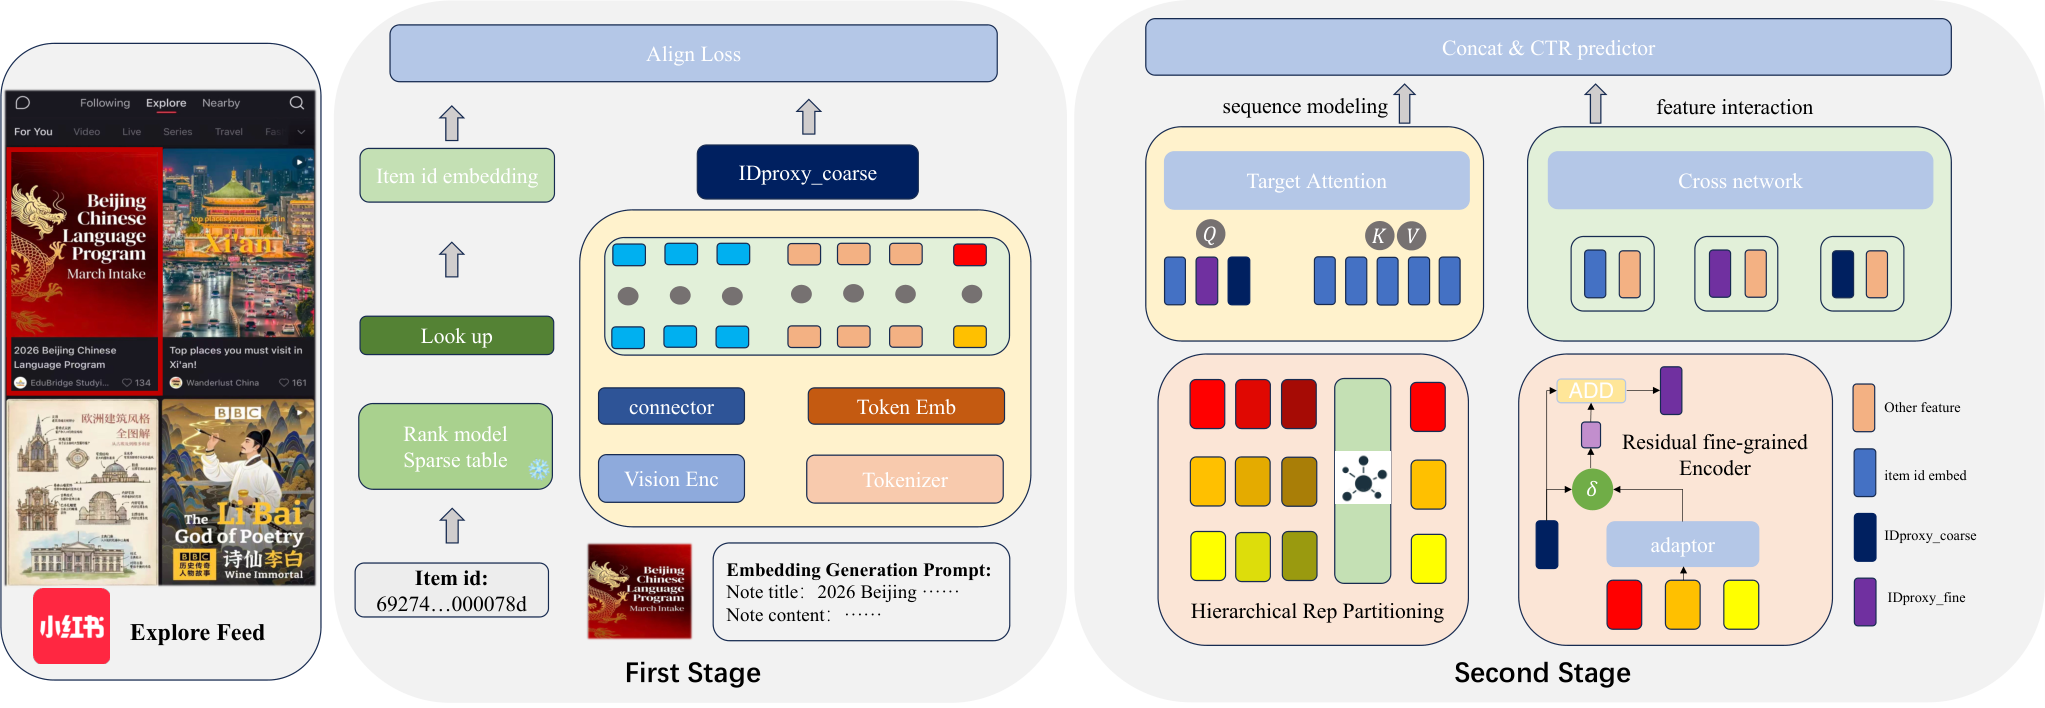
🔧 用 MLLM 编码 item 的图文内容生成 proxy embedding,在没有行为数据时替代 ID embedding,直接塞进现有 CTR 排序模型。 🧩 Stage 1 用对比学习把内容表示拉进 ID 空间,先按频次阈值滤掉低频 item,再做 L2 归一化消掉热度带来的模长偏差。 ⚙️ Stage 2 取 MLLM 多个中间层 hidden states,k-means 聚成浅中深三组,轻量 adaptor 融合加残差门控,端到端跟 ranker 一起训,排序模型架构整个复用。
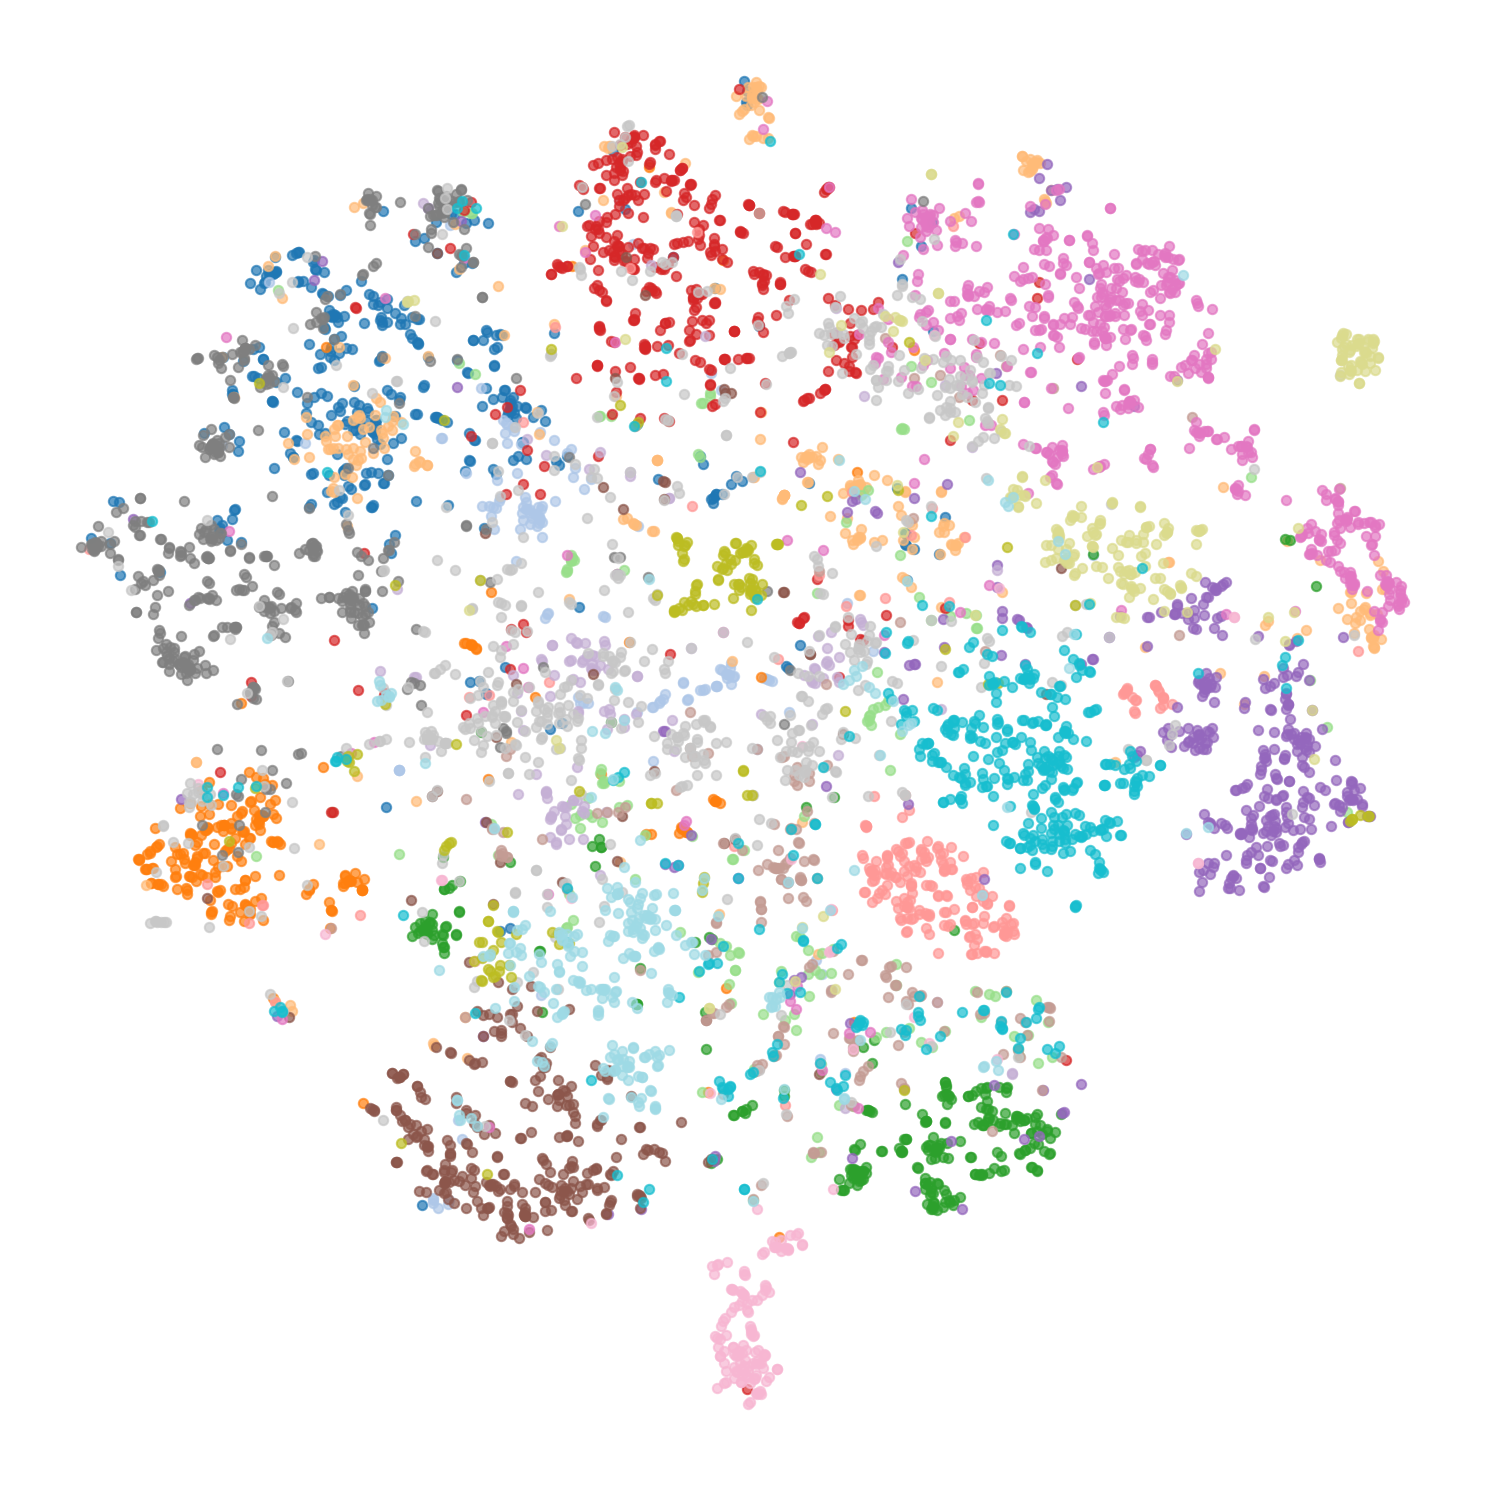
📊 论文用 t-SNE 对比指出:行为共现类方法学到的表示和 ID embedding 分布差得远,而 CB2CF、CLCRec 那类直接映射在 MovieLens 上看着行,工业 ID 是非聚类的不规则分布,冻结 encoder 或浅层 MLP 桥不过去。 📈 平台 3 亿+ 用户,item 持续上传还得立刻可分发,冷启动是日常不是边缘 case。 ✅ 2025 年已上线内容 Feed 和展示广告两个场景,每天覆盖数亿用户。 📉 离线实验和线上 A/B 论文都给了有效性结论,但正文截断,具体涨点百分比我这边没拿到,追完整版时重点看 Stage 2 的消融贡献。
对做工业推荐又被冷启动卡住的同学,这套“复用原 ranker + 端到端对齐”的工程思路比涨点本身更值得抄。要盯的指标是冷启 item 的 CTR 和曝光分布;坑在于 proxy 依赖 ID 空间稳定,线上 ID embedding 漂移时两阶段对齐得重跑。
原文:AlphaXiv