小红书精读:One-Step Retrieval Framework for Real-Time Sponsored Search Ads Using Hierarchical Text Representations
🔍广告检索不用SID了?ANGLE这么干
各位算法同学们,广告检索线上消费 +1.81%、GMV +2.16%,但更狠的是它把相关性评估和预排序直接砍了,生成完候选就送进最终排序。
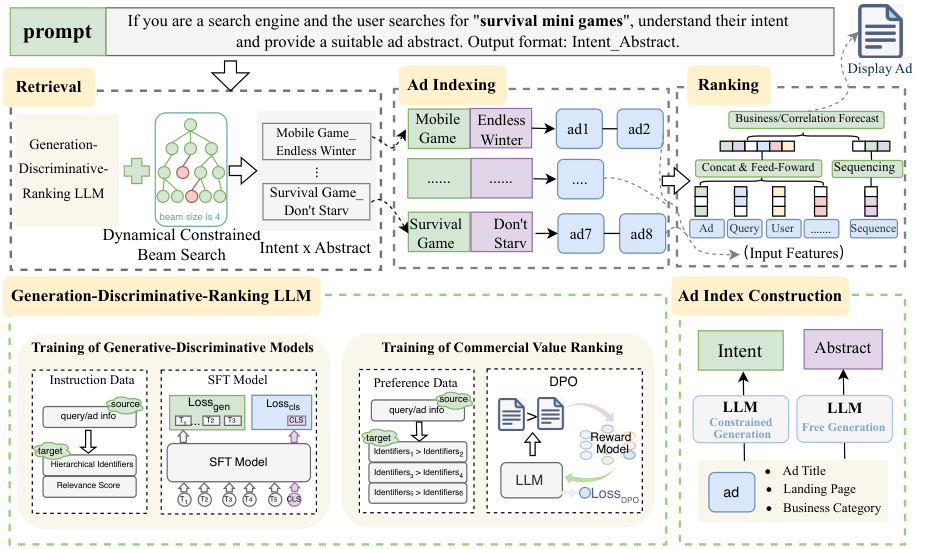
这篇要解决的是传统多级级联架构里各模块目标不一致、高潜广告被提前筛掉的问题,以及 SID 生成式方法要背大量映射、泛化差、解码效率低。它给出的 ANGLE 框架,用分层文本表示替代离散 SID,还把生成、判别、排序合进一个 LLM。
📄 One-Step Retrieval Framework for Real-Time Sponsored Search Ads Using Hierarchical Text Representations
🔧 广告表示换成 intent + abstract 的分层文本。intent 给高层商业意图概览,abstract 给细粒度广告细节,直接由 LLM 生成。新广告不用重建 SID 映射,从广告文本生成 int-abs 对就行,泛化更好,也更可解释。
🧩 训练一个 GDR-LLM,把生成、判别、排序能力塞进同一个基座。检索时先生成 query 对应的 intent-abstract,再用倒排索引找回广告,检索结果跳过 relevance 和 pre-ranking,直接进 ranking。
⚙️ 解码用动态约束 beam search,beam size 是 4,保证生成的 intent-abstract 能命中广告索引,不是自由发挥。这个细节挺工程,直接关系到线上能不能实时出候选。
📊 线上 A/B 实验:消费 +1.81%,GMV +2.16%,点击 +1.5%,来自真实搜索广告场景。
📈 离线对比 7 个 baseline,在 HR、MAP、ACR 这几个关键指标上 ANGLE 都最好。
✅ 论文提到框架在千万级规模的生产环境验证,不是纯离线玩具。
总结一下,做搜索广告或生成式检索的同学可以跟,重点看它怎么用文本表示替代 SID、怎么平衡生成和排序。要盯的指标除线上 GMV 和消费,还有离线 HR/ACR 以及索引覆盖率。坑也明显:int-abs 表示质量依赖 LLM,广告库更新和倒排索引维护成本、约束解码的命中率、跳过 relevance 后 ranking 的压力,都得看线上长期表现。和 MCA 比它链路更短,和 SID 生成式方法比它泛化和可解释性更好,但大规模广告库下能不能稳住,是后续要观察的点。
原文:AlphaXiv