小红书精读:AURA: Agentic Diagnosis and Refinement for Production Recommender Systems at Scale
推荐指标涨了,用户却在踩坑?
各位算法同学们,NDCG涨了就等于推荐变好了吗?这篇来自迪士尼团队的工作说:不一定。它用LLM agent把成千上万条线上session读成失败案例库,再顺藤摸瓜改到推荐系统自己的代码里。
📄 AURA: Agentic Diagnosis and Refinement for Production Recommender Systems at Scale
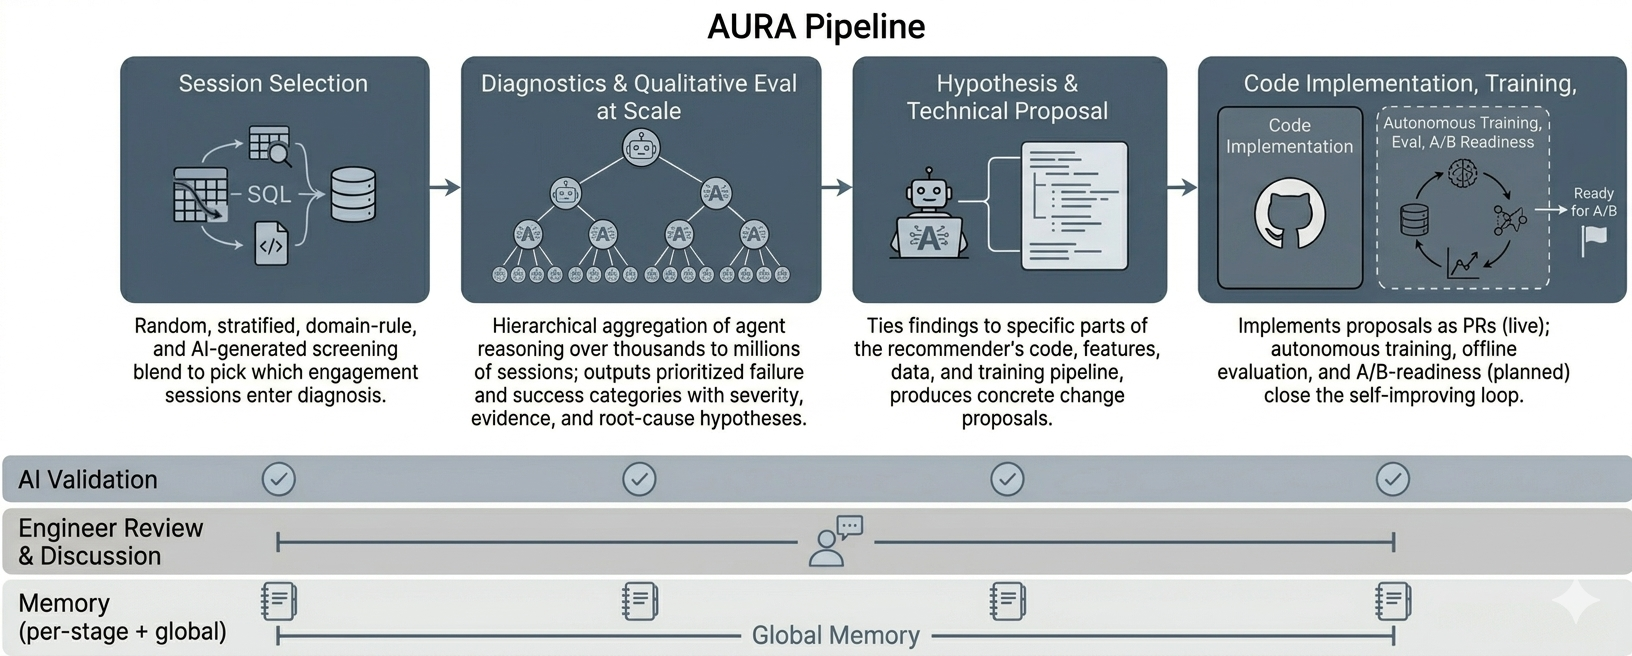
🔧 把“人肉看case”做成流水线:四个阶段——选session、规模化定性诊断、生成根因假设和技术提案、落到代码PR,中间穿插AI校验、工程师review和记忆日志。 🧩 诊断不止给结论,还带证据:每个失败或成功类别附严重度、session证据和根因假设,再从推荐系统自己的代码、特征和训练管线里找可改点。 ⚙️ 换平台靠配置不靠改代码:数据源、列映射、分群定义、prompt覆盖都走配置层,已经在两个消费平台之间迁移过,并给出电商和零售推荐的映射。
📊 阶段级rubric分数:Platform A从15/25提到23/25,Platform B从17/25提到24/25。 📈 成本:Platform A的96,801条session花321美元,Platform B的101,594条session花250美元,大头在上游逐session判断,下游聚合只占小部分。 ✅ 分类词表收敛后:Platform A从12个涌现tag合并成8类,没有诊断损失;Platform B只剩一次重命名,零合并。
总结感想:如果你在做线上推荐、又苦于指标掉了但不知道谁被坑,这套思路可以拆开抄:先固定失败类别词表,再让agent给证据,最后才碰代码。坑也明显:成本随session量线性涨,且它现在主要产出人类review的PR,不是全自动闭环;真要落地,先盯诊断阶段的证据可信度和人工否决率,别一上来就接自动训练。
原文:AlphaXiv