小红书精读:LazFormer: Scaling Transformers for Industrial Recommendation via Transferable Generative Pre-training
推荐排序预训练,顺手治了两个坑🧩
各位算法同学们,工业推荐里最贵的一块成本,往往不是模型多大,而是从零开始训一个排序模型:稀疏 embedding 和稠密参数全都要从随机初始化裸跑。LazFormer 想干的事就是先用生成式预训练给这两类参数一个像样的起点,再迁进排序继续训,同时专门解决迁移时最容易踩的两个坑。
📄 LazFormer: Scaling Transformers for Industrial Recommendation via Transferable Generative Pre-training
🔧 生成式预训练做初始化:在用户历史交互序列上做自回归的 next item 预测,稀疏 embedding 和 Transformer 稠密参数一起学,而且预训练参数在排序阶段不冻结、继续更新,这点和以往冻结预训练权重的做法相反。
🧩 迁移残差适配器对付稠密参数负迁移:预训练和排序可用的特征本来就不一致,直接硬塞排序特有特征会打乱预训练学到的表示空间。他们借鉴 LoRA 的思路,用残差方式把排序专属特征注入进去,而不是改原有的稠密表示。
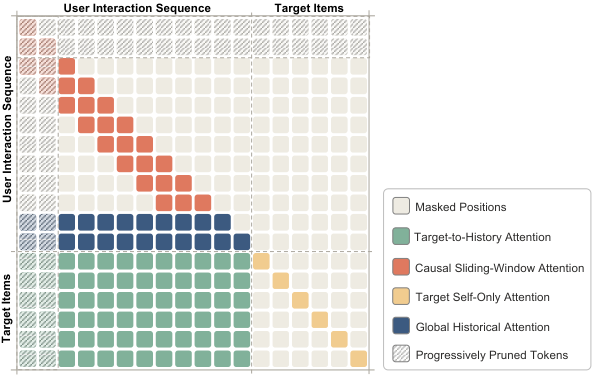
⚙️ request-aware 排序模块加非对称多轮训练:长序列侧用粗到细的序列压缩、混合稀疏注意力加渐进式 token 剪枝;训练侧每轮重置稀疏参数、让稠密参数跨轮持续累积,既压住稀疏参数多轮过拟合,也不至于因为冻结而丢掉对排序目标的适应性。
📊 论文用离线实验加线上 A/B 两套验证,结论是效果和可扩展性都有收益。
✅ 它已经上线到真实工业推荐系统,摘要原话是给平台带来显著提升。
📈 但摘要没给具体百分比,正文实验表格在这份分享里被截断了,CTR、CVR 的涨幅和对比基线得翻全文,看到数字再判断量级。
总结:如果你在做推荐排序的规模化,或者走预训练加迁移这条路线,这套三件套可以拆开看实现细节,对照 HSTU、MTGR、OneTrans 这类单塔从零训的方案,重点比收敛速度和算力开销。落地最容易出问题的是稀疏参数重置的频率,重置太狠会短期掉点;另外适配器的注入方式如果和自家特征体系不兼容,负迁移可能换个地方冒出来。
原文:AlphaXiv