小红书精读:ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling
超长用户序列压成可缓存token 🧩
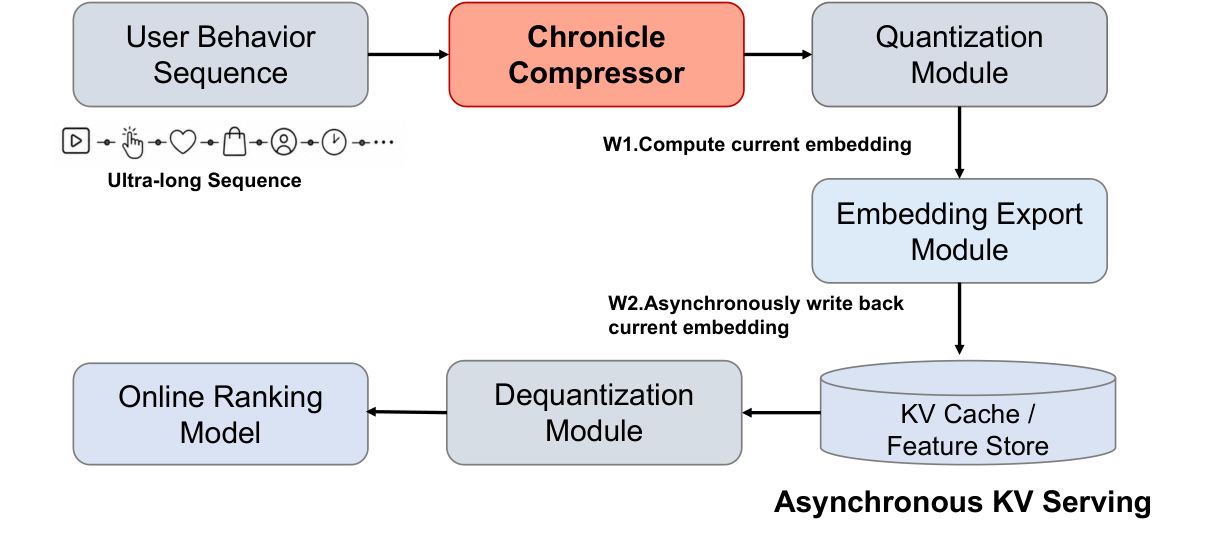
各位算法同学们,把用户上万条历史直接喂进排序模型,延迟扛不住;截断到最近几百条,又悄悄把长周期兴趣丢了。这篇的做法是离线把超长行为序列压成一串可缓存的token,线上按候选打分时不再碰原始长序列。
📄 ChronicleRec: Pre-training Temporally Anchored Tokens for Lifelong User Modeling
🔧 不走SIM那套「按候选检索」:token是target-independent的,一个用户算一次就能缓存复用,长序列编码和候选打分彻底解耦,线上走异步KV,当前embedding异步算、异步写回。
🧩 关键差别在压缩姿势。不是把query token全堆在序列尾部再双向读一遍,而是把query token按时间位置插进行为序列,用因果encoder让每个token只总结它锚点之前的历史;输出本身就是一条按时间排好的短token序列,不是一袋无序摘要。
⚙️ 粒度上做recency-aware多粒度merge:近端细、远端粗,按递增步长池化;再加multi-horizon多分支,每个分支遮掉不同长度的近期窗口,逼不同分支负责不同时间尺度。预训练用mask-and-predict,把最近行为挖掉、只用压缩后的远期历史去重建,让历史表示对齐当下意图。
📊 离线在KuaiRand和Tencent AdLive上,稳定优于recent-window和single-pass compression基线,同时逼近full-attention的表现。
📈 token层面的分析显示表示是按时间组织且互补的,不是冗余一团。
✅ 线上跑了7天A/B,论文称生产指标有显著提升。
总结感想:这套思路最适合做工业推荐/广告排序、长序列特征已经卡在延迟上的人。要盯三个点:压缩token数量和延迟的trade-off、离线逼近full-attention还差多少(这个差距就是信息损失上限)、缓存过期和异步回写的一致性。和SIM、VISTA比,它换的是「不按候选检索」加「有序因果摘要」,代价是预训练多一层对齐阶段,缓存刷新策略得自己设计。
原文:AlphaXiv