小红书精读:P3Rec: Distilling Prior–Posterior Preference Reasoning for LLM-based Recommendation
先验后验都蒸,推荐才不偏科
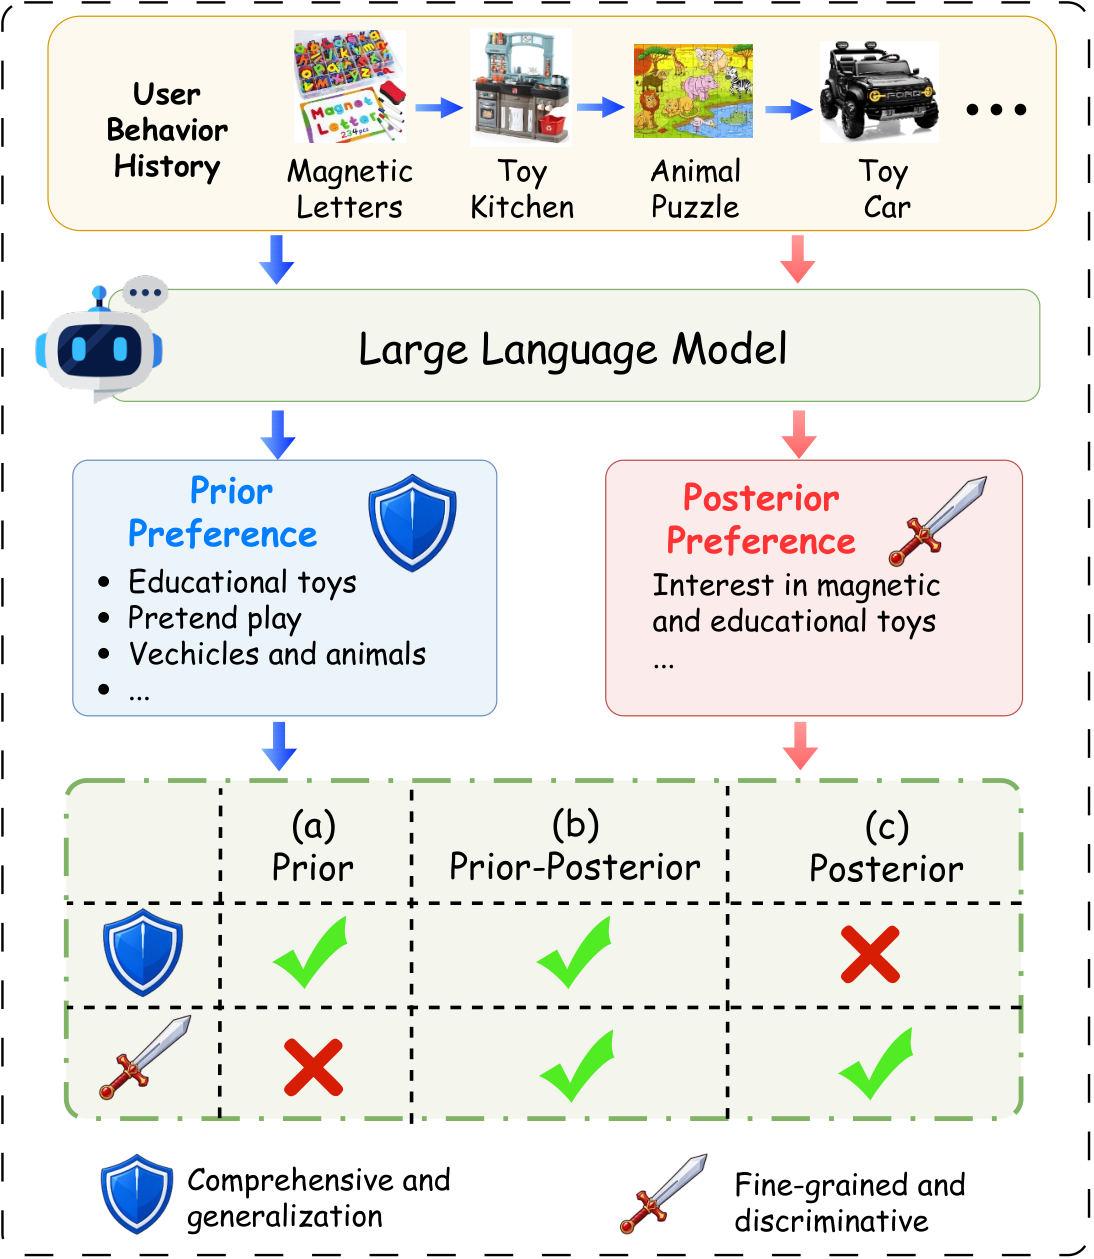
各位算法同学们,只蒸馏一种偏好,学生模型就永远学不全老师的推理——这篇的出发点就这一句。现有 LLM-as-Enhancer 要么只做 target-agnostic 先验(稳定但指导不了当前决策),要么只做 target-conditioned 后验(细粒度但容易靠 target 抄近路),P3Rec 干脆把两边一起蒸。
📄 P3Rec: Distilling Prior–Posterior Preference Reasoning for LLM-based Recommendation
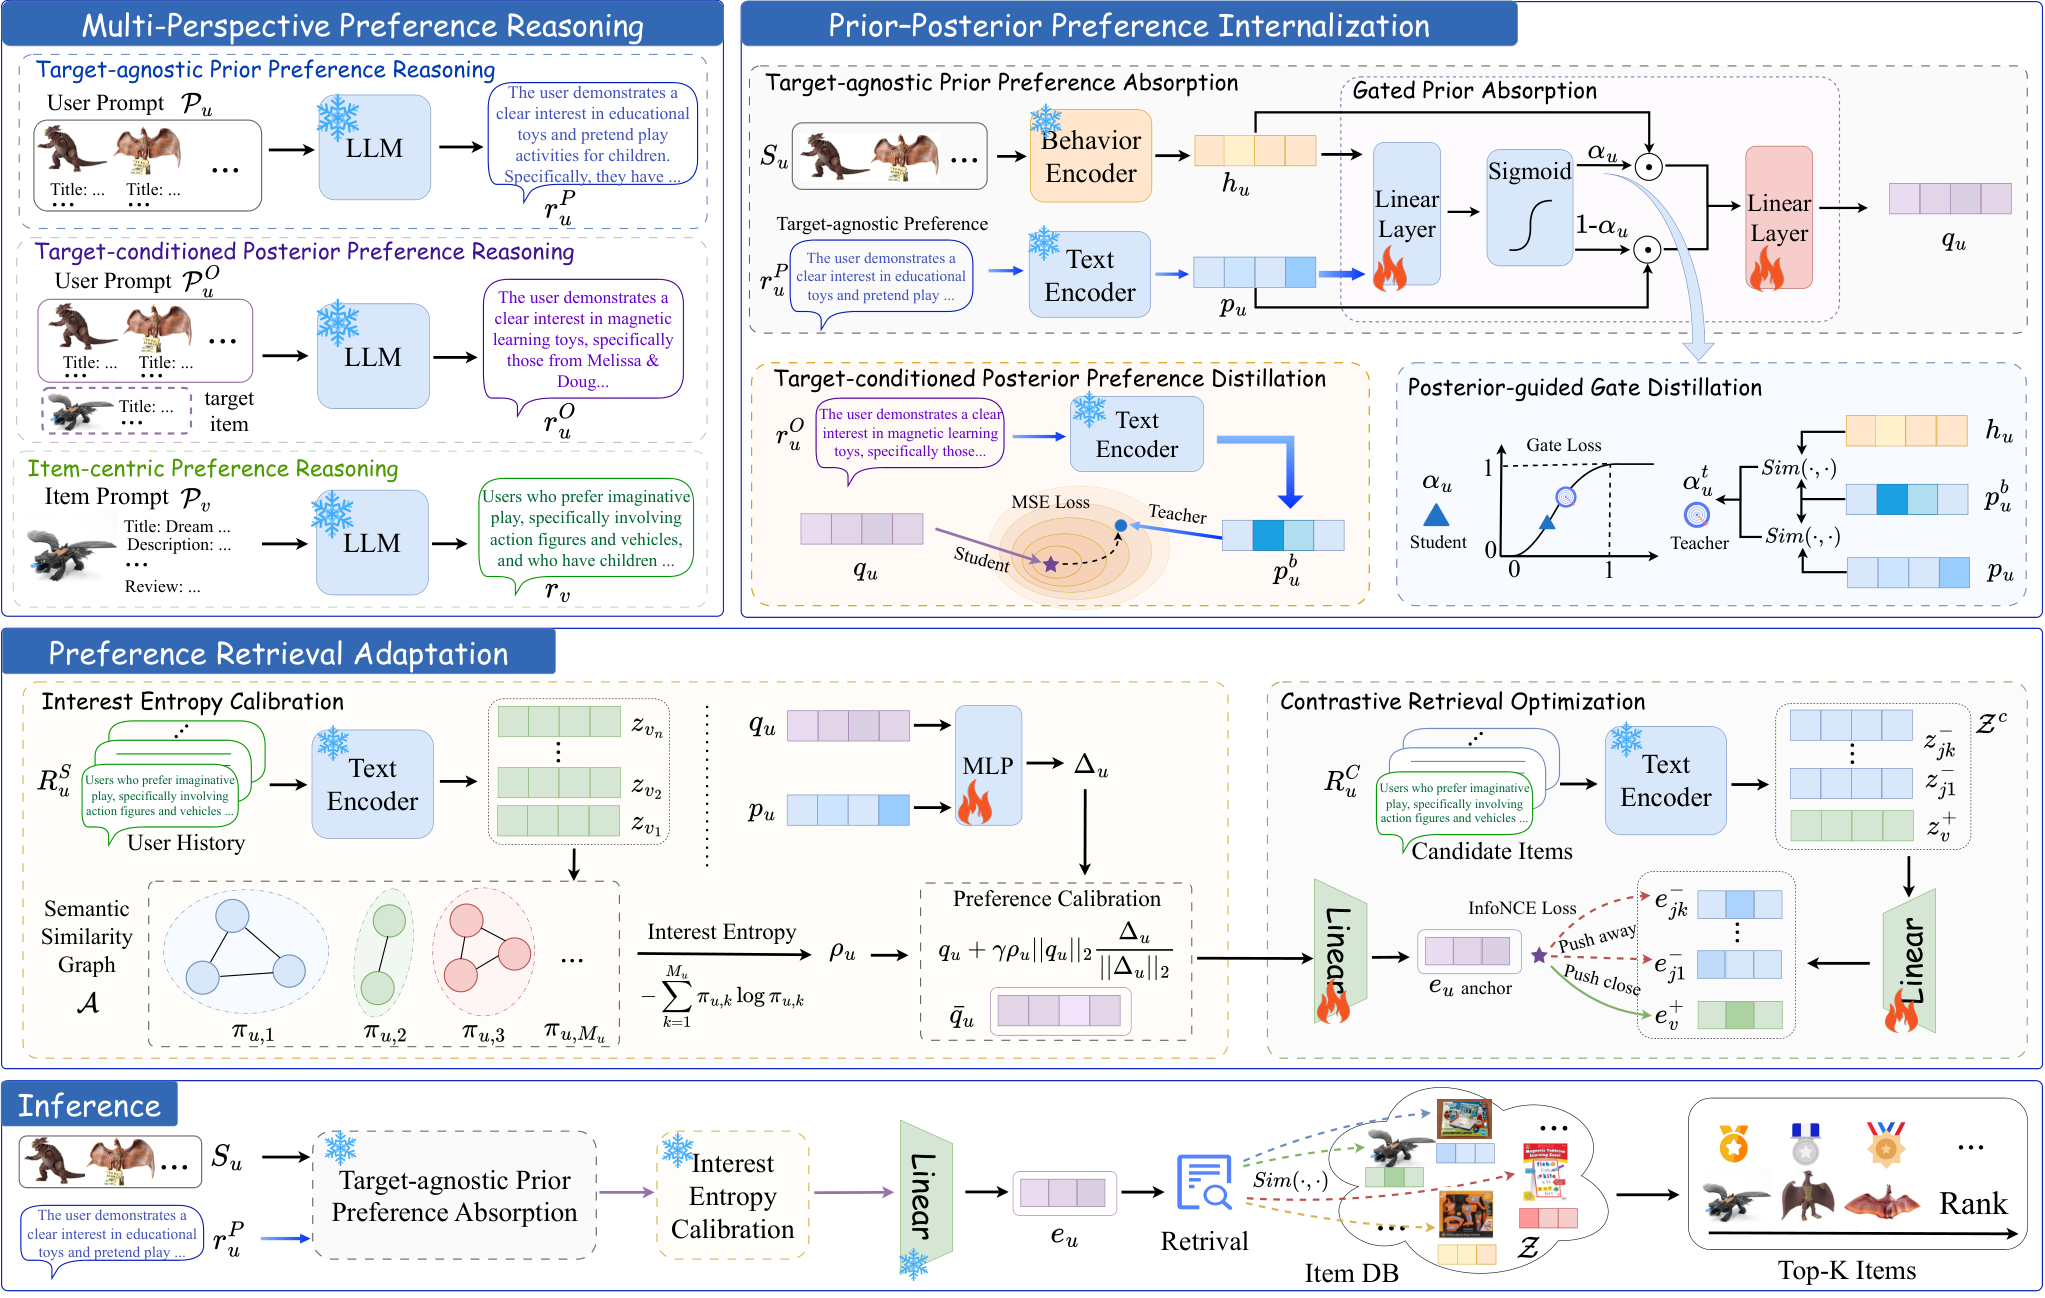
🔧 多视角偏好推理:用户侧同时抽 target-agnostic 先验和 target-conditioned 后验,再从 item 语义加前驱交互里抽 item 侧偏好表示,补上物品端视角。
🧩 渐进式内化:先从行为表征里选择性吸收先验,再用后验去指导这个吸收过程,最后把 target 相关的偏好蒸进用户表征,让行为和偏好知识同时保留。
⚙️ 兴趣熵校准:综合表征不一定指向一个明确的检索方向,历史兴趣越分散越明显;论文用 interest entropy 刻画分散度,自适应控制一个可学习残差来校准用户表示,再做对比检索优化。
📊 多个公开数据集上一致超过现有 SOTA,对比的基线覆盖 RLMRec、LLM-ESR、R2END 这类 LLM-as-Enhancer 路线。
📈 全程离线蒸馏,线上依然是轻量推荐器,不引入在线 LLM 推理开销,这点对落地比涨点更关键。
✅ 我看到的版本实验表格被截断,具体提升幅度没法写死;读的时候先盯 NDCG@10、HR@10,以及和 R2END 的逐数据集差值。
总结感想:做 LLM-as-Enhancer 和蒸馏方向的同学可以直接跟。要留意的坑有两个,一是后验偏好用到了 ground-truth next item,训练时很容易退化成 target shortcut,得看消融能不能证明它不是在泄露标签;二是 interest entropy 的校准到底贡献多少,复现时建议单独关掉这一路验证。如果只挑一个指标看,先看长尾和兴趣分散用户切片上的 NDCG。
原文:AlphaXiv