小红书精读:A Real-Calibrated Synthetic-First Data Engine
📉用合成数据做增强,实测反转了?
各位算法同学们,先说结论:在低数据姿态估计里,把生成式合成图直接灌进训练集,效果不一定正向;但配一小批真实锚点一起训,性能确实能涨。这篇工作没有造新模型,而是把“生成+清洗+筛选”做成一条模块化数据流水线,给“什么时候该信合成数据”打了个样。
📄 A Real-Calibrated Synthetic-First Data Engine
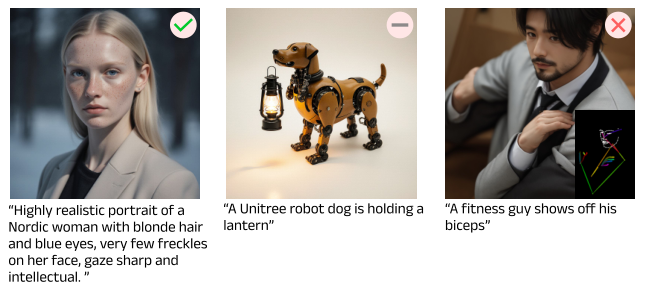
🔧 核心创新是“真实校准的合成优先”数据管线,用少量真实样本当锚点,生成时用可控扩散模型,筛图时再用真实参考集的统计分布来定阈值,而不是简单算样本离真实分布的相似度。 🔧 第二点是两级筛选串联:先用视觉语言模型算语义margin,低于阈值的丢掉;再用YOLO这类结构检测器看边界框覆盖率和关键点置信度,结构不对的也丢。主打高召回,不是一刀切。 🔧 第三点是工程上做成CLI模块化pipeline,生成、筛选、选择、验证都能单独替换,还留了human-in-the-loop接口,但作者明确说这些可选模块没做实验验证,不吹。
📊 在280张真实测试集上,real-only训练mAP@0.5=0.746,mAP@0.5:0.95=0.389;加上479张未筛选合成图后,mAP@0.5涨到0.761,mAP@0.5:0.95涨到0.411。 📈 但纯合成训练就很拉跨:raw合成图只有0.449 mAP@0.5,经过curation的合成图反而降到0.430,差距明显。 ✅ 注意,混合条件用了1589张real+479张synthetic,和real-only不是同预算、同种子的严格对比;论文自己也承认curation在当前规模下没有任何可测量的增益。
总结:这篇的价值在于给了个可复现的负面结果和条件边界——想证明curation有效,必须匹配数量、多seed、还要控制更新步数。对做低数据CV的同学,建议盯住混合训练的方向性收益,别急着上复杂筛选,先跑通“真实锚点+生成池”这个基线再说。
原文:AlphaXiv