小红书精读:SelfDR: Self-Distillation from Reasoning for LLM-Based Recommendation
推理贵?蒸馏一下,推荐不推理还更强
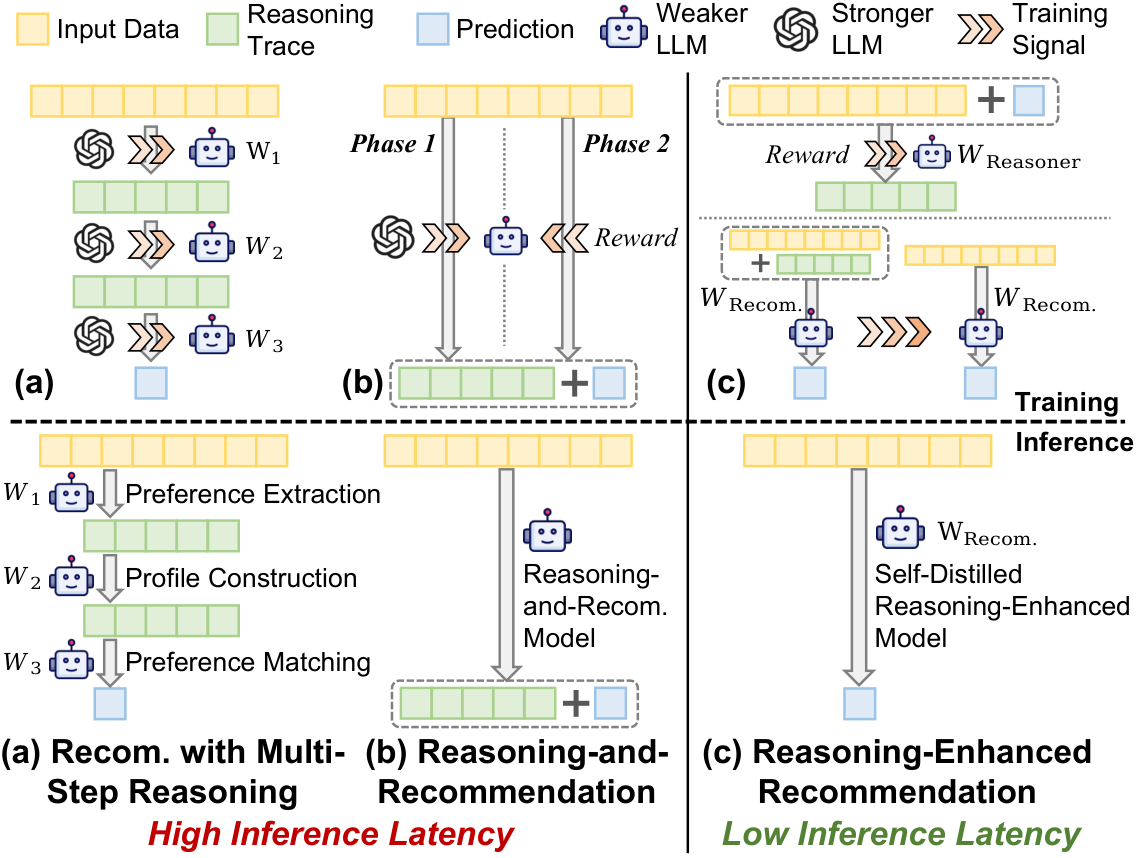
各位算法同学们,带推理的LLM推荐效果好但延迟高到没法上线?SelfDR的思路是:让模型给自己当老师,把推理能力蒸馏成直接推荐,这样推理时零额外开销,效果还不掉。清华和美团做的,代码也开源了,可以跟。
📄 SelfDR: Self-Distillation from Reasoning for LLM-Based Recommendation
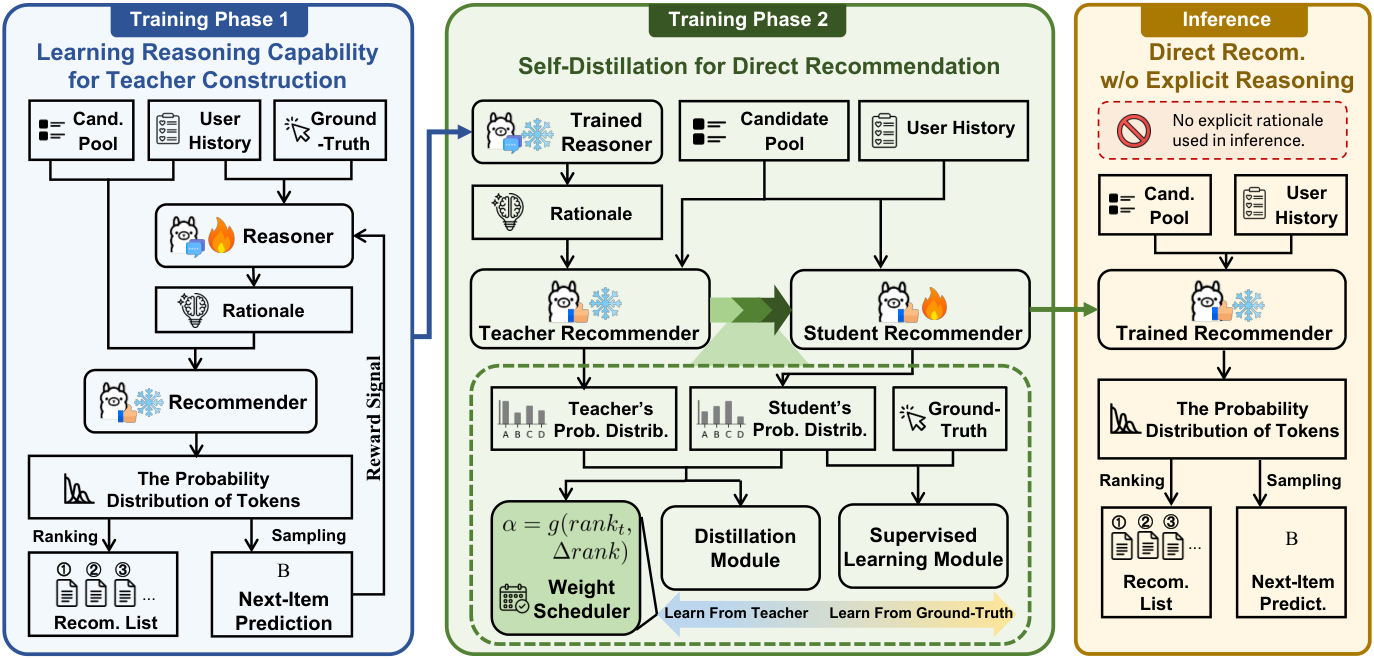
🔧 先训练一个带reasoner的teacher:reasoner用推荐效果当reward,生成高质量的rationale,再拼到输入里让teacher做推荐; 🔧 student和teacher共享同一个基座LLM,直接出推荐结果,不生成任何中间推理token; 🔧 蒸馏时用动态权重,根据样本和teacher置信度调节学习强度,比固定权重更像“会挑重点学”。
📊 在3个公开数据集上,SelfDR都拿到最优推荐效果,同时推理成本最低; ✅ 推理阶段额外生成的rationale token数为0,延迟和直接推荐几乎一样; 📈 全流程外部模型依赖数为0,teacher、student、reasoner都是同一个LLM,不用求更强模型。
总结:这个思路对线上推荐系统很实用,想跟的同学盯两个点:一是蒸馏后学生相对teacher有没有明显掉点,二是动态权重在不同数据分布下是否稳。代码链接在论文里,先跑通再谈复现。
原文:AlphaXiv