小红书精读:Semantic Trimming and Auxiliary Multi-step Prediction for Generative Recommendation
✂️剪掉冗余token,推荐提速1.38倍
各位算法同学们,生成式推荐里,SID序列越长,训练越慢、效果还容易抖,问题可能就出在冗余token上。这篇浙大和阿里的工作直接把冗余token剪掉,再补一个多步预测,结果训练提速最高1.38倍,显存最高降54.7%,效果还稳住了。
📄 Semantic Trimming and Auxiliary Multi-step Prediction for Generative Recommendation
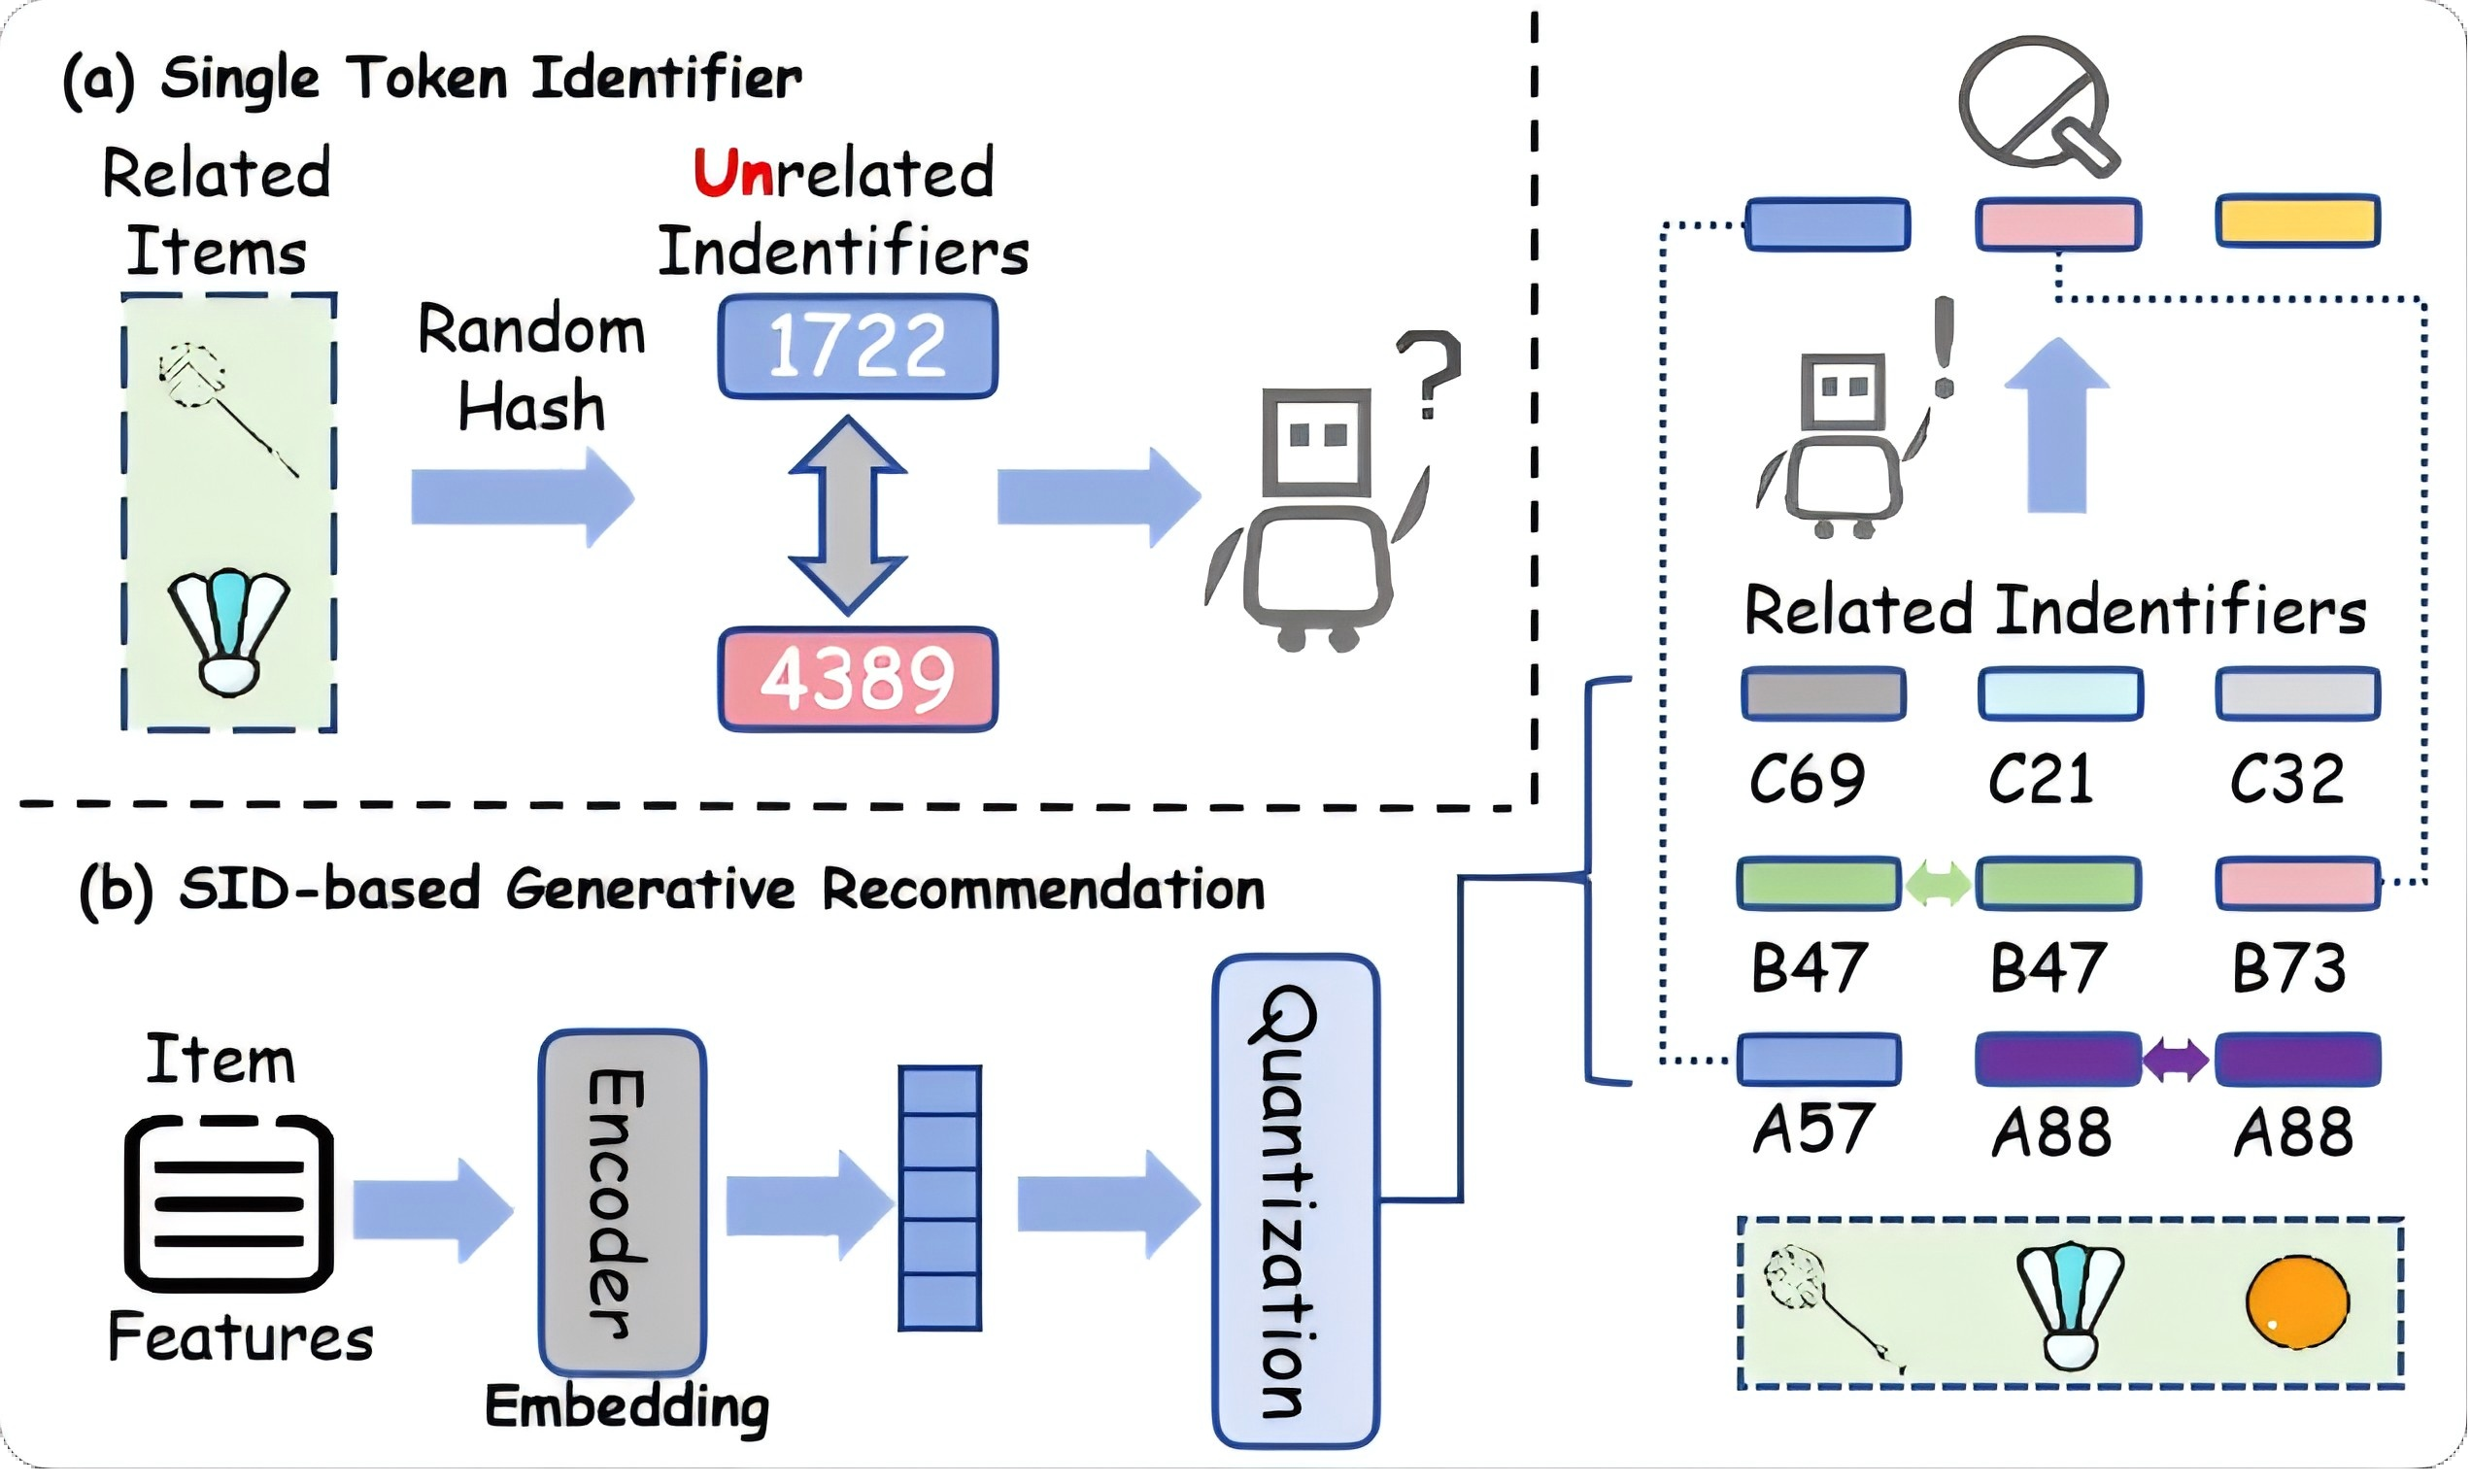
🔧 提出“语义稀释效应”:SID把物品拆成多个token,但很多token对最终推荐是冗余的,既浪费计算又稀释本就很稀疏的监督信号。 ✂️ 输入侧用语义自适应剪枝(SAP):在前向过程中根据语义特征和注意力中心度动态判断token重要性,把噪声序列压成紧凑表示,不靠静态规则。 🎯 输出侧用多步辅助预测(MAP):除了常规next-token,还构造多token目标,把稀疏的监督信号变密,增强长程依赖建模,弥补输入被压缩后的信息损失。
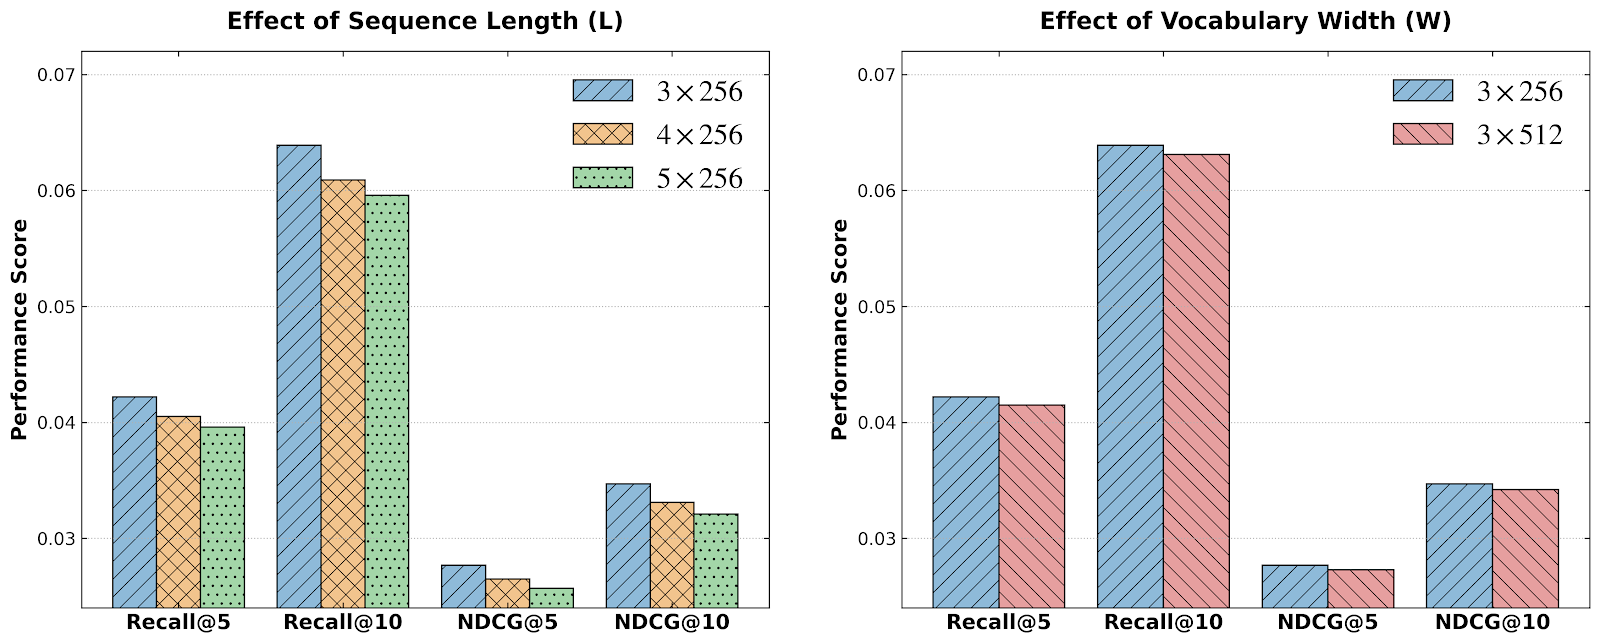
📊 在Amazon公开数据集和工业级AL-GR-Tiny上,STAMP在多架构(T5和Qwen)下训练速度提升1.23–1.38倍。 📈 显存占用降低17.2%–54.7%,其中更大序列上省得更多。 ✅ 与那些激进压缩的基线不同,STAMP在保持或提升推荐精度的前提下拿到这个提速,没有用效果换速度。
个人判断是:这思路对做SID类生成式推荐的团队非常实用,尤其当你的序列长度被RQ-VAE拉得很长的时候。落地时要小心SAP的动态剪枝会不会影响训练稳定性,建议先在小数据集上验证剪枝比例和MAP的配合;另外论文实验用T5和Qwen做代表,换其他底座可能还要再调。
原文:AlphaXiv