推荐算法日报 · 2026-11-07
总览
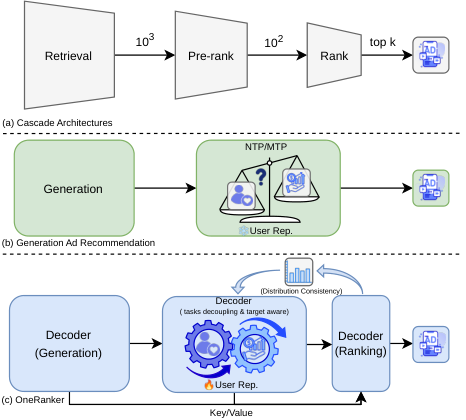
今天这批整体偏薄,真正能拿上台面细讲的其实就一篇来自工业界广告推荐的论文,不过质量在线,值得花时间。它要解决的是生成式推荐里生成和排序各自为政的老问题:把任务 token 和 fake item token 拼成 query,用一个先 cross 再 self 的异构 decoder 把生成侧的多兴趣表示再加工一遍,最后用一层轻量 R-Decoder 在固定候选上做 pairwise eCPM 排序,再通过蒸馏把排序偏好回传给生成侧,整个训练闭环设计得比较干净。我最认可的是它把亮点落在架构解耦上,而不是在“有没有加价值目标”上,因为它的 baseline 本身已经注入过价值信号,只有按这个对比口径比较,才能把结论讲清楚。不过也要泼点冷水:离线那个 HR@1 相对提升 +44.7% 是在固定的 30 个候选上做打分排序得到的,不涉及全库生成召回,因此不能直接外推成线上收益;线上也只报了 5% 流量首阶段的 GMV-Normal +1.34%,延迟吞吐、DC 损失单独贡献多少这类工程侧关键数据则全都没有。读的时候更适合把它当成“生成排序一体化该怎么搭骨架”的参考,而不是效果标杆。今天优先看这一篇,重点看它的训练闭环和评测口径,别被那几个大百分比带跑。
论文列表
1. OneRanker: Unified Generation and Ranking with One Model in Industrial Advertising Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-11-05 09:01 UTC
- 机构:Tencent Inc.
- 工业优先级:中
🧩腾讯广告把生成和排序塞进一个模型
各位算法同学们,生成式推荐喊了两年,真正的瓶颈从来不是生成质量,是生成阶段压根不知道 eCPM 长什么样——高价值候选在 top-k 那一步就被悄悄筛掉了,后面的排序模型再强也救不回来。这篇腾讯的工作把生成和排序放进同一个模型,给了一个工程上能跑的答案。
📄 OneRanker: Unified Generation and Ranking with One Model in Industrial Advertising Recommendation
🔧 价值感知的多任务解耦:保留 MTP 的多兴趣头保覆盖广度,另开一个 value-aware 头专门学商业价值;两者共享底层用户表示,但用独立 task token 隔开输出空间,不让 eCPM 信号把兴趣建模挤死。再叠加“曝光→点击→转化→价值”的任务序先验和 causal mask,让高层价值任务顺着因果链吸收低层兴趣知识。
🧩 由粗到细的目标感知:用全量 item 空间 K-means 聚出的 Fake Item Tokens 做粗粒度隐式感知,配双通道表示(语义匹配 + 目标感知)在内积检索时自然融合;排序 decoder 再做候选级 cross-attention,做细粒度的价值对齐。
⚙️ 双侧一致性保证:输入侧,排序 decoder 的 Key/Value 直接透传生成侧表示,排序决策继承生成过程的信息;输出侧,用 Distribution Consistency loss 把 ranker 的价值信号当软标签回灌给 generator,总损失就是 MTP + rank + DC 三项联合优化。
📊 已在腾讯微信视频号广告系统全量部署,首轮 5% 流量灰度阶段 GMV-Normal +1.34%。
📈 这个数字是线上大盘业务指标,并非离线指标,在广告系统里含金量比离线涨点高得多。
✅ 论文的核心结论是:不选单阶段融合(优化打架),也不选阶段解耦(信息不可逆丢失),而是“共享表示、隔离输出空间”,靠 KV 透传和 DC 软标签把两端接上。
做生成式召回、排序统一架构的同学可以跟进,但盯指标别只看离线 top-k 命中,要看线上 eCPM 和 CTR 是否同向涨;坑在于任务 token 和 causal mask 强依赖你自家漏斗顺序的定义,换业务场景基本要重排任务链,DC loss 的权重也得重调。和 GPR、GRank 相比,它更像是把“解耦 + 透传”写成了一套可复用的架构范式,而非又一个 trick。