推荐算法日报 · 2026-09-06
总览
今天这批稿子整体不是那种刷榜刷到爆的“大新闻”,但胜在几条线都比较务实,值得翻一翻。最打动我的是清华和美团的这篇《SelfDR》,它把“推荐任务自己训的reasoner比外部大模型更管用”这个点讲得很透,而且直接解决了LLM推荐线上推理太贵的老大难问题,工程上几乎可以拿来就试。另一条有意思的线是《HypRQ-VAE》,用双曲空间做semantic ID,对长尾item的改善在离线数据上很扎实,说明索引层的改进还是有空间。相比之下,《TC-RAG》那种图灵完备的形式化证明虽然炫,但对业务落地来说更多是理论价值,真要部署得掂量一下状态阈值和token开销;《RobustSeiz》和那篇合成数据引擎则更像基础设施建设或踩坑复盘,前者适合医疗AI团队参考,后者读下来能帮你少交点“合成数据能包治百病”的学费。今天最建议优先精读SelfDR,其次可以扫一眼HypRQ-VAE,其他按需取用就行。
论文列表
1. SelfDR: Self-Distillation from Reasoning for LLM-Based Recommendation
- 论文链接:AlphaXiv
- 更新时间:2026-09-03 03:05 UTC
- 机构:DCST, Tsinghua University,Quan Cheng Laboratory,Meituan
- 工业优先级:强
- 备注:12 pages, 5 figures, CIKM’26
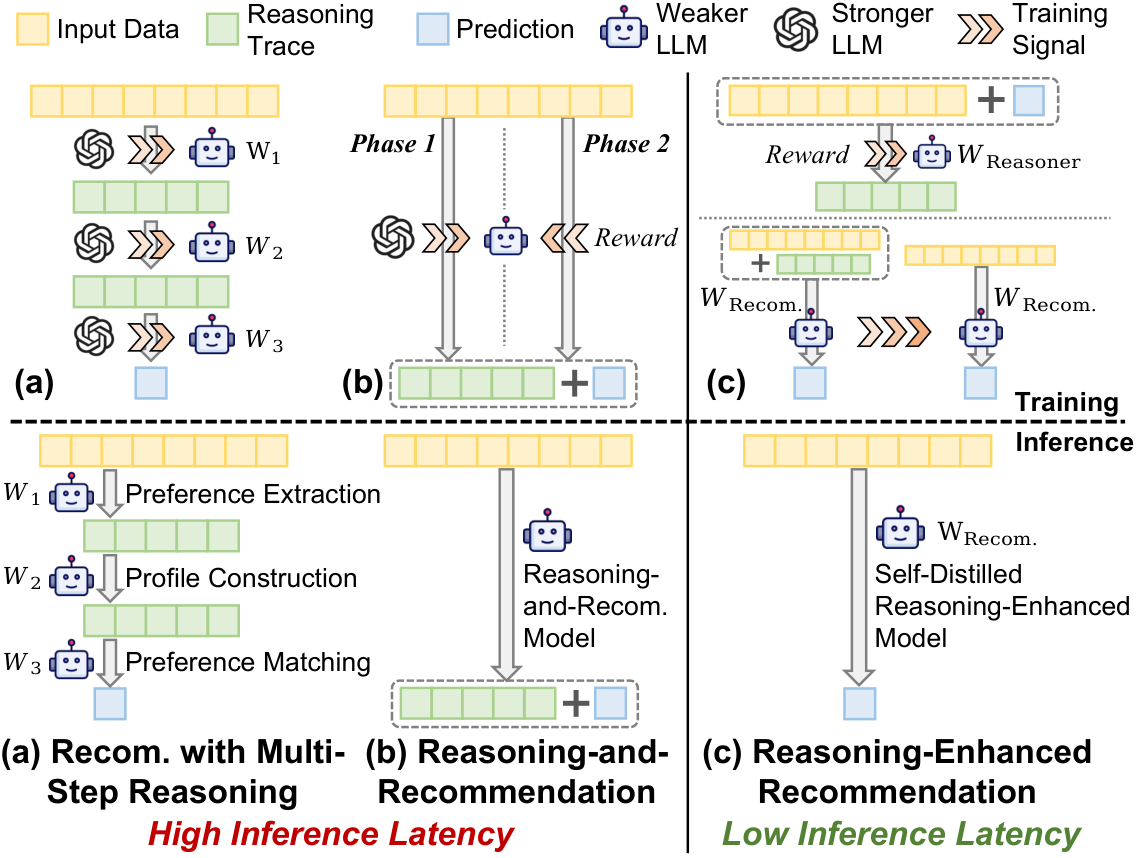
推理贵?蒸馏一下,推荐不推理还更强
各位算法同学们,带推理的LLM推荐效果好但延迟高到没法上线?SelfDR的思路是:让模型给自己当老师,把推理能力蒸馏成直接推荐,这样推理时零额外开销,效果还不掉。清华和美团做的,代码也开源了,可以跟。
📄 SelfDR: Self-Distillation from Reasoning for LLM-Based Recommendation
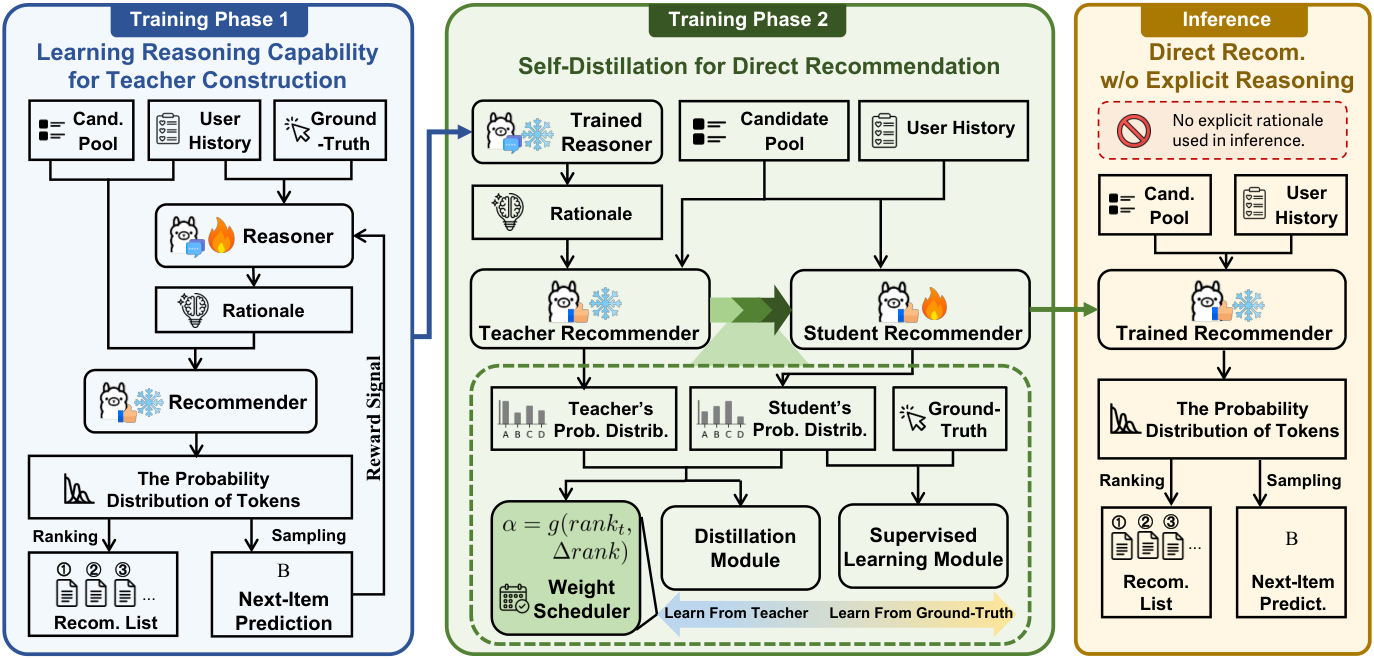
🔧 先训练一个带reasoner的teacher:reasoner用推荐效果当reward,生成高质量的rationale,再拼到输入里让teacher做推荐; 🔧 student和teacher共享同一个基座LLM,直接出推荐结果,不生成任何中间推理token; 🔧 蒸馏时用动态权重,根据样本和teacher置信度调节学习强度,比固定权重更像“会挑重点学”。
📊 在3个公开数据集上,SelfDR都拿到最优推荐效果,同时推理成本最低; ✅ 推理阶段额外生成的rationale token数为0,延迟和直接推荐几乎一样; 📈 全流程外部模型依赖数为0,teacher、student、reasoner都是同一个LLM,不用求更强模型。
总结:这个思路对线上推荐系统很实用,想跟的同学盯两个点:一是蒸馏后学生相对teacher有没有明显掉点,二是动态权重在不同数据分布下是否稳。代码链接在论文里,先跑通再谈复现。
2. TC-RAG:Turing-Complete RAG’s Case study on Medical LLM Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-03 08:38 UTC
- 机构:未披露机构
- 工业优先级:强
- 备注:version 2.0; ACL 2025
检索何时该停?一个图灵完备的RAG
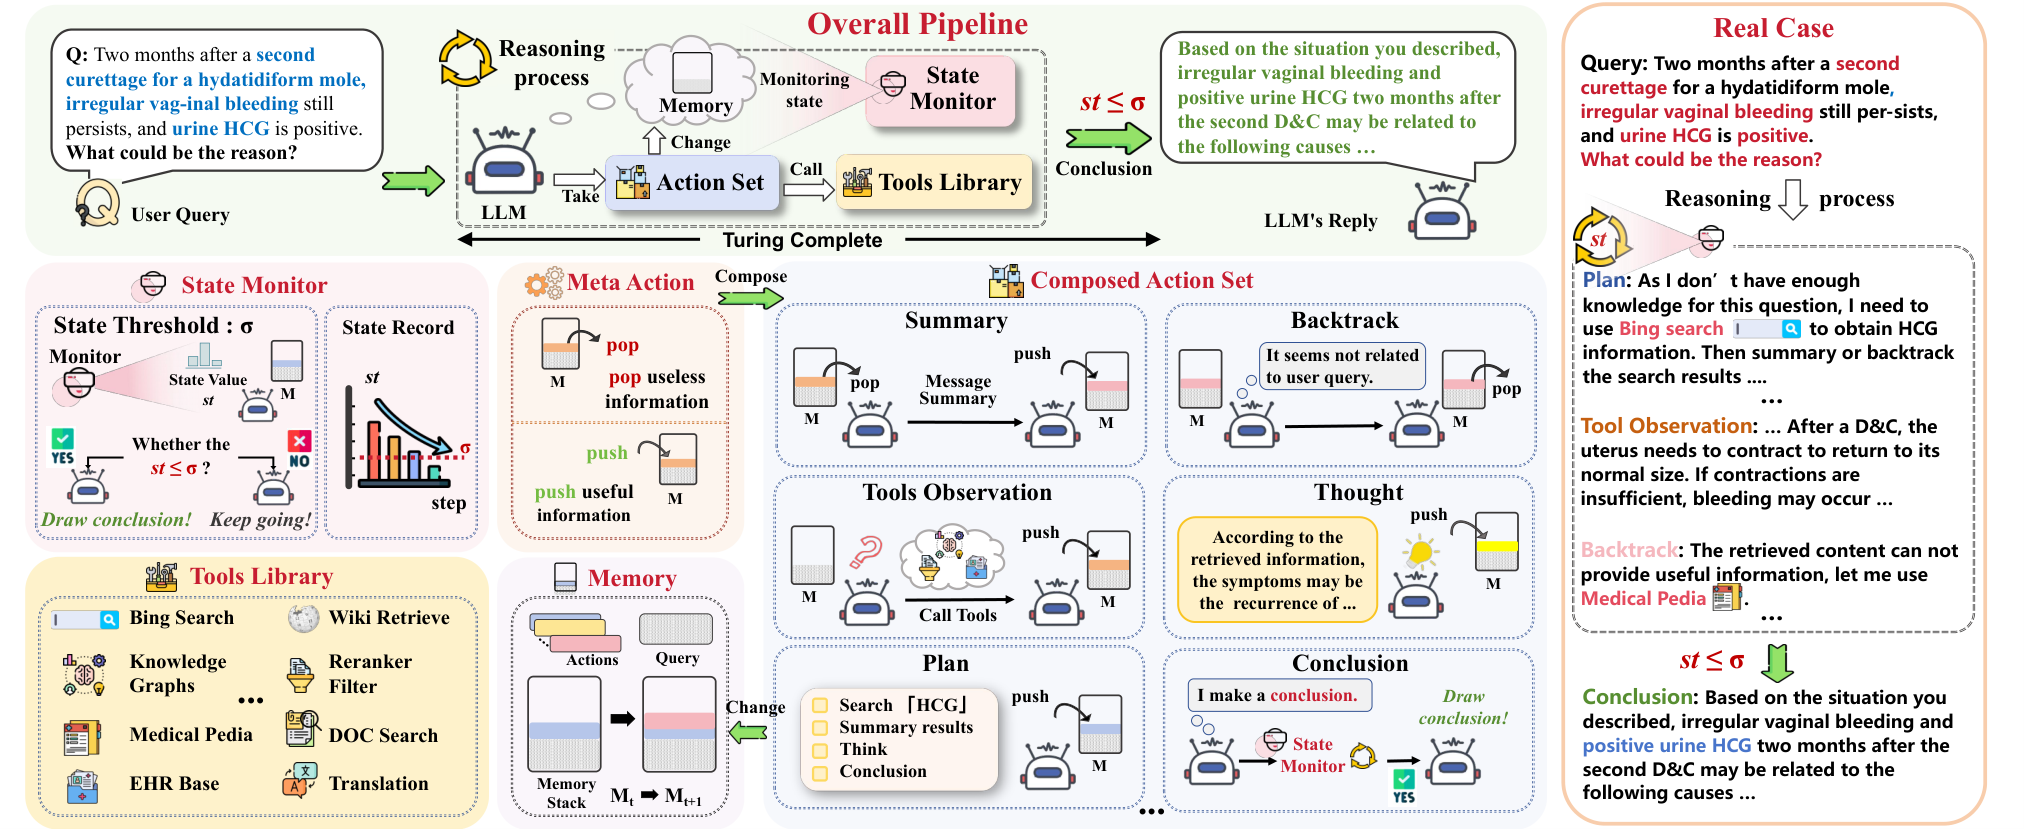
各位算法同学们,RAG不是检索越多越好,现有方案普遍缺一个“状态变量”,导致检索停不下来、无关噪声越滚越多。TC-RAG直接把RAG做成图灵完备系统,用记忆栈主动控制检索,医疗场景准确率提升超过7.20%。
📄 TC-RAG: Turing-Complete RAG’s Case study on Medical LLM Systems
🔧 创新之一是引入系统状态变量,把RAG建模成白盒图灵机,理论上证明检索可以“受控停机”,避免无限检索和状态发散。 🧩 创新之二是设计记忆栈,用Push/Pop、回溯和摘要操作动态管理已检索知识,模型能根据自己已经知道多少决定要不要继续搜。 ⚙️ 创新之三是自研医疗域LLM和规划机制,让系统像医生一样先评估再动手,配合栈操作及时弹出错误信息,防止错误知识累积。
📊 在七个真实医疗和通用问答数据集上,TC-RAG比现有RAG方法准确率提升超过7.20%。 ✅ 和自适应RAG、DRAGIN等相比,TC-RAG有显式停机信号,收敛行为更可控。 📈 已开源中文医疗预训练数据集和知识图谱,代码仓库见论文,方便复现细节。
总结:这套思路对做医疗问答和RAG智能体的算法同学有直接参考价值,核心要看它“状态变量”怎么算、栈操作怎么和LLM推理耦合。落地坑在于依赖白盒模型状态,闭源API场景下没法直接抄,且栈机制会增加额外推理开销,上生产前要卡好延迟预算。
3. HypRQ-VAE: Hyperbolic Item Indexing for Long-Tail-Aware Generative Recommender Systems
- 论文链接:AlphaXiv
- 更新时间:2026-09-03 04:56 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:Accepted for publication in the 2026 IEEE International Conference on Data Mining (ICDM 2026)
长尾推荐新解法:双曲空间生成索引
各位算法同学们,生成式推荐一直有个尴尬:LLM只认文本token,推荐系统却依赖离散item ID,两者硬凑经常出现幻觉。今天这篇工作把item索引搬进了双曲空间,直接瞄准长尾物品推荐,实验显示对尾部item的提升相当明显。
📄 HypRQ-VAE: Hyperbolic Item Indexing for Long-Tail-Aware Generative Recommender Systems
🔧 核心创新是把RQ-VAE的残差量化过程从欧氏空间搬到庞加莱球,用指数映射和对数映射让item的表征在双曲空间里完成离散编码。 🧩 双曲空间体积随半径指数增长,天然契合用户-物品交互的幂律分布,给了稀疏长尾物品更多可区分的表示容量,而不是像欧氏空间那样被头部物品挤压。 ⚙️ 他们还分析了语义token本身也是长尾的,双曲层次结构既能保留文本语义又能让尾部物品的编码不那么容易被混淆,算是对症下药。
📊 在Amazon Instruments、Arts和MovieLens三个数据集上,用标准序列模型对比多种索引策略,HypRQ-VAE在整体推荐指标上超过欧氏RQ-VAE基线。 📈 按帕累托原则划分头尾(top 20% head,bottom 80% tail),长尾物品的推荐提升尤其显著,说是“substantially more capacity”给到tail items,具体数字可以去看论文里的表。 ✅ 分析实验显示,双曲空间学到的item层次结构更清晰,尤其对低频、语义独特的物品,能有效降低生成式推荐的幻觉概率。
如果你在搞生成式推荐或者语义ID这套东西,这篇值得对比一下欧氏和双曲的索引差异。不过注意,双曲空间计算比欧氏麻烦,工程化要评估耗时;另外论文里没有披露大规模线上场景,所以落地时别只盯着离线涨点,还得看线上延迟和稳定性。
4. RobustSeiz: An Open-Source Framework for Benchmarking the Robustness of EEG Seizure Detection Models
- 论文链接:AlphaXiv
- 更新时间:2026-09-03 15:45 UTC
- 机构:未披露机构
- 工业优先级:中
- 备注:28 pages, 13 numbered figures, 9 tables; full-page graphical abstract and supplementary material included. Submitted to the Journal of the American Medical Informatics Association (JAMIA)
癫痫检测模型,一遇噪声就现原形
各位算法同学们,你在干净数据上跑得飞快的癫痫检测模型,遇到真实EEG里的噪声、电极故障,可能漏掉发作还狂报警。这篇提出一个开源压测框架RobustSeiz,专门在部署前用临床向扰动把模型底细摸清楚。
📄 RobustSeiz: An Open-Source Framework for Benchmarking the Robustness of EEG Seizure Detection Models
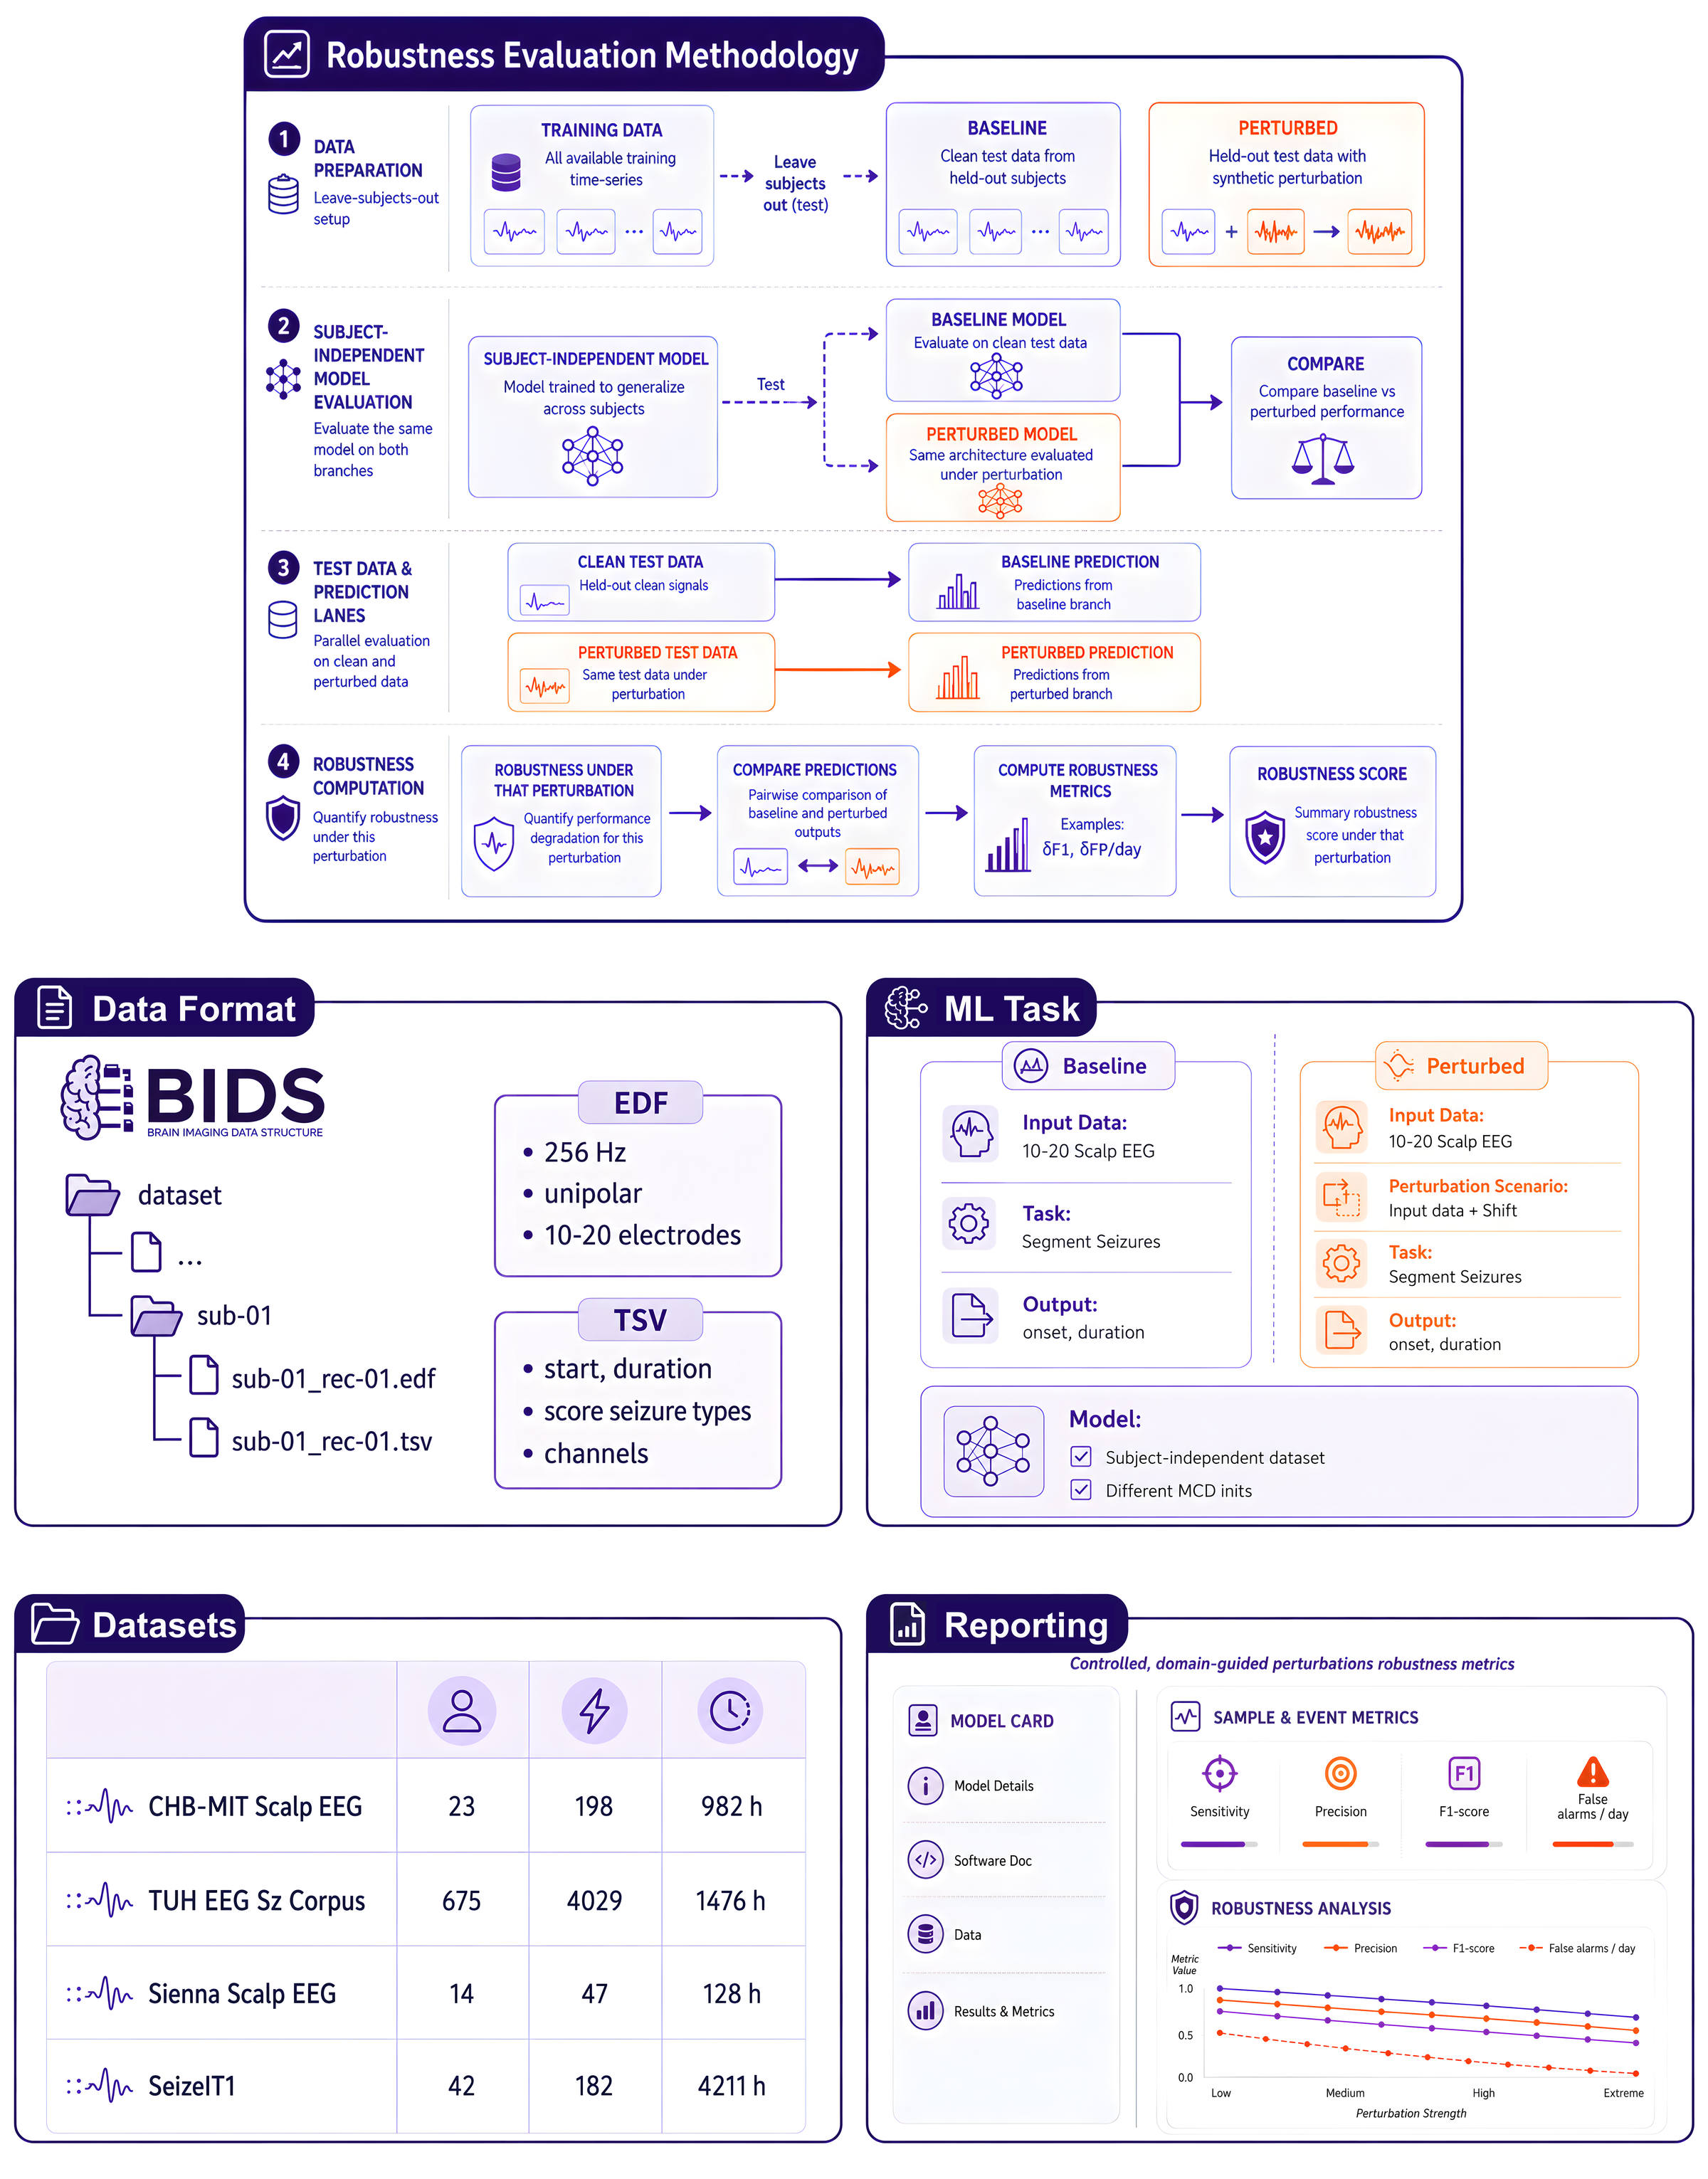
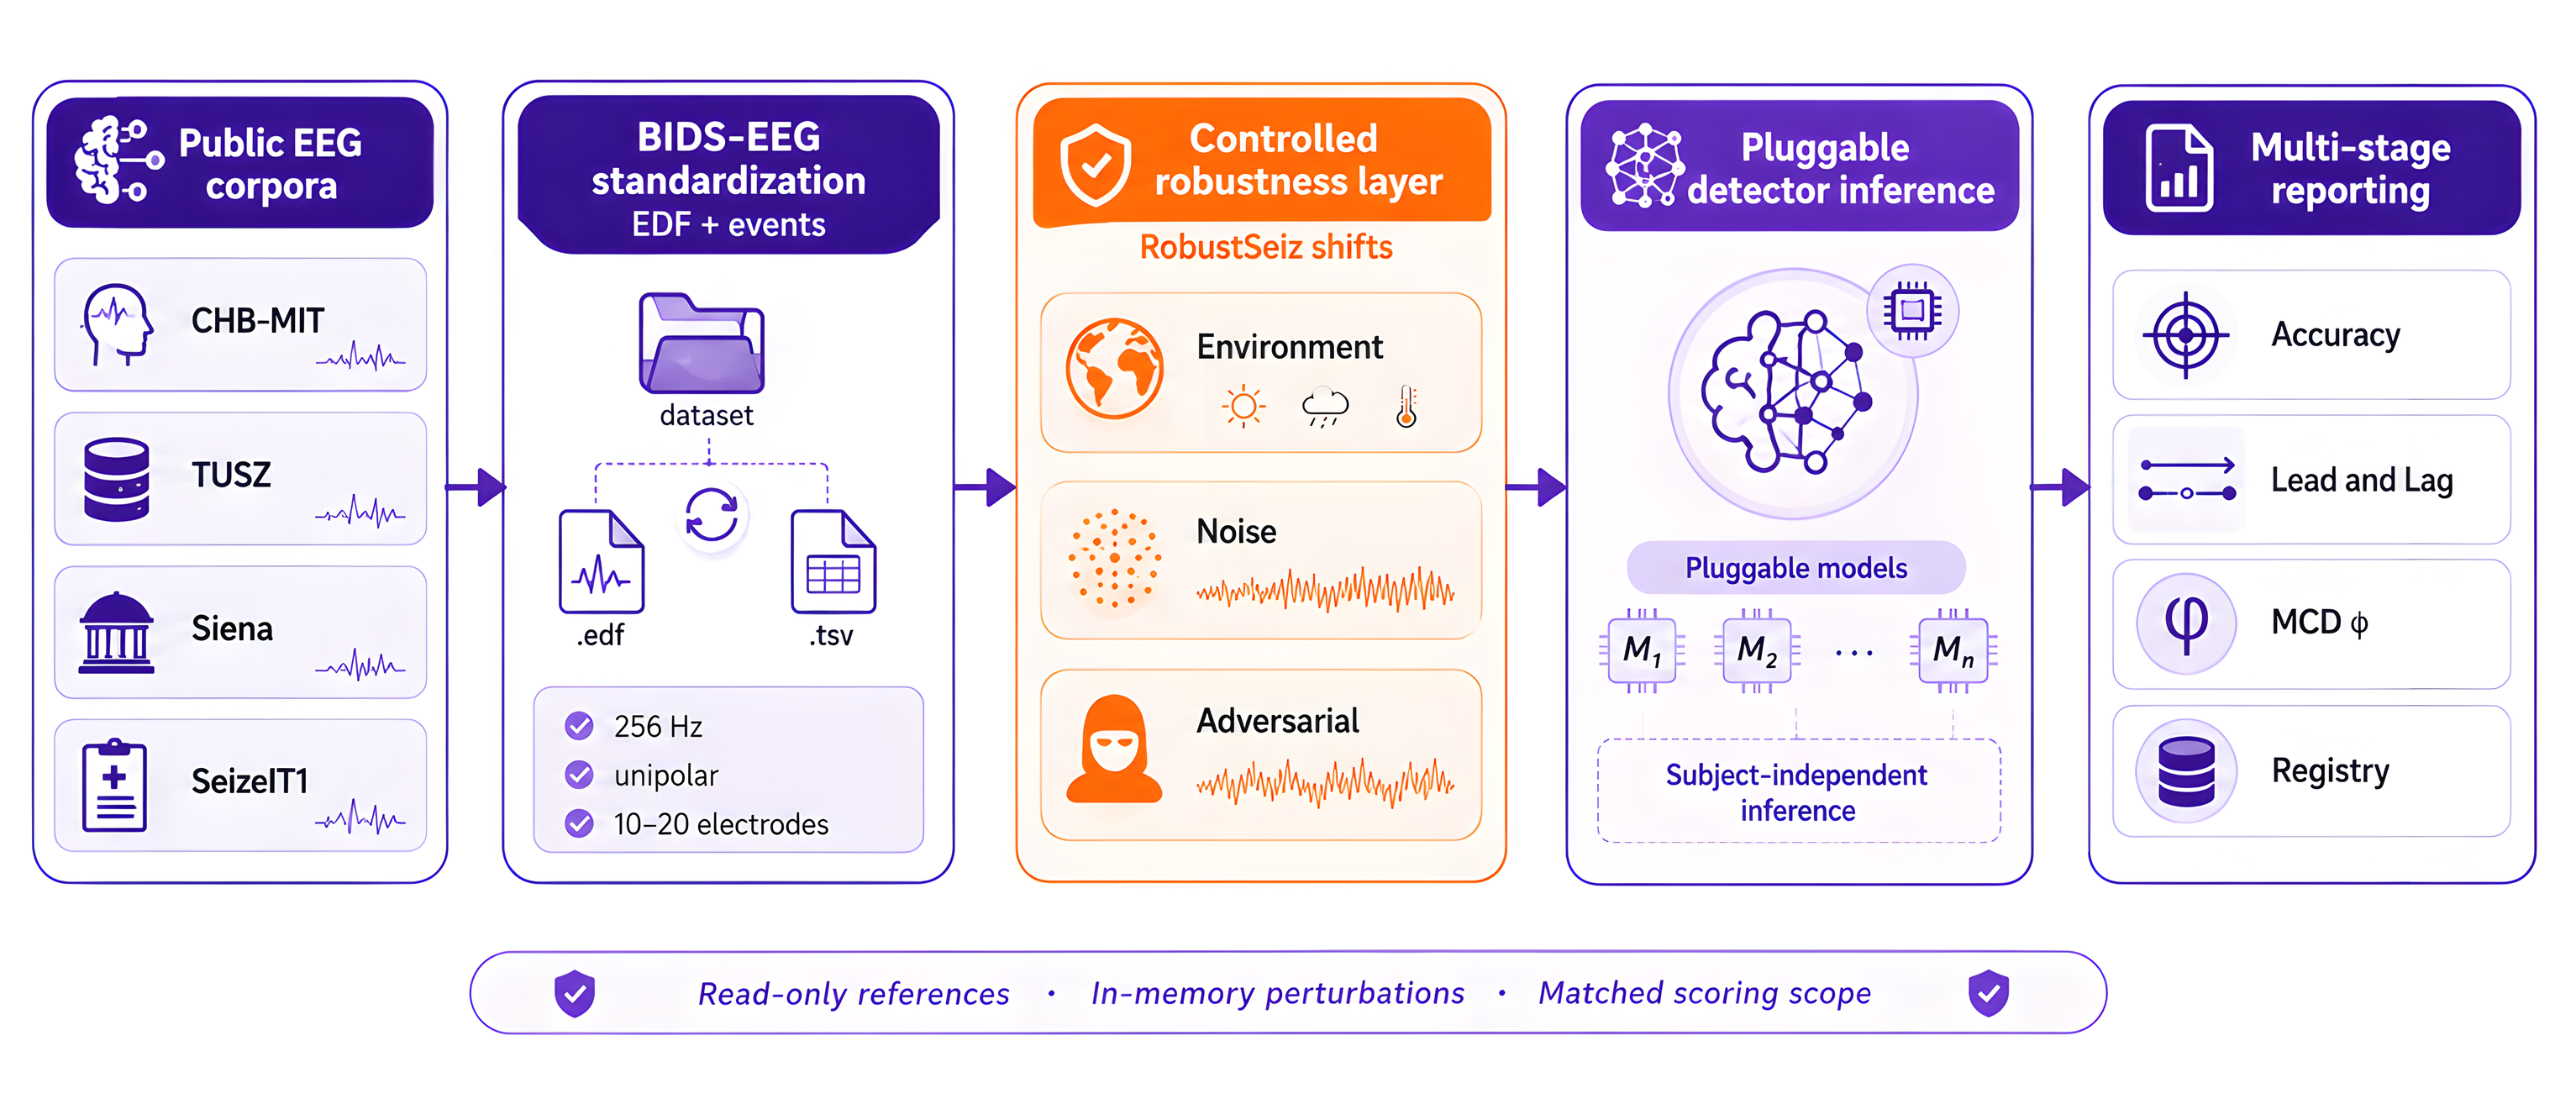
🔧 统一输入口径:把CHB-MIT、TUSZ、Siena、SeizeIT1四个公共EEG语料标准化成BIDS-EEG格式,统一重采样到256Hz、统一10-20系统单极导联(CHB-MIT保留原始双极),模型看到的特征是同一世界。 🧩 构建扰动taxonomy:环境、噪声、对抗三大类,每类带超参网格,推理时直接在内存中施加,不动原始标注,保证打分公平。 ⚙️ 评估维度丰富:从sample和event两个层级看敏感性、精确率、F1,还统计每24h假阳性数、Lead/Lag起病时间偏差、MC dropout一致性,不放过临床最关心的会不会漏报、乱报、报得晚。
📊 数据集规模差异挺大:TUSZ有675人、约1476小时,CHB-MIT只有23人982小时,Siena才14人128小时,SeizeIT1则是42人4211小时。 📈 演示实验在TUSZ全扰动网格上评估了一个当代检测器,每种扰动都跟无扰动基线对比,输出全套指标曲线。 ✅ AWGN那一组代表性分析直接展示了扰动强度怎么改变检测质量、起病时间偏移和预测一致性——说明模型对噪声不是全有全无,而是连续退化。
我觉得对做EEG检测、医疗AI部署的同学很有用,尤其要盯每24h假阳率和onset timing,这俩直接决定临床上是漏掉发作还是被警报淹没。落地时注意各个数据集导联配置和标准化工程不轻松,不过官方给了Docker镜像,能少踩不少环境坑。
5. A Real-Calibrated Synthetic-First Data Engine
- 论文链接:AlphaXiv
- 更新时间:2026-09-03 14:03 UTC
- 机构:未披露机构
- 工业优先级:弱
- 备注:16 pages, 5 figures
📉用合成数据做增强,实测反转了?
各位算法同学们,先说结论:在低数据姿态估计里,把生成式合成图直接灌进训练集,效果不一定正向;但配一小批真实锚点一起训,性能确实能涨。这篇工作没有造新模型,而是把“生成+清洗+筛选”做成一条模块化数据流水线,给“什么时候该信合成数据”打了个样。
📄 A Real-Calibrated Synthetic-First Data Engine
🔧 核心创新是“真实校准的合成优先”数据管线,用少量真实样本当锚点,生成时用可控扩散模型,筛图时再用真实参考集的统计分布来定阈值,而不是简单算样本离真实分布的相似度。 🔧 第二点是两级筛选串联:先用视觉语言模型算语义margin,低于阈值的丢掉;再用YOLO这类结构检测器看边界框覆盖率和关键点置信度,结构不对的也丢。主打高召回,不是一刀切。 🔧 第三点是工程上做成CLI模块化pipeline,生成、筛选、选择、验证都能单独替换,还留了human-in-the-loop接口,但作者明确说这些可选模块没做实验验证,不吹。
📊 在280张真实测试集上,real-only训练mAP@0.5=0.746,mAP@0.5:0.95=0.389;加上479张未筛选合成图后,mAP@0.5涨到0.761,mAP@0.5:0.95涨到0.411。 📈 但纯合成训练就很拉跨:raw合成图只有0.449 mAP@0.5,经过curation的合成图反而降到0.430,差距明显。 ✅ 注意,混合条件用了1589张real+479张synthetic,和real-only不是同预算、同种子的严格对比;论文自己也承认curation在当前规模下没有任何可测量的增益。
总结:这篇的价值在于给了个可复现的负面结果和条件边界——想证明curation有效,必须匹配数量、多seed、还要控制更新步数。对做低数据CV的同学,建议盯住混合训练的方向性收益,别急着上复杂筛选,先跑通“真实锚点+生成池”这个基线再说。